import pandas as pd
import numpy as np
from matplotlib import pyplot as plt
import statsmodels.formula.api as smf
from toolz import *부록 D: 예측 지표가 인과 모델에 위험한 이유
자주 듣는 오해가 하나 있습니다. 무작위 데이터가 있다면, 인과 모델을 평가할 때 그 데이터셋에서 \(R^2\) 같은 지표로 모델의 예측 성능만 재면 된다는 생각입니다. 안타깝게도 일이 그렇게 간단하지는 않습니다. 왜 그런지 설명해 보겠습니다.
일반적으로 어떤 결과든 처치와 공변량의 함수라고 할 수 있습니다.
\[ Y = F(x, t) \]
이 함수를 서로 더해지는 두 부분으로 나눌 수 있다고 해 봅시다. 한 부분은 처치와 무관하고, 다른 부분은 처치와 (있다면) 그 상호작용에만 의존합니다.
\[ Y = g(x) + f(t,x) \]
이런 덧셈 구조가 함수 형태를 어느 정도 제약하기는 하지만, 그 제약이 크지는 않습니다. 그래서 데이터 생성 과정(Data Generating Process, DGP)을 꽤 일반적으로 표현하는 방식이라고 볼 수 있습니다.
핵심은 처치효과가 공변량의 효과보다 약하면, 무작위 데이터가 있더라도 예측력은 더 높으면서 인과추론에는 형편없는 모델이 나올 수 있다는 점입니다. 그런 모델은 \(f(t,x)\)는 무시하고 \(g(x)\)만 근사하면 됩니다.
다시 말해, 무작위 데이터셋에서 잰 예측 성능이 높다고 해서 인과추론에도 더 나은 모델인 것은 아닙니다.
시뮬레이션 데이터로 이를 확인해 보겠습니다.
데이터 시뮬레이션
아래 DGP에는 예측력은 높지만 처치와 상호작용하지 않는 공변량 \(X\)가 있습니다. 즉, 처치효과의 이질성을 좌우하지 않습니다. 또한 처치를 통해서만 결과에 영향을 주는(교란 요인이 아닌) 특성 \(W\)도 있습니다. 처치 자체의 예측력이 낮으므로 \(W\)도 예측력이 그다지 높지 않습니다.
\[ Y_i = g(X_i) + f(T_i,W_i) + e_i \]
n = 100000
n_features = 20
n_heter = 10

np.random.seed(12321)

X = np.random.normal(1, 10, (n, n_features))
nuisance = np.random.uniform(-1,1, (n_features, 1))

W = np.random.normal(1, 10, (n, n_heter))
heter_y = np.random.uniform(-1,1, (n_heter, 1))

T = np.random.normal(10, 2, (n, 1)) # T is random!
Y = np.random.normal(T + T*W.dot(heter_y) + 20*X.dot(nuisance), 0.1)

df = pd.concat([
    pd.DataFrame(X, columns=[f"f{f}" for f in range(n_features)]),
    pd.DataFrame(W, columns=[f"w{f}" for f in range(n_heter)])
], axis=1).assign(T=T, Y=Y)
이제 이 데이터셋을 훈련 셋과 테스트 셋으로 나눕니다.
from sklearn.model_selection import train_test_split

train, test = train_test_split(df, test_size=0.5)
train.shape, test.shape
((50000, 32), (50000, 32))그리고 처치효과의 이질성을 추정하는 모델 두 개, \(M1\)과 \(M2\)를 학습합니다. \(M1\)에는 예측력은 높지만 처치효과 이질성에는 영향을 주지 않는 특성을 넣고, \(M2\)에는 예측력은 낮지만 처치효과 이질성에 영향을 주는 특성을 넣습니다.
m1 = smf.ols("Y~T*(" + "+".join([f"f{f}" for f in range(n_features)])+")", data=df).fit()
m2 = smf.ols("Y~T*(" + "+".join([f"w{f}" for f in range(n_heter)])+")", data=df).fit()
두 모델의 예측력을 \(R^2\)로 비교해 보면, 예상대로 \(M1\)이 \(M2\)보다 훨씬 좋습니다.
from sklearn.metrics import r2_score

print("M1:", r2_score(test["Y"], m1.predict(test)))
print("M2:", r2_score(test["Y"], m2.predict(test)))
M1: 0.9160516511287358
M2: 0.08378351037639298이번에는 두 모델의 누적 탄력성 곡선(cumulative elasticity curve)을 계산해 보겠습니다. 그러려면 조건부 평균 처치효과(CATE) 예측값이 필요합니다. 여기서는 모델이 모두 선형이므로 다음 공식으로 CATE 예측값을 구할 수 있습니다.
\[ \hat{CATE_i} = M(X, W, t) - M(X, W, t-1) \]
@curry
def elast(data, y, t):
        return (np.sum((data[t] - data[t].mean())*(data[y] - data[y].mean())) /
                np.sum((data[t] - data[t].mean())**2))


def cumulative_gain(dataset, prediction, y, t, min_periods=30, steps=100):
    size = dataset.shape[0]
    ordered_df = dataset.sort_values(prediction, ascending=False).reset_index(drop=True)
    n_rows = list(range(min_periods, size, size // steps)) + [size]
    return np.array([elast(ordered_df.head(rows), y, t) * (rows/size) for rows in n_rows])
test_pred = test.assign(
cate_1 = m1.predict(test) - m1.predict(test.assign(T=test["T"]-1)),
cate_2 = m2.predict(test) - m2.predict(test.assign(T=test["T"]-1))
)CATE 예측값을 구했으니 누적 탄력성 곡선으로 평가해 봅시다.
cumelast_1 = cumulative_gain(test_pred, "cate_1", "Y", "T", steps=100)
cumelast_2 = cumulative_gain(test_pred, "cate_2", "Y", "T", steps=100)plt.plot(range(len(cumelast_1)), cumelast_1, label="M1")
plt.plot(range(len(cumelast_2)), cumelast_2, label="M2")
plt.plot([0, 100], [0, elast(test_pred, "Y", "T")], linestyle="--", label="Random Model", color="black")
plt.legend()
plt.ylabel("Cumulative Elasticity");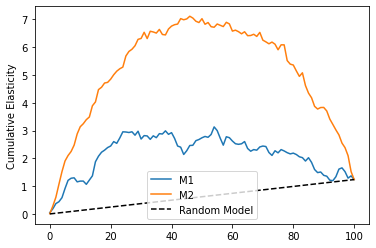
보다시피 테스트 셋에서 \(R^2\)가 더 높았던 \(M1\)이 이번에는 \(M2\)보다 훨씬 나쁩니다. 무작위 데이터를 쓰더라도 예측력이 높다고 곧 좋은 인과 모델이 되지는 않는다는 뜻입니다.
인과추론을 위한 예측 지표
그렇다고 예측 지표로 인과 모델을 제대로 평가할 방법이 아예 없다는 말은 아닙니다. 그 방법을 찾기 위해 DGP에 세웠던 덧셈 구조 가정으로 돌아가 보겠습니다.
\[ Y = g(x) + f(t,x) \]
예측 지표를 쓰려면 결과변수를 어떻게든 변환해서 \(g(x)\) 성분을 걷어 내야 합니다. 그러면 남은 예측력은 모두 인과관계를 학습하는 데 쓰일 수밖에 없습니다.
\[ \tilde{Y} = Y - g(x) = f(t,x) \]
한 가지 방법은 \(Y\)를 직교화(orthogonalization)하는 것입니다. 어떤 머신러닝 모델로든 \(g\)를 추정한 뒤 아웃 오브 폴드(out of fold) 잔차를 구하면 됩니다.
\[ \tilde{Y} = Y - \hat{g}(x) \]
denoise_m = smf.ols("Y~"+
                    "+".join([f"w{f}" for f in range(n_heter)])+
                    "+"+
                    "+".join([f"f{f}" for f in range(n_features)]), data=train).fit()

test_res = test.assign(Y_res = test["Y"] - denoise_m.predict(test) + test["Y"].mean())
이렇게 하고 나면, 각 모델이 잔차화한 결과 \(\tilde{Y}\)를 얼마나 잘 예측하는지 평가할 수 있습니다. 이 새 결과변수를 더 잘 예측하는 모델일수록 더 나은 인과 모델입니다.
print("M1:", r2_score(test_res["Y_res"], m1.predict(test_res)))
print("M2:", r2_score(test_res["Y_res"], m2.predict(test_res)))
M1: -281.7950185092476
M2: -24.04912481654577다만 이 접근법은 \(g(x)\)를 얼마나 잘 추정하느냐에 따라 성패가 갈린다는 단점이 있습니다.
의견 나누기
번역이 어색한 곳, 더 쉬운 설명, 궁금한 점을 남겨 주세요. GitHub 계정으로 로그인하면 댓글을 달 수 있고, 남긴 의견은 GitHub Discussions에 장별로 모입니다.