코드
import pandas as pd
import numpy as np
from matplotlib import pyplot as plt
import seaborn as sns
from nb21 import cumulative_gain, elast
import statsmodels.formula.api as smf
from matplotlib import style
style.use("ggplot")다음으로 살펴볼 메타러너(meta-learner)는 사실 ’메타러너’라는 이름이 붙기도 전에 나왔습니다. 제가 아는 한, 출발점은 인과추론 문헌에 풍성한 연구 흐름을 열어 준 2016년의 멋진 논문입니다. 논문 제목은 Double Machine Learning for Treatment and Causal Parameters이고, 저자도 무척 많습니다. Victor Chernozhukov, Denis Chetverikov, Mert Demirer, Esther Duflo(덧붙이자면 Abhijit Banerjee, Michael Kremer와 함께 “세계 빈곤을 줄이기 위한 실험적 접근”으로 2019년 노벨 경제학상을 받았습니다), Christian Hansen, Whitney Newey, James Robins가 함께 썼습니다. 이런 사람들이 썼으니 좋은 논문일 수밖에 없었고, 저는 별 이유 없이 저자들을 어벤져스로 그려 보기까지 했습니다(이 아이디어는 Paul Goldsmith-Pinkham이 먼저 냈으니 공은 그에게 돌립니다).
이 논문의 문제는 딱 하나, 읽기가 엄청나게 어렵다는 점입니다(계량경제학 논문이니 놀랄 일은 아닙니다). 이 책의 목표는 인과추론을 누구나 쓰는 도구로 만드는 것이니, 여기서는 편향 제거/직교화 머신러닝(Debiased/Orthogonal Machine Learning)을 직관적으로 풀어 보려 합니다.
그런데 다른 메타러너와 따로 떼어 한 장을 통째로 내줄 만큼 특별한 이유가 뭘까요? 제 눈길을 끈 것은 편향 제거/직교화 머신러닝이 이론적으로 아주 탄탄하게 뒷받침된다는 점이었습니다. 지금까지 본 T 러너, S 러너, X 러너는 모두 어딘가 임시방편 같은 느낌이 있었습니다. 왜 작동하는지 직관적으로 설명할 수는 있어도 일반적인 방법처럼 보이지는 않았습니다. 반면 편향 제거/직교화 머신러닝에는 매우 직관적이면서도 아주 엄밀한, 범용으로 적용할 수 있는 틀이 있습니다. 게다가 연속형 처치와 이산형 처치 모두에 쓸 수 있는데, T 러너도 X 러너도 하지 못하는 일입니다. 이 방법을 다룬 논문들이 추정량의 점근적 성질까지 훌륭하게 분석해 두었다는 점은 말할 것도 없습니다. 그럼 더 뜸 들이지 말고 바로 시작하겠습니다.
이번에도 아이스크림 판매 데이터셋을 예시로 쓰겠습니다. 다시 짚자면, 여기서 찾으려는 것은 가격이 판매량에 미치는 효과의 이질성입니다. 테스트 데이터의 가격은 무작위로 배정되었지만, 훈련 데이터에는 관측된 가격만 있어서 편향되어 있을 수 있습니다.
import pandas as pd
import numpy as np
from matplotlib import pyplot as plt
import seaborn as sns
from nb21 import cumulative_gain, elast
import statsmodels.formula.api as smf
from matplotlib import style
style.use("ggplot")test = pd.read_csv("./data/ice_cream_sales_rnd.csv")
train = pd.read_csv("./data/ice_cream_sales.csv")
train.head()| temp | weekday | cost | price | sales | |
|---|---|---|---|---|---|
| 0 | 17.3 | 6 | 1.5 | 5.6 | 173 |
| 1 | 25.4 | 3 | 0.3 | 4.9 | 196 |
| 2 | 23.3 | 5 | 1.5 | 7.6 | 207 |
| 3 | 26.9 | 1 | 0.3 | 5.3 | 241 |
| 4 | 20.2 | 1 | 1.0 | 7.2 | 227 |
np.random.seed(123)
sns.scatterplot(data=train.sample(1000), x="price", y="sales", hue="weekday")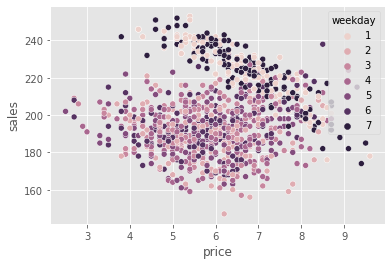
편향의 원인 하나는 아주 분명합니다. 보다시피 주말(요일 값이 1과 7인 날)에는 가격이 훨씬 높습니다. 하지만 기온이나 원가 같은 다른 교란 요인(confounder)도 있을 수 있습니다. 따라서 이 데이터로 인과추론을 하려면 이 편향을 바로잡아야 합니다.
이 편향을 없애는 방법 하나는 선형 모델로 교란 요인을 통제하면서 가격이 판매량에 미치는 처치효과를 추정하는 것입니다.
\[ Sales_i = \alpha + \tau price_i + \beta_1 temp_i + \beta_2 cost_i + \pmb{\beta_3} Weekday_i + e_i \]
여기서 \(\pmb{\beta_3}\)는 각 요일 더미에 대응하는 매개변수 벡터입니다.
관심 있는 것은 처치효과인 \(\tau\) 하나뿐이라는 점에 주목하세요. 나머지 매개변수는 신경 쓰지 않으므로 장애모수(nuisance parameter)라고 부르겠습니다. 그런데 알고 보면 신경 쓰지 않는 매개변수라도 제대로 맞혀야 합니다. 그렇지 않으면 처치효과가 어긋나기 때문입니다. 좀 성가신 일입니다.
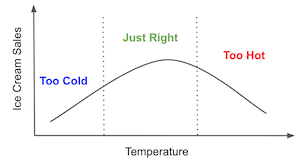
예를 들어 곰곰이 생각해 보면 temp와 판매량의 관계는 선형이 아닐 가능성이 큽니다. 처음에는 기온이 오를수록 해변에 가서 아이스크림을 사 먹는 사람이 늘어나니 판매량이 증가합니다. 하지만 어느 순간 너무 더워지면 사람들은 집에 있는 편이 낫다고 판단합니다. 그때부터는 판매량이 줄어듭니다. temp와 판매량의 관계는 어딘가에서 정점을 찍은 뒤 감소할 것입니다. 즉, 위 모델은 아마 틀렸습니다. 다음처럼
\[ Sales_i = \alpha + \tau price_i + \beta_1 temp_i + \beta_2 temp^2_i + \beta_3 cost_i + \pmb{\beta_4} Weekday_i + e_i \]
제곱항이 들어간 모델이었어야 합니다.
공변량이 몇 개뿐인데도 장애모수를 어떻게 모델링할지 고민하는 일은 벌써 지루합니다. 그런데 공변량이 수십, 수백 개라면 어떨까요? 요즘 데이터셋에서는 아주 흔한 일입니다. 그럼 어떻게 해야 할까요? 답은 지금까지 나온 계량경제학 정리 가운데 가장 멋진 정리에 있습니다.
Frisch, Waugh, Lovell은 선형회귀의 아주 멋진 성질을 알아챈 20세기 계량경제학자들입니다. 회귀분석의 잔차를 다룰 때와 고정효과를 이야기할 때 이미 살펴봤으니 처음 듣는 내용은 아닐 겁니다. 하지만 이 정리는 직교화 머신러닝을 이해하는 열쇠이므로 다시 한번 정리해 둘 만합니다.
특성 집합 \(X_1\)과 또 다른 특성 집합 \(X_2\)로 이루어진 선형회귀 모델이 있다고 해 봅시다. 이 모델의 매개변수를 추정합니다.
\[ \hat{Y} = \hat{\beta_1} X_1 + \hat{\beta_2} X_2 \]
여기서 \(X_1\)과 \(X_2\)는 특성 행렬(특성마다 열 하나, 관측값마다 행 하나)이고 \(\hat{\beta_1}\)과 \(\hat{\beta_2}\)는 행 벡터입니다. 다음 단계를 거치면 똑같은 \(\hat{\beta_1}\)을 얻을 수 있습니다.
정말 끝내주게 멋진 성질입니다. 여기서는 일반적인 형태로 적었지만, 한쪽 특성 집합이 처치변수 하나일 수도 있다는 점에 주목하세요. 그러면 장애모수를 모두 따로 추정할 수 있습니다. 먼저 결과를 특성에 회귀해 결과의 잔차를 얻습니다. 다음으로 처치를 특성에 회귀해 처치의 잔차를 얻습니다. 마지막으로 결과의 잔차를 특성 잔차에 회귀합니다. 이렇게 하면 결과를 특성과 처치에 한꺼번에 회귀했을 때와 정확히 같은 추정값이 나옵니다.
하지만 제 말만 믿지는 마세요. FWL은 인과추론에 관심 있는 사람이라면 누구나 한 번쯤 직접 해 봐야 합니다. 아래 예시에서는 먼저 공변량이 결과(판매량)와 처치(가격)에 미치는 효과를 추정한 뒤 처치효과를 추정합니다.
my = smf.ols("sales~temp+C(weekday)+cost", data=train).fit()
mt = smf.ols("price~temp+C(weekday)+cost", data=train).fit()
그다음 잔차를 이용해 가격이 판매량에 미치는 평균 처치효과(ATE)를 추정합니다.
smf.ols("sales_res~price_res",
        data=train.assign(sales_res=my.resid, # sales residuals
                          price_res=mt.resid) # price residuals
).fit().summary().tables[1]| coef | std err | t | P>|t| | [0.025 | 0.975] | |
|---|---|---|---|---|---|---|
| Intercept | -4.96e-13 | 0.111 | -4.49e-12 | 1.000 | -0.217 | 0.217 |
| price_res | -4.0004 | 0.110 | -36.428 | 0.000 | -4.216 | -3.785 |
ATE는 -4로 추정되었습니다. 가격이 한 단위 오를 때마다 판매량이 4단위 줄어든다는 뜻입니다.
이제 같은 매개변수를 추정하되, 이번에는 처치와 공변량을 한 모델에 함께 넣어 보겠습니다.
smf.ols("sales~price+temp+C(weekday)+cost", data=train).fit().params["price"]-4.000429145475454보다시피 두 값이 정확히 같습니다! 처치효과를 한 번에 추정하든 FWL 단계로 나눠 추정하든 수학적으로 같다는 사실을 보여 줍니다.
달리 말하면, 처치효과는 잔차에 대한 회귀로 구할 수 있습니다. \(Y\)를 \(X\)에 회귀해 얻은 잔차를, \(T\)를 \(X\)에 회귀해 얻은 잔차에 회귀하는 것입니다. \(\sim\)를 회귀 연산자라고 하면 FWL 정리를 다음처럼 요약할 수 있습니다.
\[ (Y - (Y \sim X)) \sim (T - (T \sim X)) \]
이는 본질적으로 다음 모델에서 인과 매개변수 \(\tau\)를 추정하는 것과 같습니다.
\[ Y_i - E[Y_i | X_i] = \tau \cdot (T_i - E[T_i | X_i]) + \epsilon \]
앞서 말했듯이 FWL이 대단한 이유는 인과 매개변수를 추정하는 절차와 장애모수를 추정하는 절차를 분리해 주기 때문입니다. 하지만 처음 던진 질문에는 아직 답하지 못했습니다. 장애모수의 함수 형태를 정확히 지정해야 하는 번거로움을 어떻게 피할 수 있을까요? 다시 말해, 장애모수는 신경 쓰지 않고 인과 매개변수에만 집중하려면 어떻게 해야 할까요? 바로 여기서 머신러닝이 등장합니다.
이중/편향 제거 머신러닝(Double/Debiased ML)은 프리슈-워-로벨 정리에 스테로이드를 놓은 강화판이라고 볼 수 있습니다. 아이디어는 아주 간단합니다. 결과와 처치의 잔차를 만들 때 머신러닝 모델을 쓰는 것입니다.
\[ Y_i - \hat{M}_y(X_i) = \tau \cdot (T_i - \hat{M}_t(X_i)) + \epsilon \]
여기서 \(\hat{M}_y(X_i)\)는 \(E[Y|X]\)를, \(\hat{M}_t(X_i)\)는 \(E[T|X]\)를 추정합니다.
핵심은 머신러닝 모델이 매우 유연하다는 데 있습니다. 그래서 FWL식 직교화(orthogonalization)를 그대로 유지하면서도 \(Y\)와 \(T\)의 잔차를 추정할 때 상호작용과 비선형성을 잡아낼 수 있습니다. 즉, 올바른 처치효과를 얻으려고 공변량 \(X\)와 결과 \(Y\)의 관계든 공변량과 처치의 관계든 모수적 가정을 할 필요가 없습니다. 관측되지 않은 교란 요인이 없다면 다음 직교화 절차로 ATE를 구할 수 있습니다.
여기서 \(\tau\)는 인과 매개변수인 ATE이며, 예를 들어 OLS로 추정할 수 있습니다.
머신러닝으로 얻는 힘은 유연성입니다. 머신러닝은 장애모수가 얽힌 관계의 복잡한 함수 형태까지 잡아낼 만큼 강력합니다. 하지만 그 유연성은 골칫거리이기도 합니다. 이제 과적합(overfitting) 가능성을 고려해야 하기 때문입니다.
과적합이 어떻게 문제를 일으키는지는 Chernozhukov et al (2016)에 훨씬 깊고 엄밀하게 설명되어 있으니 꼭 읽어 보길 권합니다. 여기서는 직관에 기댄 설명으로 이어 가겠습니다.
문제를 이해하기 위해 \(M_y\) 모델이 과적합되었다고 해 봅시다. 그러면 잔차 \(\tilde{Y}\)가 원래보다 작아집니다. 이는 \(M_y\)가 \(X\)와 \(Y\)의 관계보다 더 많은 것을 잡아내고 있다는 뜻이기도 합니다. 그 ‘더 많은 것’ 가운데 일부가 \(T\)와 \(Y\)의 관계이고, \(M_y\)가 이를 일부라도 잡아내면 잔차 회귀는 0 쪽으로 편향됩니다. 다시 말해, \(M_y\)가 인과관계를 가로채서 최종 잔차 회귀에 남겨 두지 않는 것입니다.
이번에는 \(M_t\)가 과적합될 때의 문제를 보겠습니다. 이 경우 모델은 \(T\)의 분산을 실제보다 더 많이 설명합니다. 그 결과 처치의 잔차는 분산이 원래보다 작아집니다. 처치의 분산이 작으면 최종 추정량의 분산이 커집니다. 마치 거의 모두가 같은 처치를 받은 것과 같습니다. 모두가 같은 수준의 처치를 받았다면 다른 처치 수준에서 무슨 일이 일어날지 추정하기가 매우 어려워집니다. 덧붙이자면, \(T\)가 \(X\)의 결정론적 함수일 때, 즉 양수성(positivity)이 깨질 때도 같은 일이 생깁니다.
머신러닝 모델을 쓰면 이런 문제가 생깁니다. 어떻게 바로잡을 수 있을까요? 답은 교차 예측(cross prediction)과 아웃 오브 폴드(out-of-fold) 잔차에 있습니다.
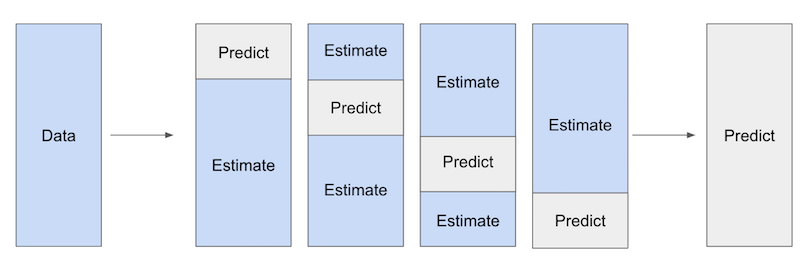
데이터를 크기가 같은 K개 부분으로 나눕니다. 그런 다음 각 부분 k마다 나머지 K-1개 부분으로 머신러닝 모델을 추정하고, k번째 부분에서 잔차를 만듭니다. 이 잔차는 아웃 오브 폴드 예측으로 만든다는 점에 주목하세요. 모델은 데이터의 한 부분에 적합하고, 예측과 잔차는 다른 부분에서 만듭니다.
그래서 모델이 과적합되더라도 잔차를 인위적으로 0으로 몰아가지 않습니다. 마지막으로 K개 부분의 예측을 모두 합쳐 최종 인과 모델 \(\tilde{Y} = \alpha + \tau \tilde{T}\)를 추정합니다.
좋습니다. 꽤 많은 내용을 다뤘으니 예시 없이는 따라오기 힘들어질 때가 됐습니다. 지금까지의 이론을 바탕으로 이중/편향 제거 머신러닝을 단계별로 구현해 보겠습니다. 그러면서 단계마다 무엇을 하는지도 설명하겠습니다.
먼저 머신러닝 모델로 장애모수에 해당하는 관계를 추정합니다. 처치 모델 \(M_t\)부터 시작하겠습니다. LGBM 모델로 공변량 temp, weekday, cost에서 가격을 예측합니다. 이 예측은 교차 예측으로, sklearn의 cross_val_predict 함수로 얻을 수 있습니다. 시각화를 위해 잔차에 평균 \(\hat{\mu_t}\)도 더해 두겠습니다.
from lightgbm import LGBMRegressor
from sklearn.model_selection import cross_val_predict

y = "sales"
T = "price"
X = ["temp", "weekday", "cost"]

debias_m = LGBMRegressor(max_depth=3)

train_pred = train.assign(price_res =  train[T] -
                          cross_val_predict(debias_m, train[X], train[T], cv=5)
                          + train[T].mean()) # add mu_t for visualization.
\(M_t\) 모델을 편향 제거 모델(debias model)이라고 부른 점에 주목하세요. 이중/편향 제거 머신러닝에서 이 모델이 맡은 역할이 처치의 편향을 제거하는 것이기 때문입니다. 잔차 \(\tilde{T} = T - M_t(X)\)는 \(X\)에서 오는 교란편향을 모델이 모두 걷어 낸 처치라고 볼 수 있습니다. 즉, \(\tilde{T}\)는 \(X\)와 직교합니다. 직관적으로 보면, 설명할 수 있는 부분은 이미 모두 설명했으니 \(\tilde{T}\)는 더 이상 \(X\)로 설명되지 않습니다.
이를 확인하기 위해 앞에서 본 그래프를 다시 그리되, 가격 대신 가격의 잔차를 넣어 보겠습니다. 앞에서는 주말 가격이 더 높았던 것을 기억하나요? 이제 그 편향은 사라졌습니다. 모든 요일에서 가격 잔차의 분포가 같습니다.
np.random.seed(123)
sns.scatterplot(data=train_pred.sample(1000), x="price_res", y="sales", hue="weekday");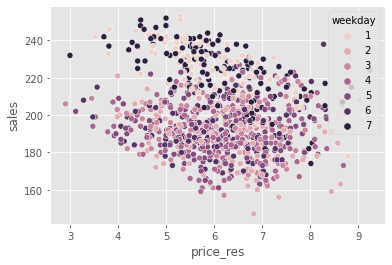
\(M_t\)의 역할이 처치의 편향을 제거하는 것이라면 \(M_y\)는 무슨 일을 할까요? 이 모델의 역할은 \(Y\)에서 분산을 덜어 내는 것입니다. 그래서 잡음 제거 모델(denoising model)이라고 부르겠습니다. 직관적으로 \(M_y\)는 \(X\)로 생긴 분산을 모두 설명해 없앤 결과를 만들어 냅니다. 그 덕분에 \(\tilde{Y}\)에서는 인과 추정이 더 쉬워집니다. 잡음이 줄어드니 인과관계가 더 잘 보입니다.
denoise_m = LGBMRegressor(max_depth=3)

train_pred = train_pred.assign(sales_res =  train[y] -
                               cross_val_predict(denoise_m, train[X], train[y], cv=5)
                               + train[y].mean())
앞과 같은 그래프를 그리되 판매량 대신 판매량의 잔차를 넣으면, \(Y\)의 분산이 전보다 훨씬 작아진 것을 볼 수 있습니다.
np.random.seed(123)
sns.scatterplot(data=train_pred.sample(1000), x="price_res", y="sales_res", hue="weekday");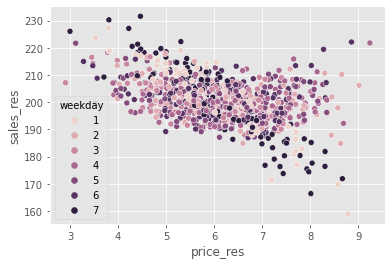
이제 가격과 판매량의 음의 관계가 한눈에 보입니다.
마지막으로 이 인과관계를 추정하기 위해 잔차끼리 회귀분석을 합니다.
final_model = smf.ols(formula='sales_res ~ price_res', data=train_pred).fit()
final_model.summary().tables[1]| coef | std err | t | P>|t| | [0.025 | 0.975] | |
|---|---|---|---|---|---|---|
| Intercept | 224.5586 | 0.443 | 506.469 | 0.000 | 223.689 | 225.428 |
| price_res | -3.9228 | 0.071 | -54.962 | 0.000 | -4.063 | -3.783 |
보다시피 잔차화한, 즉 직교화한 판매량과 가격을 쓰면 가격과 판매량의 관계가 음이라고 매우 확신할 수 있습니다. 충분히 납득이 가는 결과입니다. 가격을 올리면 아이스크림 수요는 줄어야 하니까요.
하지만 잔차화하지 않은 원래 데이터에서 가격과 판매량의 관계를 보면, 편향 때문에 양의 관계가 나타납니다. 판매량이 많을 것을 예상하고 가격을 올리기 때문입니다.
final_model = smf.ols(formula='sales ~ price', data=train_pred).fit()
final_model.summary().tables[1]| coef | std err | t | P>|t| | [0.025 | 0.975] | |
|---|---|---|---|---|---|---|
| Intercept | 192.9679 | 1.013 | 190.414 | 0.000 | 190.981 | 194.954 |
| price | 1.2294 | 0.162 | 7.575 | 0.000 | 0.911 | 1.547 |
지금까지는 이중/편향 제거 머신러닝으로 평균 처치효과(ATE)를 추정하는 데 집중했습니다. 하지만 이 방법은 처치효과의 이질성, 즉 조건부 평균 처치효과(CATE)를 추정하는 데도 쓸 수 있습니다. 쉽게 말해, 이제는 인과 매개변수 \(\tau\)가 분석단위의 공변량에 따라 달라진다고 보는 것입니다.
\[ Y_i - {M}_y(X_i) = \tau(X_i) \cdot (T_i - {M}_t(X_i)) + \epsilon_i \]
이 모델을 추정할 때도 잔차화한 가격과 판매량을 똑같이 쓰지만, 이번에는 가격의 잔차와 다른 공변량의 상호작용을 넣습니다. 그러면 선형 CATE 모델을 적합할 수 있습니다.
\[ \tilde{Y_i} = \alpha + \beta_1 \tilde{T_i} + \pmb{\beta}_2 \pmb{X_i} \tilde{T_i} + \epsilon_i \]
이 모델을 추정하고 나면, 가격이 무작위로 배정된 테스트 데이터로 CATE를 예측합니다. 최종 모델이 선형이므로 CATE는 기계적으로 계산할 수 있습니다.
\[ \hat{\mu}(\partial Sales_i, X_i) = M(Price=1, X_i) - M(Price=0, X_i) \]
여기서 \(M\)은 최종 선형 모델입니다.
final_model_cate = smf.ols(formula='sales_res ~ price_res * (temp + C(weekday) + cost)', data=train_pred).fit()

cate_test = test.assign(cate=final_model_cate.predict(test.assign(price_res=1))
                        - final_model_cate.predict(test.assign(price_res=0)))
이 모델이 가격 민감도가 높은 분석단위와 낮은 분석단위를 얼마나 잘 구분하는지 확인하기 위해 누적 탄력성 곡선(cumulative elasticity curve)을 쓰겠습니다.
gain_curve_test = cumulative_gain(cate_test, "cate", y=y, t=T)
plt.plot(gain_curve_test, color="C0", label="Test")
plt.plot([0, 100], [0, elast(test, y, T)], linestyle="--", color="black", label="Baseline")
plt.legend();
plt.title("R-Learner");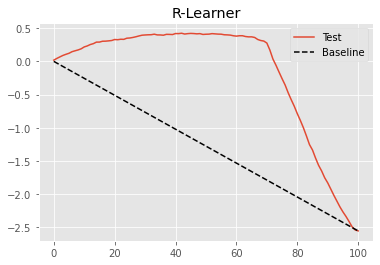
위 곡선에서 보듯이, 최종 모델을 선형으로 둔 이중/편향 제거 머신러닝 절차만으로도 이미 성능이 아주 좋습니다. 하지만 더 잘할 수도 있습니다. 사실 이 절차는 아주 일반적이어서 하나의 메타러너처럼 이해할 수 있습니다. Nie와 Wager는 Robinson(1988)의 업적을 기리고 잔차화의 역할을 강조하는 의미에서 이를 R 러너(R-Learner)라고 불렀습니다.
이렇게 일반화할 수 있는 것은 이중/편향 제거 머신러닝 절차가 새로운 손실 함수를 정의한다는 사실 덕분입니다. 이 손실 함수는 원하는 방식으로 최소화할 수 있습니다. 이어서 앞에서 목표 변환(target transformation) 방법, 즉 F 러너를 다룰 때와 아주 비슷한 방식으로 이 손실을 최소화하는 법을 보겠습니다.
이중 머신러닝(Double ML)의 장점은 인과 모델에서 장애모수를 학습하는 번거로움을 덜어 준다는 것입니다. 덕분에 ATE든 CATE든 관심 있는 인과 매개변수를 학습하는 데 온 신경을 쏟을 수 있습니다. 하지만 위의 설정에서는 머신러닝으로 잔차화한 뒤에도 최종 인과 모델로 여전히 선형 모델을 썼습니다. 이 예시로 말하면 가격이 판매량에 선형으로 영향을 준다고 가정한 셈입니다. 가격 범위가 좁다면 괜찮겠지만, 미시경제학 이론에 따르면 꼭 그렇지는 않습니다. 가격이 낮을 때는 가격이 한 단위 오르면 수요가 2단위 줄어들다가, 가격이 높아지면 한 단위 올라도 수요가 1단위만 줄어들 수 있습니다. 이는 선형 관계가 아닙니다.
여기서 미시경제학 이론을 끌어와 처치에 대한 결과의 함수 형태를 추측해 볼 수도 있지만, 그 일을 머신러닝 모델에 맡길 수도 있습니다. 복잡한 함수 형태를 기계가 직접 학습하게 하는 것입니다. 알고 보면 원래의 이중/편향 제거 머신러닝 알고리즘을 조금만 바꾸면 충분히 할 수 있습니다.
먼저 앞에서와 똑같이, 머신러닝 모델의 교차 예측으로 처치와 결과를 직교화합니다.
y = "sales"
T = "price"
X = ["temp", "weekday", "cost"]

debias_m = LGBMRegressor(max_depth=3)
denoise_m = LGBMRegressor(max_depth=3)

train_pred = train.assign(price_res =  train[T] - cross_val_predict(debias_m, train[X], train[T], cv=5),
                          sales_res =  train[y] - cross_val_predict(denoise_m, train[X], train[y], cv=5))
여기까지는 달라진 것이 없습니다. 이제부터 재미있어집니다. 이중/편향 제거 머신러닝은 데이터를 다음과 같이 모델링한다는 점을 떠올려 보세요.
\[ Y_i = \hat{M}_y(X_i) + \tau(X_i) \big(T_i - \hat{M}_t(X)\big) + \hat{\epsilon}_i \]
여기서 \(\hat{M}_y\)와 \(\hat{M}_t\)는 각각 특성으로 결과와 처치를 예측하는 모델입니다. 위 식의 항을 정리하면 오차항만 따로 떼어 낼 수 있습니다.
\[ \hat{\epsilon}_i = \big(Y_i - \hat{M}_y(X_i)\big) - \tau(X_i) \big(T_i - \hat{M}_t(X)\big) \]
이건 정말 대단한 결과입니다. 이제 이 식을 인과 손실 함수(causal loss function)라고 부를 수 있기 때문입니다. 즉, 이 손실의 제곱을 최소화하면 \(\tau(X_i)\)의 기댓값, 곧 CATE를 추정하게 됩니다.
\[ \hat{L}_n(\tau(x)) = \frac{1}{n} \sum^n_{i=1}\bigg(\big(Y_i - \hat{M}_y(X_i)\big) - \tau(X_i) \big(T_i - \hat{M}_t(X)\big)\bigg)^2 \]
이 손실은 R 러너가 최소화하는 손실이라서 R 손실(R-Loss)이라고도 부릅니다. 좋습니다. 그런데 이 손실 함수는 어떻게 최소화할까요? 방법은 사실 여러 가지인데, 여기서는 가장 간단한 방법을 다루겠습니다. 먼저 복잡한 표기를 정리하기 위해, 앞의 손실 함수를 잔차화한 처치와 결과로 다시 씁니다.
\[ \hat{L}_n(\tau(x)) = \frac{1}{n} \sum^n_{i=1}\bigg( \tilde{Y}_i - \tau(X_i) \tilde{T}_i \bigg)^2 \]
마지막으로 대수 곡예를 조금 부려서 \(\tilde{T}_i\)를 괄호 밖으로 빼내고, 손실 함수의 제곱 부분에 \(\tau(X_i)\)만 남깁니다.
\[ \hat{L}_n(\tau(x)) = \frac{1}{n} \sum^n_{i=1} \tilde{T}_i^2 \left(\frac{\tilde{Y}_i}{\tilde{T}_i} - \tau(X_i)\right)^2 \]
위 손실을 최소화하는 것은 괄호 안의 항을 최소화하되, 각 항에 \(\tilde{T}_i^2\)만큼 가중치를 주는 것과 같습니다. 그리고 괄호 안을 최소화하는 것은 \(\frac{\tilde{Y}_i}{\tilde{T}_i}\)를 예측하는 것과 같습니다. 이것이 비모수 인과 손실을 얻는 가중치 트릭(weight trick)입니다. 앞에서 본 목표 변환 아이디어와 얼마나 비슷한지 보세요. 실제로 이것은 목표 변환에 가중치 트릭을 더한 것입니다.
코드로 넘어가기 전에 정리하면, 장애모수 모델과 잔차화한 처치·결과가 준비된 지금 할 일은 다음과 같습니다. 1. 가중치 \(\tilde{T}_i^2\)를 만듭니다. 2. 목표 \(\dfrac{\tilde{Y}_i}{\tilde{T}_i}\)를 만듭니다. 3. 아무 예측 방법이나 써서, 가중치(1)를 적용해 목표(2)를 예측합니다.
코드는 다음과 같습니다. 보다시피 놀라울 만큼 간단합니다.
model_final = LGBMRegressor(max_depth=3)

# create the weights
w = train_pred["price_res"] ** 2

# create the transformed target
y_star = (train_pred["sales_res"] / train_pred["price_res"])

# use a weighted regression ML model to predict the target with the weights.
model_final.fit(X=train[X], y=y_star, sample_weight=w);
위 머신러닝 모델은 그저 기성 예측 모델일 뿐인데도 CATE를 추정하고 있습니다. 이것이 비모수 이중 머신러닝의 힘입니다. 앞에서는 CATE 추정의 최종 모델로 선형회귀를 썼습니다. 이제는 범용 손실을 정의했으니 손에 쥔 어떤 예측 모델이든 최종 모델로 쓸 수 있습니다.
이제 테스트 데이터로 이 비모수 버전을 앞의 선형 버전과 비교해 보겠습니다.
먼저 개별 처치효과를 추정합니다.
cate_test_non_param = test.assign(cate=model_final.predict(test[X]))다음으로 비모수 버전의 누적 탄력성 곡선을 모수적(선형) 버전의 이중/직교화 머신러닝에서 얻은 곡선과 나란히 그려 봅니다.
gain_curve_test_non_param = cumulative_gain(cate_test_non_param, "cate", y=y, t=T)
plt.plot(gain_curve_test_non_param, color="C0", label="Non-Parametric")
plt.plot(gain_curve_test, color="C1", label="Parametric")
plt.plot([0, 100], [0, elast(test, y, T)], linestyle="--", color="black", label="Baseline")
plt.legend();
plt.title("R-Learner");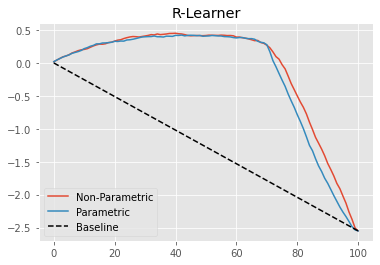
큰 개선은 아니지만 나아지긴 했습니다. 게다가 처치 함수의 함수 형태를 지정하지 않아도 된다는 것만으로도 이미 큰 이점입니다.
넘어가기 전에 흔한 오해 하나를 짚고 싶습니다. 비모수 이중 머신러닝 모델로 CATE를 추정한다고 하면, 비선형 처치효과를 얻을 수 있을 것처럼 보입니다. 예를 들어 할인이 판매량에 비선형으로, 그것도 제곱근 함수를 통해 영향을 주는 아주 간단한 데이터 생성 과정(DGP)을 가정해 봅시다.
\[ Sales_i = 20 + 10*\sqrt{Discount_i} + e_i \]
처치효과는 이 Sales 함수를 처치로 미분한 도함수입니다.
\[ \dfrac{\partial Sales_i}{\partial Discount_i} = \dfrac{10}{2\sqrt{Discount_i}} \]
보다시피 처치효과는 선형이 아닙니다. 처치가 커질수록 오히려 약해집니다. 이 DGP에서는 아주 자연스러운 일입니다. 처음에는 할인을 조금만 해도 판매량이 크게 늘어납니다. 하지만 할인을 너무 많이 하면, 사람들이 한없이 사고 싶어 하지는 않으니 할인을 한 단위 더할 때마다 판매량에 미치는 영향은 점점 줄어듭니다. 따라서 할인은 사람들이 충분히 샀다고 느끼는 지점까지만 효과가 있습니다.
그렇다면 비모수 머신러닝이 처치효과의 이런 포화 현상을 잡아낼 수 있을까요? 할인 수준이 낮은 데이터에서 출발해, 할인이 더 컸다면 처치효과가 더 작았으리라는 것까지 외삽할 수 있을까요? 답은… 어느 정도는 그렇습니다. 더 잘 이해하기 위해 위 DGP대로 데이터를 생성해 보겠습니다.
np.random.seed(321)
n=5000
discount = np.random.gamma(2,10, n).reshape(-1,1)
discount.sort(axis=0) # for better ploting
sales = np.random.normal(20+10*np.sqrt(discount), 1)
이 DGP를 그래프로 그려 보면 두 변수 사이의 제곱근 관계가 보입니다.
plt.plot(discount, 20 + 10*np.sqrt(discount))
plt.ylabel("Sales")
plt.xlabel("Discount");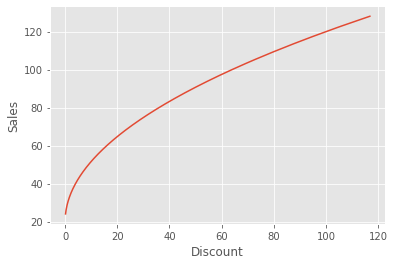
이제 이 데이터에 비모수 이중/편향 제거 머신러닝을 적용해 보겠습니다.
debias_m = LGBMRegressor(max_depth=3)
denoise_m = LGBMRegressor(max_depth=3)

# orthogonalising step
discount_res =  discount.ravel() - cross_val_predict(debias_m, np.ones(discount.shape), discount.ravel(), cv=5)
sales_res =  sales.ravel() - cross_val_predict(denoise_m, np.ones(sales.shape), sales.ravel(), cv=5)

# final, non parametric causal model
non_param = LGBMRegressor(max_depth=3)
w = discount_res ** 2
y_star = sales_res / discount_res

non_param.fit(X=discount_res.reshape(-1,1), y=y_star.ravel(), sample_weight=w.ravel());
위 모델로 CATE 추정값을 얻을 수 있습니다. 문제는 CATE가 선형이 아니라는 점입니다. 처치가 커질수록 CATE는 작아져야 합니다. 여기서 답하려는 질문은 비모수 모델이 이 비선형성을 잡아낼 수 있느냐는 것입니다.
제대로 답하려면 이중/편향 제거 머신러닝이 데이터 생성 과정에 어떤 가정을 깔고 있는지 떠올려야 합니다. 이 가정은 앞에서 세운 식에 드러나 있습니다.
\[ \tilde{Y}_i = \tau(X_i) \tilde{T}_i + e_i \]
말로 풀면, 잔차화한 결과는 잔차화한 처치에 조건부 처치효과를 곱한 값과 같다는 뜻입니다. 즉, 처치가 결과에 선형으로 영향을 준다는 것입니다. 여기에는 비선형성이 없습니다. 위 모델에 따르면 처치를 1에서 10으로 올리든 100에서 110으로 올리든 결과는 고정된 양 \(\tau(X_i)\)만큼 늘어납니다. 단순한 곱셈이니까요.
그럼 비모수 모델로는 처치효과의 비선형성을 잡아낼 수 없다는 뜻일까요? 이번에도 꼭 그렇지는 않습니다… 실제로 일어나는 일은 이중 머신러닝이 비선형 CATE의 국소 선형 근사를 찾는다는 것입니다. 다시 말해 해당 처치 수준에서, 또는 그 근처에서 처치에 대한 결과의 도함수를 찾습니다. 이는 처치 지점에서 결과 함수에 접하는 직선의 기울기를 찾는 것과 같습니다.
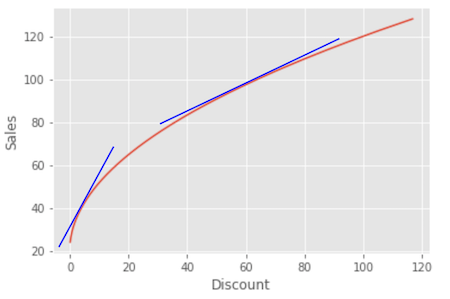
그러니까 비모수 이중 머신러닝은 처치를 늘릴수록 처치효과가 작아진다는 사실은 알아냅니다. 하지만 비선형 처치효과 자체를 찾지는 못하고, 국소 선형 처치효과를 찾을 뿐입니다. 이 선형 근사들을 실제 비선형 인과효과와 함께 그려 보면 꽤 좋은 근사라는 것을 알 수 있습니다.
cate = non_param.predict(X=discount)

plt.figure(figsize=(15,5))
plt.subplot(1,2,1)
plt.scatter(discount, sales)
plt.plot(discount, 20 + 10*np.sqrt(discount), label="Ground Truth", c="C1")
plt.title("Sales by Discount")
plt.xlabel("Discount")
plt.legend()

plt.subplot(1,2,2)
plt.scatter(discount, cate, label="$\hat{\\tau}(x)$", c="C4")
plt.plot(discount, 5/np.sqrt(discount), label="Ground Truth", c="C2")
plt.title("CATE ($\partial$Sales) by Discount")
plt.xlabel("Discount")
plt.legend();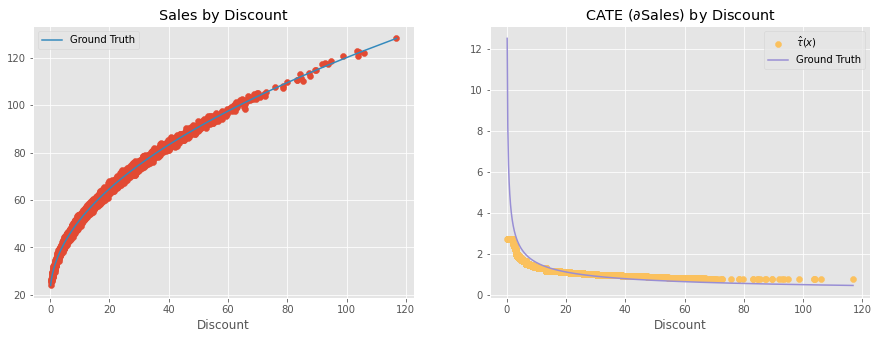
사소한 기술적 차이처럼 들릴 수 있지만, 실무에서는 아주 중요한 결과로 이어집니다. 예를 들어 위 예시에서 어떤 고객의 처치효과가 2로 나왔다고 합시다. 할인을 1단위 늘리면 그 고객에 대한 판매량이 2단위 늘어난다는 뜻입니다. 이 결과를 보고 이렇게 생각할 수 있습니다. “좋았어! 이 고객에게 할인을 왕창 줘야지! 할인 1단위마다 판매량이 2단위씩 늘어나니까.” 하지만 이는 잘못된 결론입니다. 처치효과가 2인 것은 그 할인 수준에서만입니다. 할인을 늘리는 순간 효과는 떨어집니다. 예를 들어 이 가상의 고객이 받은 할인이 5밖에 안 돼서 처치효과가 그렇게 높게 나왔다고 해 봅시다. 그 큰 처치효과를 근거로 이 고객에게 할인을 20이나 주기로 했다고 합시다. 그런데 그렇게 하면 효과가 2에서 0.5 정도로 떨어질 수 있습니다. 처치효과가 2일 때는 타당했던 20의 할인이 처치효과가 0.5일 때는 더 이상 수익이 나지 않을 수도 있습니다.
즉, 비선형 처치효과를 새로운 처치 수준으로 외삽할 때는 각별히 조심해야 합니다. 그러지 않으면 수익성이 아주 나쁜 결정을 내릴 수 있습니다. 달리 말하면, 처치효과가 선형이 아닐 때는 비모수 이중/편향 제거 머신러닝조차 반사실적 결과를 예측하는 데 애를 먹습니다. 처치효과(TE)를 낮은 처치 수준에서 높은 처치 수준으로, 또는 그 반대로 선형 외삽하려 들기 때문입니다. 그리고 비선형성 때문에 그 외삽은 빗나가기 쉽습니다.
이를 해결할 마지막 아이디어가 하나 있습니다. 다만 이 아이디어는 지금까지 본 내용보다 훨씬 덜 과학적이라는 점을 염두에 두세요. 요약하면 직교화 절차를 거친 뒤 S 러너를 쓰는 것인데, 이야기가 너무 앞서 나갔습니다. 다음에서 자세히 보겠습니다.
마지막으로 시도할 아이디어는 사고방식을 근본적으로 바꾸는 것입니다. 더 이상 CATE의 선형 근사를 추정하려 하지 않고, 대신 반사실(counterfactual) 예측을 하겠습니다.
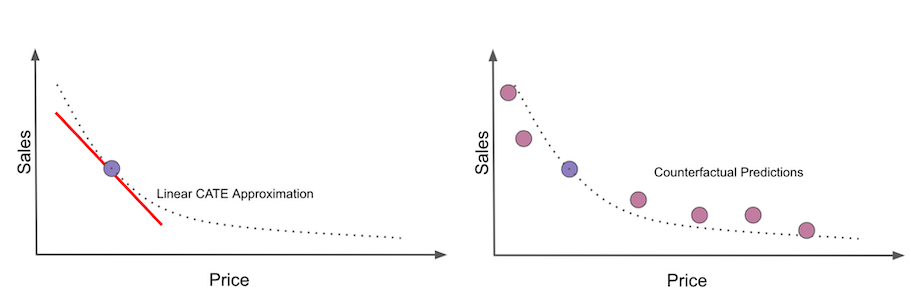
CATE는 데이터 지점에서 결과 함수의 기울기입니다. 처치를 아주 조금 늘렸을 때 결과가 얼마나 바뀔지를 나타냅니다. 좀 더 기술적으로 말하면 그 지점에서의 미분계수입니다. 반면 반사실 예측은 데이터 지점 하나로 결과 곡선 전체를 재구성하려는 시도입니다. 처치가 지금과 다른 수준이었다면 결과가 어땠을지 예측하므로 반사실 예측이라고 부릅니다.
이렇게 할 수 있다면 한 분석단위에 여러 처치를 시뮬레이션해 보고, 처치 수준마다 그 분석단위가 어떻게 반응할지 예측할 수 있습니다. 점 하나에서 곡선 전체를 외삽하는 것이니 아주 위험한 일입니다. 게다가 저는 이 기법을 실무에서 많이 써 왔지만, 이 기법이 어떻게, 왜 통하는지 보여 주는 과학 논문은 한 편도 찾지 못했습니다. 그래서 비과학적 이중 머신러닝이라고 부르는 것입니다. 한마디로, 조심하세요!
진행 방식은 다음과 같습니다. 먼저 잔차화한 처치와 결과로 쓴 전통적인 이중/편향 제거 머신러닝 식에서 출발합니다.
\[ \tilde{Y}_i = \tau(X_i) \tilde{T}_i + e_i \]
이제 처치를 처치효과 함수 안으로 옮기겠습니다. 이렇게 하면 처치효과가 비선형일 수 있게, 즉 처치 자체에 따라 달라질 수 있게 됩니다.
\[ \tilde{Y}_i = \tau(X_i, \tilde{T}_i) + e_i \]
이 처치 함수가 어떻게 생겼는지 전혀 모르니 위험한 일입니다. 어쩌면 아주 이상한 비선형 함수일지도 모릅니다. 하지만 다행히 이상한 함수를 추정하는 방법은 알고 있습니다. 바로 머신러닝입니다. 그러니 그렇게 하겠습니다. 간단히 말해, 잔차화한 처치 \(\tilde{T}\)와 특성 \(X\)를 함께 넣어 잔차화한 결과 \(\tilde{Y}\)를 예측하는 머신러닝 모델을 적합합니다. 잔차화가 중요한 이유는 편향과 잡음을 없애야 최종 머신러닝 모델이 처치효과와, 공변량 \(X\)가 그 처치효과에 미치는 영향만 학습하는 데 집중할 수 있기 때문입니다.
이 모델이 준비되면 반사실 예측을 두 단계로 합니다. 먼저 처치를 예측해 \(\tilde{T}\)를 구하고, 그 예측을 특성과 함께 최종 모델 \(\hat{\tau}(X_i, \tilde{T}_i)\)에 넣습니다.
\(\tilde{T}\)를 만들어야 하므로, 먼저 cross_prediction 함수를 직접 구현하겠습니다. 이 함수는 교차 예측값뿐 아니라 그 예측에 쓴 모델들도 돌려줍니다.
from sklearn.model_selection import KFold

def cv_estimate(train_data, n_splits, model, model_params, X, y):
    cv = KFold(n_splits=n_splits)
    models = []
    cv_pred = pd.Series(np.nan, index=train_data.index)
    for train, test in cv.split(train_data):
        m = model(**model_params)
        m.fit(train_data[X].iloc[train], train_data[y].iloc[train])
        cv_pred.iloc[test] = m.predict(train_data[X].iloc[test])
        models += [m]

    return cv_pred, models
모델까지 돌려주는 교차 예측 함수가 생겼으니 직교화 단계를 진행하겠습니다.
y = "sales"
T = "price"
X = ["temp", "weekday", "cost"]

debias_m = LGBMRegressor(max_depth=3)
denoise_m = LGBMRegressor(max_depth=3)

y_hat, models_y = cv_estimate(train, 5, LGBMRegressor, dict(max_depth=3), X, y)
t_hat, models_t = cv_estimate(train, 5, LGBMRegressor, dict(max_depth=3), X, T)

y_res = train[y] - y_hat
t_res = train[T] - t_hat
직교화를 마치면 \(\tilde{T}\)를 \(X\)와 함께 \(\tilde{Y}\)를 예측하는 머신러닝 모델에 넣습니다. 여기서는 LGBM 모델을 쓰지만 어떤 머신러닝 모델을 골라도 됩니다. LGBM의 좋은 점 하나는 단조 제약(monotonic constraint)을 걸 수 있다는 것입니다. 가격에 관해 알고 있는 바로는 가격이 오를수록 판매량이 줄어야 합니다. 이 지식을 반영해, 가격이 오를 때 예측값이 늘어나지 않도록 LGBM 모델에 제약을 걸 수 있습니다.
# -1 on price saying that the predictions should not increase as price increases
monotone_constraints = [-1 if col == T else 0 for col in X+[T]]

model_final = LGBMRegressor(max_depth=3, monotone_constraints=monotone_constraints)
model_final = model_final.fit(X=train[X].assign(**{T: t_res}), y=y_res)
여기서부터 조금 이상해집니다. 생각해 보면 이 최종 머신러닝 모델은 다음과 같은 처치 함수 \(\tau\)를 추정하고 있습니다.
\[ \tilde{Y}_i = \tau(X_i, \tilde{T}_i) + e_i \]
하지만 이 함수에서 처치효과를 뽑아낼 뚜렷한 방법이 없습니다. 그래서 처치효과를 뽑아내는 대신, 앞의 그림에서 보여 드린 것처럼 반사실 예측을 하겠습니다. 분석단위마다 여러 가격 수준을 시뮬레이션하고, 이중 머신러닝 모델로 각 가격 수준에서 판매량이 얼마일지 예측합니다.
이를 위해 1) 시뮬레이션할 가격을 모두 담은 가격 테이블과 테스트 데이터를 교차 조인(cross join)합니다. 결과는 다음과 같습니다.
pred_test = (test
             .rename(columns={"price":"factual_price"})
             .assign(jk = 1)
             .reset_index() # create day ID
             .merge(pd.DataFrame(dict(jk=1, price=np.linspace(3, 10, 9))), on="jk")
             .drop(columns=["jk"]))

pred_test.query("index==0")| index | temp | weekday | cost | factual_price | sales | price | |
|---|---|---|---|---|---|---|---|
| 0 | 0 | 25.8 | 1 | 0.3 | 7 | 230 | 3.000 |
| 1 | 0 | 25.8 | 1 | 0.3 | 7 | 230 | 3.875 |
| 2 | 0 | 25.8 | 1 | 0.3 | 7 | 230 | 4.750 |
| 3 | 0 | 25.8 | 1 | 0.3 | 7 | 230 | 5.625 |
| 4 | 0 | 25.8 | 1 | 0.3 | 7 | 230 | 6.500 |
| 5 | 0 | 25.8 | 1 | 0.3 | 7 | 230 | 7.375 |
| 6 | 0 | 25.8 | 1 | 0.3 | 7 | 230 | 8.250 |
| 7 | 0 | 25.8 | 1 | 0.3 | 7 | 230 | 9.125 |
| 8 | 0 | 25.8 | 1 | 0.3 | 7 | 230 | 10.000 |
인덱스 0인 날, 즉 분석단위 하나만 보여 주고 있다는 점에 주목하세요. 그날(분석단위)의 실제 가격, 즉 사실적 처치는 7이었습니다. 하지만 3부터 10까지 여러 반사실적 처치를 시뮬레이션했습니다. 이제 이 반사실적 가격을 모두 인과 모델에 넣으면, 모델이 시뮬레이션한 가격을 바탕으로 반사실적 판매량을 예측합니다.
모델은 다음과 같은 형태이므로
\[ \widehat{Price_i} = \hat{\tau}(X_i, \tilde{T}_i) \]
반사실 예측을 하기 전에 \(\tilde{T}_i\), 즉 가격의 잔차를 구해야 합니다. 이 잔차는 다음과 같이 구합니다. 먼저 처치 모델 전부로 예측합니다(훈련 단계에서 5-폴드 교차 예측을 썼다는 점을 떠올려 보세요). 그다음 다섯 모델의 예측을 평균해 예측값 하나로 만들고, 마지막으로 이 모델 앙상블로 예측한 가격에서 앞서 만든 반사실적 가격을 뺍니다.
원문은 ’인덱스 1인 날’이라고 적었지만 위 코드는 query("index==0")으로 인덱스 0인 날을 보여 주므로 바로잡았습니다. 위 모델 식의 좌변도 문맥상 가격이 아니라 판매량의 예측값입니다. 또 코드(pred_test[T] - ensamble_pred(...))는 본문 설명과 반대로 반사실적 가격에서 예측한 가격을 뺍니다. 뺄셈 방향을 설명한 본문과 수식은 원문대로 두었습니다.
def ensamble_pred(df, models, X):
    return np.mean([m.predict(df[X]) for m in models], axis=0)

t_res_test = pred_test[T] - ensamble_pred(pred_test, models_t, X)

pred_test[f"{y}_pred"] = model_final.predict(X=pred_test[X].assign(**{T: t_res_test}))

pred_test.query("index==0")| index | temp | weekday | cost | factual_price | sales | price | sales_pred | |
|---|---|---|---|---|---|---|---|---|
| 0 | 0 | 25.8 | 1 | 0.3 | 7 | 230 | 3.000 | 24.302849 |
| 1 | 0 | 25.8 | 1 | 0.3 | 7 | 230 | 3.875 | 20.862833 |
| 2 | 0 | 25.8 | 1 | 0.3 | 7 | 230 | 4.750 | 16.093630 |
| 3 | 0 | 25.8 | 1 | 0.3 | 7 | 230 | 5.625 | 6.274595 |
| 4 | 0 | 25.8 | 1 | 0.3 | 7 | 230 | 6.500 | -1.624625 |
| 5 | 0 | 25.8 | 1 | 0.3 | 7 | 230 | 7.375 | -10.939867 |
| 6 | 0 | 25.8 | 1 | 0.3 | 7 | 230 | 8.250 | -21.655858 |
| 7 | 0 | 25.8 | 1 | 0.3 | 7 | 230 | 9.125 | -25.319174 |
| 8 | 0 | 25.8 | 1 | 0.3 | 7 | 230 | 10.000 | -25.319174 |
보다시피 이제 시뮬레이션한 가격마다 판매량 예측값이 있습니다. 가격이 낮을수록 판매량이 높습니다. 흥미로운 점은 예측값의 수준이 어긋나 있다는 것입니다. 예를 들어 약 24에서 약 -24까지 걸쳐 있습니다. 모델이 평균이 대략 0인 잔차화한 결과를 예측하기 때문입니다. 가격의 처치효과, 즉 판매량 곡선의 기울기만 알고 싶다면 이대로도 괜찮습니다. 예측값의 수준까지 바로잡고 싶다면 잡음 제거 모델 \(M_y\)의 예측값을 더하기만 하면 됩니다.
y_hat_test = ensamble_pred(pred_test, models_y, X)
pred_test[f"{y}_pred"] = (y_hat_test +
                          model_final.predict(X=pred_test[X].assign(**{T: t_res_test})))

pred_test.query("index==0")| index | temp | weekday | cost | factual_price | sales | price | sales_pred | |
|---|---|---|---|---|---|---|---|---|
| 0 | 0 | 25.8 | 1 | 0.3 | 7 | 230 | 3.000 | 254.208352 |
| 1 | 0 | 25.8 | 1 | 0.3 | 7 | 230 | 3.875 | 250.768336 |
| 2 | 0 | 25.8 | 1 | 0.3 | 7 | 230 | 4.750 | 245.999133 |
| 3 | 0 | 25.8 | 1 | 0.3 | 7 | 230 | 5.625 | 236.180099 |
| 4 | 0 | 25.8 | 1 | 0.3 | 7 | 230 | 6.500 | 228.280878 |
| 5 | 0 | 25.8 | 1 | 0.3 | 7 | 230 | 7.375 | 218.965636 |
| 6 | 0 | 25.8 | 1 | 0.3 | 7 | 230 | 8.250 | 208.249645 |
| 7 | 0 | 25.8 | 1 | 0.3 | 7 | 230 | 9.125 | 204.586329 |
| 8 | 0 | 25.8 | 1 | 0.3 | 7 | 230 | 10.000 | 204.586329 |
분석단위별 판매량 곡선도 그려 볼 수 있습니다. 분석단위 열 개를 표본으로 뽑아 가격에 따라 어떻게 반응하는지 보겠습니다.
np.random.seed(1)
sample_ids = np.random.choice(pred_test["index"].unique(), 10)

sns.lineplot(data=pred_test.query("index in @sample_ids"),
             x="price", y="sales_pred", hue="index");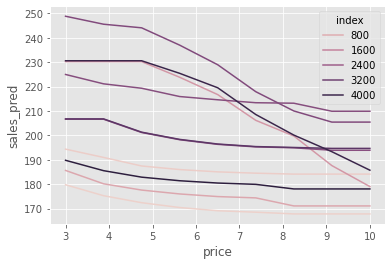
일부 분석단위는 가격 인상에 아주 민감하다는 점이 흥미롭습니다. 어떤 경우에는 가격을 3에서 10으로 올리면 판매량이 250에서 200 가까이 떨어질 것으로 예상됩니다. 반면 가격에 아주 비탄력적인 분석단위도 있습니다. 가격을 3에서 10으로 올려도 판매량은 약 195에서 약 185로 줄어들 뿐입니다.
이런 가격 민감도 차이는 한눈에 보기 어렵습니다. 그래서 저는 모든 곡선이 같은 지점(여기서는 평균 판매량)에서 시작하도록 맞추는 편입니다. 이렇게 하면 가격을 올릴 때 판매량이 가파르게 떨어지는 분석단위와 그렇지 않은 분석단위를 더 쉽게 구분할 수 있습니다.
np.random.seed(1)
sample_ids = np.random.choice(pred_test["index"].unique(), 10)

sns.lineplot(data=(pred_test
                   .query("index in @sample_ids")
                   .assign(max_sales = lambda d: d.groupby("index")[["sales_pred"]].transform("max"))
                   .assign(sales_pred = lambda d: d["sales_pred"] - d["max_sales"] + d["sales_pred"].mean())),
             x="price", y="sales_pred", hue="index");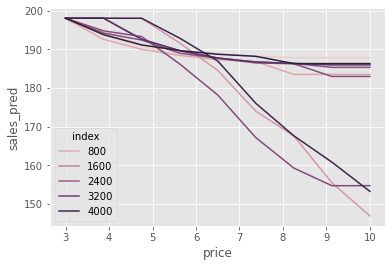
비과학적 이중 머신러닝에 관한 이 절은 주의 사항으로 마무리하겠습니다. 괜히 이 방법을 비과학적이라고 부른 게 아닙니다. 비선형 반사실 예측을 얻기 위한 일종의 편법입니다. 그리고 편법인 만큼 잠재적인 단점을 짚어 둘 필요가 있습니다.
무엇보다도, 머신러닝 기법을 인과추론에 아무 고민 없이 적용할 때 늘 생기는 문제, 즉 편향을 이 방법도 똑같이 안고 있습니다. 최종 모델이 정규화된 머신러닝 모델이므로, 그 정규화 때문에 인과 추정값이 0 쪽으로 편향될 수 있습니다.
두 번째 문제는 어떤 머신러닝 알고리즘을 고르느냐와 관련이 있습니다. 여기서는 부스팅 트리를 골랐습니다. 트리는 매끄러운 예측에 그리 능하지 않습니다. 그 결과 예측 곡선에 불연속 구간이 생길 수 있습니다. 위 그래프에서도 군데군데 계단처럼 꺾이는 모습이 보입니다. 또 트리는 외삽에도 그리 능하지 않아서, 이 모델은 한 번도 본 적 없는 가격에서는 이상한 예측값을 내놓을 수 있습니다.
pred_test = (test
             .rename(columns={"price":"factual_price"})
             .assign(jk = 1)
             .reset_index() # create day ID
             .merge(pd.DataFrame(dict(jk=1, price=np.linspace(3, 30, 30))), on="jk")
             .drop(columns=["jk"]))

t_res_test = pred_test[T] - ensamble_pred(pred_test, models_t, X)

y_hat_test = ensamble_pred(pred_test, models_y, X)
pred_test[f"{y}_pred"] = model_final.predict(X=pred_test[X].assign(**{T: t_res_test})) + y_hat_test

np.random.seed(1)
sample_ids = np.random.choice(pred_test["index"].unique(), 10)

sns.lineplot(data=(pred_test
                   .query("index in @sample_ids")
                   .assign(max_sales = lambda d: d.groupby("index")[["sales_pred"]].transform("max"))
                   .assign(sales_pred = lambda d: d["sales_pred"] - d["max_sales"] + d["sales_pred"].mean())),
             x="price", y="sales_pred", hue="index");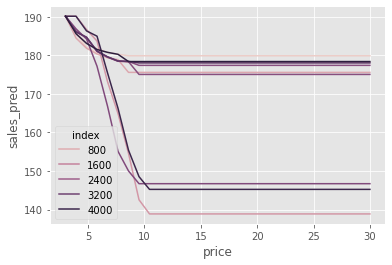
결국 이 방법은 최종 머신러닝 모델에 크게 좌우된다는 이야기입니다. 정규화를 너무 세게 하면 인과 추정값이 0 쪽으로 편향됩니다. 어떤 머신러닝 알고리즘을 쓰든 그 알고리즘의 한계가 최종 반사실 예측에 고스란히 따라옵니다. 그래도 해 볼 만한 방법이라고 생각한다면 얼마든지 시도해 보세요! 다만 여기서 짚은 단점은 잊지 마세요.
이중/편향 제거/직교화 머신러닝은 장애모수 추정을 머신러닝에 맡겨서, 관심 있는 인과 매개변수에만 집중할 수 있게 해 주는 방법입니다. 이 방법은 먼저 두 단계의 직교화 절차를 거칩니다.
공변량 X로 처치를 예측하는 모델 \(M_t(X)\)를 적합하고 아웃 오브 폴드 잔차 \(\tilde{t} = t - M_t(X)\)를 구합니다. 잔차 \(\tilde{t}\)는 정의상 이를 만드는 데 쓴 특성과 직교하므로, 이 모델을 편향 제거 모델이라고 불렀습니다.
공변량 X로 결과를 예측하는 모델 \(M_y(X)\)를 적합하고 아웃 오브 폴드 잔차 \(\tilde{y} = y - M_y(X)\)를 구합니다. 잔차 \(\tilde{y}\)는 특성에서 오는 분산을 모두 설명해 없앤 결과로 볼 수 있으므로, 이 모델을 잡음 제거 모델이라고 불렀습니다.
이 잔차를 구하고 나면, 측정되지 않은 교란 요인이 없다는 전제하에 \(\tilde{y}\)를 \(\tilde{t}\)에 회귀해 ATE의 선형 근사를 얻을 수 있습니다. 또한 \(\tilde{t}\)와 공변량의 상호작용을 넣어 CATE를 추정하거나, 가중치 트릭을 써서 어떤 범용 머신러닝 모델이든 최종 CATE 모델로 쓸 수 있습니다.
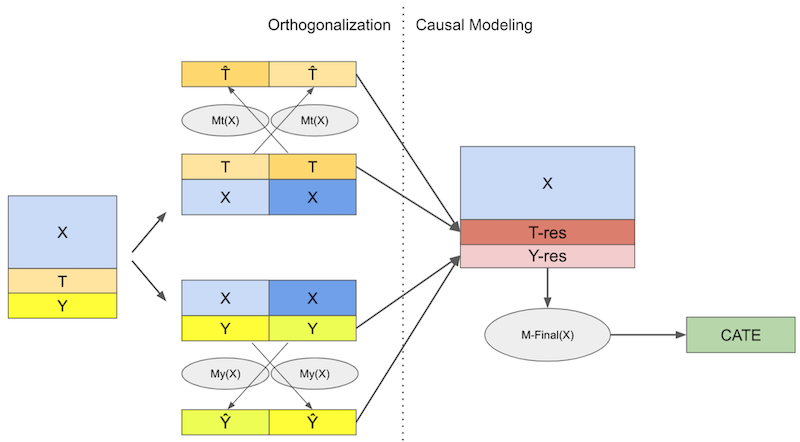
마지막으로, 저는 직교화 단계가 인과 학습을 돕는 범용 도구라고 주장했습니다. 그런 취지에서 처치와 결과의 잔차를 S 러너 방식의 머신러닝 알고리즘에 넣어 보았고, 그 결과 시뮬레이션한 처치에 대한 반사실 예측을 얻을 수 있었습니다. 실제로 직교화 머신러닝은 많은 인과추론 응용에서 전처리 단계로 쓰입니다.
여기 쓴 내용은 대부분 제 머릿속에서 나온 것으로, 경험을 통해 배운 것들입니다. 즉, 좋은 과학이 보통 거치는 학계의 검증을 통과하지 않았습니다. 실제로 잘 통하는 것들을 이야기하면서도 왜 그런지는 그다지 설명하지 않았다는 점을 눈치챘을 겁니다. 말하자면 길거리 과학인 셈입니다. 그래도 이 글을 공개해 누구나 검토할 수 있게 해 두었으니, 터무니없는 내용을 발견하면 언제든 이슈를 열어 주세요. 최선을 다해 답하겠습니다.
이 장을 쓰면서 Chernozhukov et al (2016), Double/Debiased Machine Learning for Treatment and Causal Parameters, D. Foster and V. Syrgkanis (2019) Orthogonal Statistical Learning, 그리고 econml 라이브러리 문서를 참고했습니다. 직교화 머신러닝은 요즘 큰 관심을 받고 있어서 이 밖에도 참고 자료가 많습니다. 몇 가지만 꼽자면 Nie and Wager (Draft, 2020)는 R 손실을 잘 설명하고, Athey et al (2019)는 인과 의사결정 나무의 맥락에서 이를 다루며, Chernozhukov가 이 주제를 더 발전시킨 후속 논문도 여럿 있습니다.
Pedro Sant’Anna의 슬라이드에서 이미지 하나를 슬쩍 가져오기도 했습니다.
Causal Inference for the Brave and True는 과학의 통계학이라 할 수 있는 인과추론을 다루는 오픈소스 자료입니다. 파이썬 기반의 무료 소프트웨어만 사용하며, 돈이 없어도, 배경지식이 많지 않아도 누구나 볼 수 있는 자료를 목표로 합니다. 이 책이 도움이 되었고 후원하고 싶다면 Patreon을 방문해 주세요. 금전적으로 기여하기 어렵다면 오타를 고치거나, 수정할 부분을 제안하거나, 이해하기 어려웠던 부분에 의견을 주는 것으로도 도울 수 있습니다. 책의 저장소에서 이슈를 열어 주세요. 마지막으로 이 내용이 마음에 들었다면 도움이 될 만한 사람들과 공유하고 GitHub에서 스타를 눌러 주세요.
한국어판의 오역이나 오탈자는 한국어판 이슈 페이지에 알려 주세요. 한국어판이 도움이 되었다면 한국어판 저장소에도 스타를 부탁드립니다.
의견 나누기
번역이 어색한 곳, 더 쉬운 설명, 궁금한 점을 남겨 주세요. GitHub 계정으로 로그인하면 댓글을 달 수 있고, 남긴 의견은 GitHub Discussions에 장별로 모입니다.