이중차분법(DID)을 다룰 때는 포르투알레그리(Porto Alegre)와 플로리아노폴리스(Florianopolis) 두 도시의 고객 데이터가 여러 건 있었습니다. 데이터는 두 기간, 즉 고객 예금을 늘리려고 포르투알레그리에서 마케팅 개입(intervention)을 하기 전과 후에 걸쳐 있었습니다. 처치효과(treatment effect)를 추정하기 위해 회귀분석을 돌려 DID 추정량과 그 표준오차를 구했습니다.
그때는 데이터가 고객 단위로 쪼개져 있었기 때문에 표본이 많았습니다. 그런데 도시 수준으로 집계된 데이터밖에 없다면 어떻게 될까요? 예를 들어 개입 전후 두 도시의 평균 예금액만 있다고 해 봅시다.
하지만 여기서 표본 크기는 4이고, 이는 DID 모델의 매개변수 개수와 같습니다. 이러면 표준오차를 제대로 정의할 수 없는데, 어떻게 해야 할까요? 또 다른 문제는 플로리아노폴리스가 기대만큼 포르투알레그리와 비슷하지 않을 수 있다는 점입니다. 플로리아노폴리스는 아름다운 해변과 느긋한 사람들로 유명하지만, 포르투알레그리는 바비큐와 대초원으로 더 알려져 있습니다. 결국 적절한 대조군(control group)을 쓰고 있는지 결코 확신할 수 없다는 것이 문제입니다.
이 문제를 피해 가기 위해 “최근 몇 년간 정책 평가 문헌에서 나온 가장 중요한 혁신”이라 불리는 통제집단합성법(synthetic control)을 사용하겠습니다. 통제집단합성법은 단순하지만 강력한 아이디어에 기반합니다. 처치받지 않은 대상(unit) 가운데 처치받은 대상과 아주 비슷한 하나를 찾아낼 필요가 없습니다. 대신 처치받지 않은 여러 대상을 조합해 비교 대상을 직접 만들어 내면 됩니다. 이렇게 만든 것이 사실상 가상의 대조군(synthetic control)입니다. 통제집단합성법은 효과적이면서도 직관적이어서, 과학 학술지가 아니라 워싱턴 포스트에 기사가 실리기까지 했습니다.
코드
import warningswarnings.filterwarnings('ignore')import pandas as pdimport numpy as npfrom matplotlib import stylefrom matplotlib import pyplot as pltimport seaborn as snsimport statsmodels.formula.api as smf%matplotlib inlinepd.set_option("display.max_columns", 6)style.use("fivethirtyeight")
실제로 어떻게 작동하는지 보기 위해, 담배세가 담배 소비에 미치는 효과를 추정하는 문제를 생각해 봅시다. 배경을 조금 설명하자면, 이 질문은 경제학에서 오랫동안 논쟁거리였습니다. 한쪽은 세금이 담배 가격을 올리고, 그 결과 수요가 줄어든다고 주장합니다. 다른 쪽은 담배에는 중독성이 있으니 가격이 바뀌어도 수요는 크게 변하지 않는다고 주장합니다. 경제학 용어로 말하면 담배 수요는 가격에 비탄력적이고, 세금 인상은 흡연자에게 부담을 지워 정부 수입을 늘리는 수단일 뿐이라는 얘기입니다. 결론을 내기 위해 이 문제에 관한 미국 데이터를 살펴보겠습니다.
1988년 캘리포니아는 발의안 99호(Proposition 99)로 알려진 유명한 담배세 및 건강보호법(Tobacco Tax and Health Protection Act)을 통과시켰습니다. “이 법의 주된 효과는 캘리포니아 내 궐련 판매에 한 갑당 25센트의 주 소비세를 부과하고, 시가나 씹는 담배 같은 다른 상업용 담배 제품의 소매 판매에도 그와 거의 같은 수준의 소비세를 부과하는 것입니다. 담배 판매에 대한 추가 규제로는 청소년이 출입할 수 있는 공공장소의 담배 자판기 금지와 낱개 담배 판매 금지가 있습니다. 이 법으로 거둔 세수는 여러 환경·보건 프로그램과 금연 광고에 쓰도록 지정되었습니다.”
그 효과를 평가하려면 여러 주에서 여러 해에 걸친 담배 판매 데이터를 모으면 됩니다. 여기서는 39개 주의 1970년부터 2000년까지 데이터를 구했습니다. 비슷한 담배 규제 프로그램을 시행한 다른 주들은 분석에서 제외했습니다. 데이터는 다음과 같습니다.
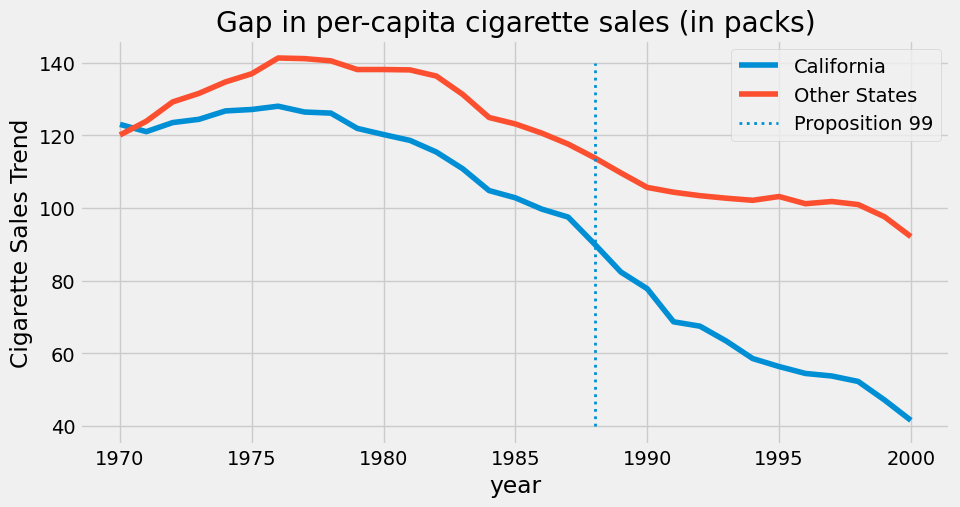
state는 주를 나타내는 인덱스이고, 캘리포니아는 3번입니다. 공변량(covariate)은 담배 소매가격인 retprice와 1인당 담배 판매량(갑 단위)인 cigsale입니다. 관심 있는 결과변수(outcome variable)는 cigsale입니다. 마지막으로 캘리포니아 주인지, 개입 이후 기간인지를 나타내는 불리언 보조 변수가 있습니다. 캘리포니아와 다른 주의 담배 판매량을 시간에 따라 그려 보면 다음과 같습니다.
데이터가 있는 기간 내내 캘리포니아 사람들은 전국 평균보다 담배를 덜 산 것으로 보입니다. 또 80년대 이후로는 담배 소비가 줄어드는 흐름이 나타납니다. 발의안 99호 이후 캘리포니아의 감소 추세가 다른 주보다 빨라진 것 같지만, 확실하다고 말할 수는 없습니다. 그래프를 보고 짐작한 것일 뿐입니다.
발의안 99호가 담배 소비에 효과가 있었는지 답하기 위해, 개입 전 기간의 데이터로 가상의 대조군을 만들겠습니다. 다른 주들을 조합해 캘리포니아의 추세와 아주 비슷하게 움직이는 가짜 주를 만드는 것입니다. 그런 다음 이 가상의 대조군이 개입 이후에 어떻게 움직이는지 보겠습니다.
우리에겐 시간이 있다
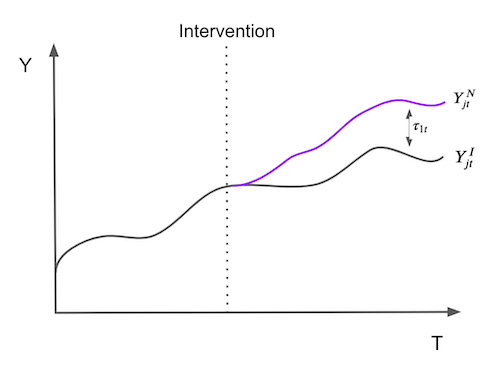
조금 더 엄밀하게 정리해 보겠습니다. \(J+1\)개의 대상이 있다고 합시다. 일반성을 잃지 않고 대상 1이 개입의 영향을 받는 대상이라고 가정합니다. 대상 \(j=2,...,J+1\)은 처치받지 않은 대상들의 모음이고, 이를 “도너 풀(donor pool)”이라고 부르겠습니다. 또 데이터는 T개 기간에 걸쳐 있고, 그중 \(T_0\)개 기간이 개입 전이라고 가정합니다. 각 대상 j와 각 시점 t마다 결과 \(Y_{jt}\)를 관측합니다. 각 대상 j와 기간 t에 대해 개입이 없을 때의 잠재적 결과(potential outcome)를 \(Y^N_{jt}\), 개입이 있을 때의 잠재적 결과를 \(Y^I_{jt}\)로 정의합니다. 그러면 시점 t(\(t>T_0\))에서 처치받은 대상 \(j=1\)의 효과는 다음과 같이 정의합니다.
\[
\tau_{1t} = Y^I_{1t} - Y^N_{1t}
\]
대상 \(j=1\)은 처치를 받았으므로 \(Y^I_{1t}\)는 사실적 결과(factual outcome)지만 \(Y^N_{1t}\)는 그렇지 않습니다. 따라서 과제는 \(Y^N_{1t}\)를 어떻게 추정하느냐가 됩니다. 처치효과가 기간마다 정의된다는 점에 주목하세요. 즉, 처치효과는 시간에 따라 달라질 수 있습니다. 즉각 나타날 필요가 없고, 누적되거나 사그라들 수도 있습니다. 그림으로 표현하면, 처치효과를 추정하는 문제는 결국 대상 \(j=1\)이 처치받지 않았다면 결과가 어떻게 되었을지를 추정하는 문제로 귀결됩니다.
\(Y^N_{1t}\)를 추정할 때 떠올릴 점은, 처치받지 않은 대상 하나만 쓰기보다 도너 풀의 대상들을 조합하는 편이 처치받은 대상의 특성을 훨씬 잘 근사한다는 것입니다. 그래서 가상의 대조군은 대조군 풀(control pool)에 속한 대상들의 가중평균으로 정의합니다. 가중치 \(\pmb{W}=(w_2, ..., w_{J+1})\)가 주어지면 \(Y^N_{1t}\)에 대한 가상의 대조군 추정값은 다음과 같습니다.
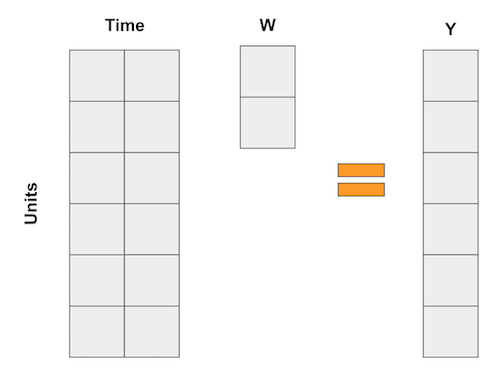
수식 때문에 머리가 아프다면 혼자만 그런 게 아닙니다. 하지만 걱정하지 마세요. 직관적으로 이해하도록 도와줄 예제가 많이 있습니다. 우선 저는 통제집단합성법을 회귀분석을 거꾸로 뒤집어 하는 방법이라고 생각하는 편입니다. 알다시피 선형회귀도 변수들의 가중평균으로 예측값을 구하는 방법입니다. 이제 이중차분법 예제처럼 각 변수가 특정 기간을 나타내는 더미변수인 회귀분석을 떠올려 보세요. 이 경우 회귀분석은 다음과 같은 행렬 곱으로 나타낼 수 있습니다.
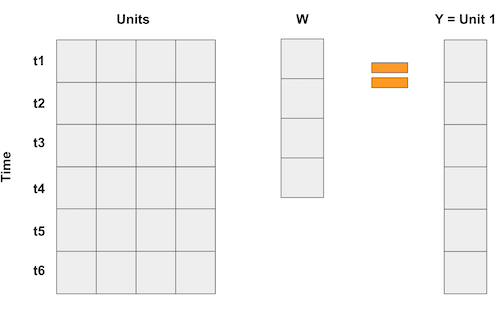
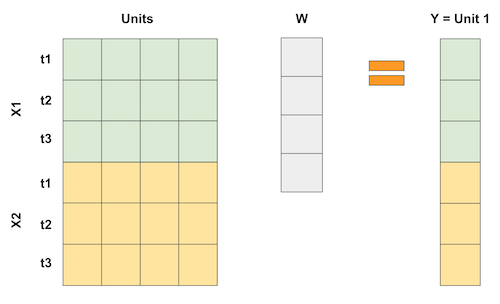
통제집단합성법에서는 대상이 많지 않은 대신 기간이 많습니다. 그래서 입력 행렬을 뒤집습니다. 그러면 대상이 “변수”가 되고, 아래 행렬 곱처럼 결과를 대상들의 가중평균으로 나타내게 됩니다.
기간마다 특성(feature)이 둘 이상이면 아래처럼 특성을 쌓아 올리면 됩니다. 중요한 것은 회귀분석이 다른 대상들을 이용해 처치받은 대상 1을 “예측”하도록 만드는 것입니다. 이렇게 하면 원하는 만큼 가까워지도록 가중치를 최적의 방식으로 고를 수 있습니다. 특성마다 척도를 다르게 조정해 중요도를 달리 줄 수도 있습니다.
그렇다면 통제집단합성법을 선형회귀로 볼 수 있다는 건, 가중치를 최소제곱법(OLS)으로 추정할 수 있다는 뜻이기도 하겠죠? 맞습니다! 지금 바로 해 보겠습니다.
선형회귀로 보는 통제집단합성법
통제집단합성법으로 처치효과를 추정하기 위해, 개입 전 기간에 처치받은 대상과 닮은 “가짜 대상”을 만들어 보겠습니다. 그런 다음 이 “가짜 대상”이 개입 이후에 어떻게 움직이는지 봅니다. 가상의 대조군과 그것이 흉내 내는 대상 사이의 차이가 바로 처치효과입니다.
선형회귀로 이를 하려면 OLS로 가중치를 구하면 됩니다. 개입 전 기간에 도너 풀 대상들의 가중평균과 처치받은 대상 사이의 거리 제곱을 최소화하는 것입니다.
그러려면 먼저 대상(여기서는 주)을 열로, 시간을 행으로 바꿔야 합니다. 특성이 cigsale과 retprice 두 개이므로, 위 그림처럼 위아래로 쌓겠습니다. 개입 전 기간에 캘리포니아와 아주 비슷한 가상의 대조군을 만들고, 그것이 개입 후 기간에 어떻게 움직였을지 보려는 것입니다. 그러니 개입 전 기간만 골라내는 것이 중요합니다. 여기서는 두 특성의 척도가 비슷해 보이므로 따로 손대지 않겠습니다. 하나는 수천 단위이고 다른 하나는 소수점 단위인 것처럼 특성의 척도가 서로 다르면, 차이를 최소화할 때 값이 큰 특성이 가장 중요해집니다. 이를 막으려면 먼저 척도를 맞춰 두어야 합니다.
코드
features = ["cigsale", "retprice"]inverted = (cigar.query("~after_treatment") # filter pre-intervention period .pivot(index='state', columns="year")[features] # make one column per year and one row per state .T) # flip the table to have one column per stateinverted.head()
state
1
2
3
...
37
38
39
year
cigsale
1970
89.800003
100.300003
123.000000
...
114.500000
106.400002
132.199997
1971
95.400002
104.099998
121.000000
...
111.500000
105.400002
131.699997
1972
101.099998
103.900002
123.500000
...
117.500000
108.800003
140.000000
1973
102.900002
108.000000
124.400002
...
116.599998
109.500000
141.199997
1974
108.199997
109.699997
126.699997
...
119.900002
111.800003
145.800003
5 rows × 39 columns
이제 Y 변수를 캘리포니아 주로, X를 나머지 주들로 정의합니다.
코드
y = inverted[3].values # state of californiaX = inverted.drop(columns=3).values # other states
그다음 회귀분석을 실행합니다. 절편을 넣는 것은 모든 행이 1인 주를 하나 더 추가하는 것과 같습니다. 그렇게 해도 되지만 더 복잡해지는 것 같아서 여기서는 빼겠습니다. 회귀분석은 처치받은 대상과 도너 풀 대상들 사이의 차이 제곱을 최소화하는 가중치를 돌려줍니다.
코드
from sklearn.linear_model import LinearRegressionweights_lr = LinearRegression(fit_intercept=False).fit(X, y).coef_weights_lr.round(3)
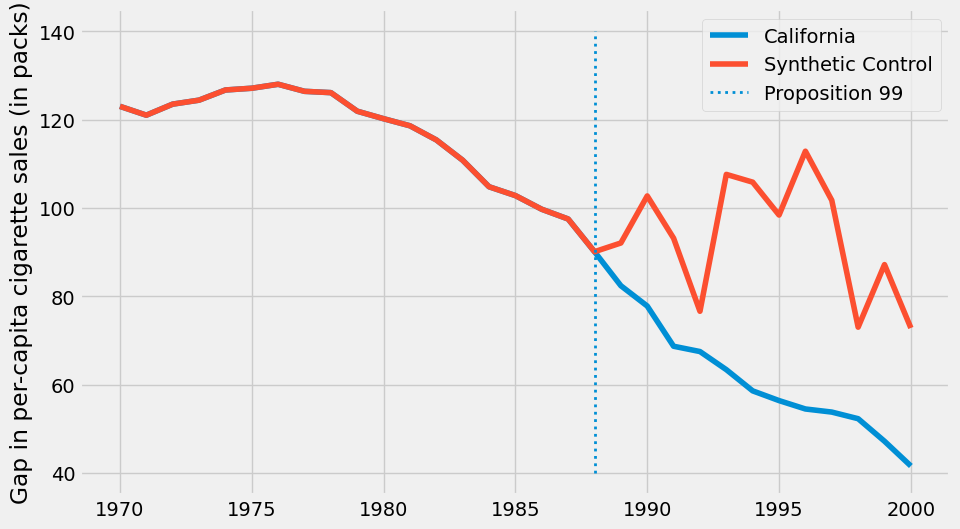
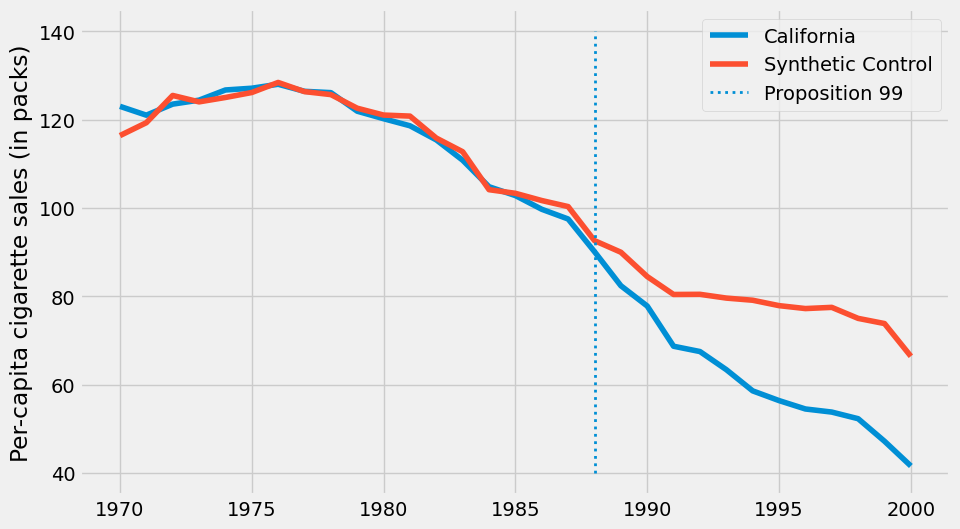
plt.figure(figsize=(10,6))plt.plot(cigar.query("california")["year"], cigar.query("california")["cigsale"], label="California")plt.plot(cigar.query("california")["year"], calif_synth_lr, label="Synthetic Control")plt.vlines(x=1988, ymin=40, ymax=140, linestyle=":", lw=2, label="Proposition 99")plt.ylabel("Gap in per-capita cigarette sales (in packs)")plt.legend();
음… 뭔가 이상합니다. 이 그림에서 무엇이 눈에 띄나요? 첫째, 개입 이후에는 가상의 대조군이 캘리포니아보다 담배 판매량이 많습니다. 개입이 담배 수요를 줄이는 데 성공했다는 신호입니다. 둘째, 개입 전 기간이 완벽하게 들어맞는다는 점을 보세요. 가상의 대조군이 캘리포니아 주와 정확히 일치합니다. 이는 통제집단합성법 모델이 데이터에 과적합(overfitting)되었을 가능성이 높다는 신호입니다. 개입 이후 가상의 대조군에서 결과변수의 분산이 아주 크다는 점도 또 다른 신호입니다. 매끄러운 패턴을 따르지 않고 오르락내리락을 반복하는 모습을 보세요.
왜 이런 일이 생기는지 생각해 보려면 도너 풀에 주가 38개나 있다는 점을 떠올려 보세요. 즉, 선형회귀에는 처치 전 기간의 도너 풀을 처치받은 대상에 최대한 가깝게 맞추려고 마음껏 주무를 수 있는 매개변수가 38개나 있습니다. T가 크더라도 N 역시 큰 경우라서, 선형회귀 모델에 지나치게 많은 자유가 주어지는 셈입니다. 정규화 모델에 익숙하다면 릿지(Ridge)나 라쏘(Lasso) 회귀로 이 문제를 해결할 수 있다는 점을 알아 두세요. 여기서는 과적합을 피하는 좀 더 전통적인 다른 방법을 살펴보겠습니다.
외삽하지 마라
아래 표 같은 데이터가 있고, 대조 대상들의 어떤 선형결합이든 써서 처치받은 대상을 재현하는 가상의 대조군을 만들라는 요청을 받았다고 해 봅시다.
대상
판매량
가격
대조 1
8
8
대조 2
8
4
대조 3
4
5
처치받은 대상
2
10
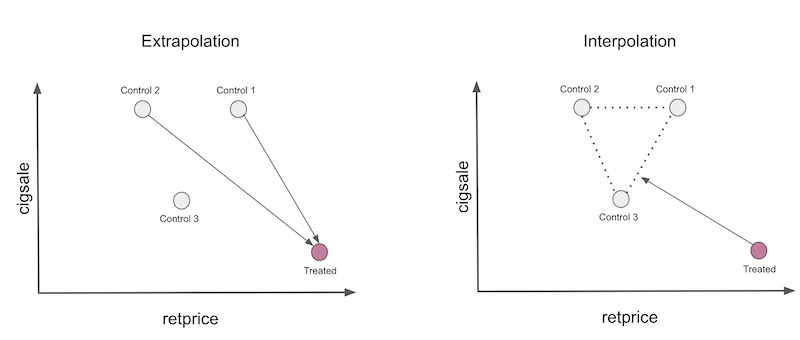
대상은 3개인데 맞춰야 할 속성은 2개뿐이므로 이 문제에는 정확한 해가 여러 개 있습니다. 그중 깔끔한 해는 첫 번째 대조 대상에 2.25를, 두 번째에 -2를 곱해 더하는 것입니다. 두 번째 곱셈이 판매량 -16, 가격 -8인 가짜 대상을 만든다는 점에 주목하세요. 이 곱셈은 대조 2를 데이터상 별 의미가 없는 영역으로 외삽(extrapolation)합니다. 가격과 판매량이 음수인 경우는 거의 있을 수 없기 때문입니다. 첫 번째 곱셈도 외삽입니다. 첫 번째 대상을 판매량과 가격이 18인 영역으로 데려가기 때문입니다. 이 숫자는 데이터에 있는 어떤 값보다도 훨씬 크므로 외삽에 해당합니다.
회귀분석에 가상의 대조군을 만들라고 하면 바로 이런 일을 합니다. 외삽이 기술적으로 틀린 것은 아니지만 실무에서는 위험합니다. 한 번도 보지 못한 데이터가 지금 가진 데이터처럼 움직인다고 가정하는 셈이기 때문입니다.
좀 더 안전하게 가는 방법은 가상의 대조군이 내삽(interpolation)만 하도록 제한하는 것입니다. 이를 위해 가중치가 양수이고 합이 1이 되도록 제약을 겁니다. 그러면 가상의 대조군은 도너 풀 대상들의 볼록 조합(convex combination)이 됩니다. 내삽을 하면 아래 그림처럼 처치받은 대상을 처치받지 않은 대상들이 정의하는 볼록 껍질(convex hull) 위로 투영하게 됩니다.
여기서 두 가지를 눈여겨보세요. 첫째, 이 예에서는 내삽으로 처치받은 대상을 완벽하게 재현할 수 없습니다. 처치받은 대상이 판매량은 가장 적고 가격은 가장 높기 때문입니다. 볼록 조합은 대조 대상들 사이에 놓인 특성값만 정확히 재현할 수 있습니다. 둘째, 내삽은 희소(sparse)합니다. 처치받은 대상을 볼록 껍질의 한 면에 투영하게 되는데, 이 면은 소수의 대상만으로 정의됩니다. 그래서 내삽을 하면 많은 대상의 가중치가 0이 됩니다.
여기까지가 기본 아이디어입니다. 이제 조금 더 엄밀하게 정리해 보겠습니다. 가상의 대조군은 여전히 다음과 같이 정의합니다.
이때 \(w_2, ..., w_{J+1}\)은 양수이고 합이 1이어야 한다는 제약이 붙습니다. \(v_h\)는 처치받은 대상과 가상의 대조군의 차이를 최소화할 때 각 변수의 중요도를 반영한다는 점에 주목하세요. \(v\)가 달라지면 최적 가중치도 달라집니다. \(V\)를 고르는 한 가지 방법은 각 변수의 평균이 0, 분산이 1이 되도록 하는 것입니다. 더 복잡한 방법은 \(Y\)를 더 잘 예측하는 변수일수록 중요도를 높게 주도록 \(V\)를 고르는 것입니다. 여기서는 코드를 단순하게 유지하기 위해 모든 변수에 똑같은 중요도를 주겠습니다.
가상의 대조군이 있으면 처치받은 대상과 가상의 대조군의 결과 차이로 처치효과를 추정할 수 있습니다.
\[
\tau_{1t} = Y^I_{jt} - Y^N_{jt}
\]
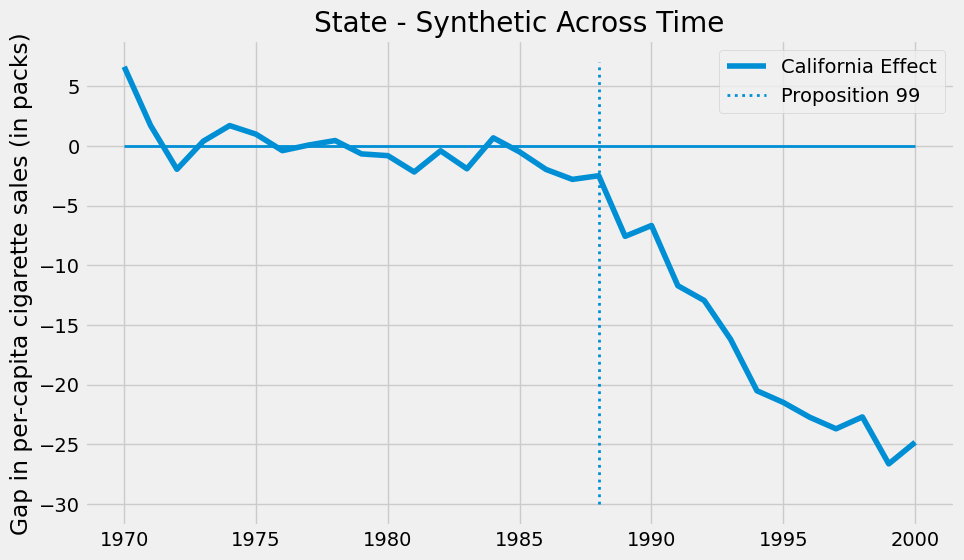
이 사례에서는 시간이 지날수록 효과가 점점 커집니다.
코드
plt.figure(figsize=(10,6))plt.plot(cigar.query("california")["year"], cigar.query("california")["cigsale"] - calif_synth, label="California Effect")plt.vlines(x=1988, ymin=-30, ymax=7, linestyle=":", lw=2, label="Proposition 99")plt.hlines(y=0, xmin=1970, xmax=2000, lw=2)plt.title("State - Synthetic Across Time")plt.ylabel("Gap in per-capita cigarette sales (in packs)")plt.legend();
2000년에 이르면 발의안 99호가 담배 판매량을 25갑 줄인 것으로 보입니다. 아주 멋진 결과지만, 이런 의문이 들 수도 있습니다. 이 결과가 통계적으로 유의한지는 어떻게 알 수 있을까요?
추론하기
표본 크기가 39로 아주 작으므로, 결과가 그저 운으로 나온 것이 아니라 통계적으로 유의한지 판단하려면 조금 더 영리하게 접근해야 합니다. 여기서는 피셔의 정확 검정(Fisher’s exact test) 아이디어를 쓰겠습니다. 직관은 아주 간단합니다. 실험군과 대조군을 가능한 모든 경우로 바꿔 배정해 봅니다. 처치받은 대상이 하나뿐이므로, 각 대상을 차례로 처치받은 대상이라고 치고 나머지는 대조군으로 두는 것입니다.
반복
1
2
…
39
1
처치
0
0
0
2
0
처치
0
0
…
0
0
0
0
39
0
0
0
처치
결국 주마다 가상의 대조군과 효과 추정값을 하나씩 얻게 됩니다. 이 방법은 처치가 캘리포니아가 아니라 다른 주에서 일어났다고 가정하고, 실제로는 일어나지 않은 그 처치의 효과가 얼마로 추정되었을지 보는 것입니다. 그다음 캘리포니아의 처치효과가 다른 가짜 처치들에 비해 충분히 큰지 확인합니다. 실제로 처치받지 않은 주는 처치받았다고 가정하더라도 유의한 처치효과가 나오지 않으리라는 것이 핵심 아이디어입니다.
이를 구현하기 위해 주를 입력받아 그 주의 가상의 대조군을 추정하는 함수를 만들었습니다. 이 함수는 주, 연도, 결과 cigsale, 그리고 그 주의 합성 결과를 각각 열로 갖는 데이터프레임을 반환합니다.
모든 주의 결과를 얻기 위해 계산을 8개 프로세스로 병렬화합니다. 컴퓨터의 코어 수가 이보다 많거나 적으면 다른 숫자를 써도 됩니다. 이 코드는 위와 같은 데이터프레임의 리스트를 반환합니다.
코드
from joblib import Parallel, delayedcontrol_pool = cigar["state"].unique()parallel_fn = delayed(partial(synthetic_control, data=cigar))synthetic_states = Parallel(n_jobs=8)(parallel_fn(state) for state in control_pool)
코드
synthetic_states[0].head()
state
year
cigsale
after_treatment
synthetic
0
1
1970
89.800003
False
95.029419
1
1
1971
95.400002
False
99.118199
2
1
1972
101.099998
False
101.881329
3
1
1973
102.900002
False
103.938655
4
1
1974
108.199997
False
107.038474
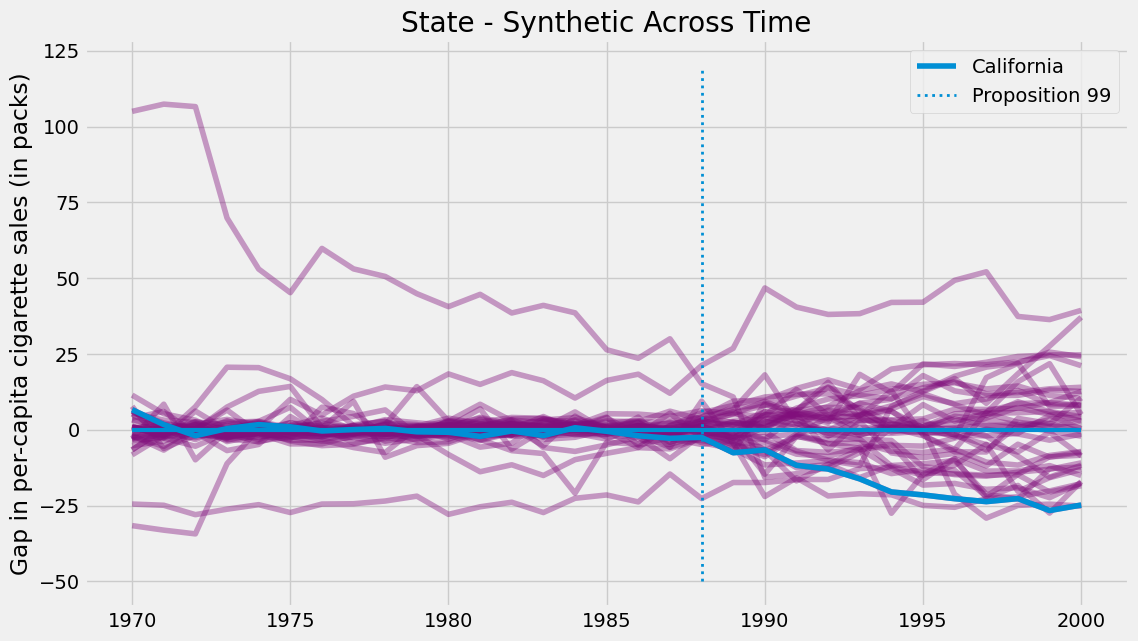
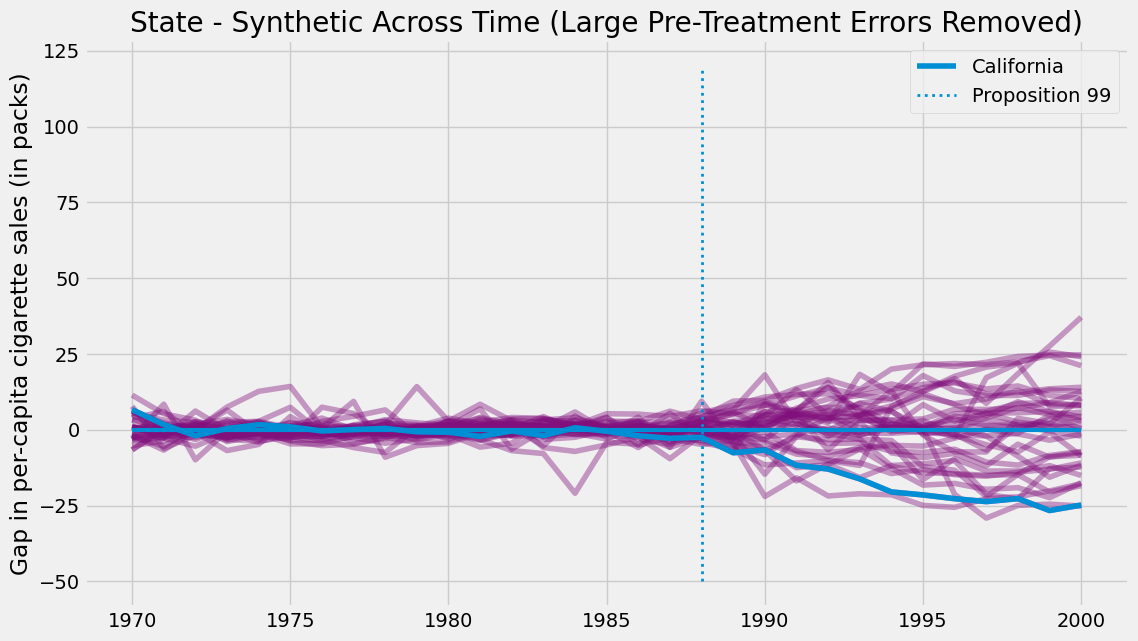
모든 주의 가상의 대조군을 구했으니, 모든 주에 대해 가상의 대조군과 실제 주 사이의 차이를 추정할 수 있습니다. 캘리포니아에서는 이 차이가 처치효과입니다. 다른 주에서는 위약 효과(placebo effect)와 비슷합니다. 처치가 실제로 일어나지 않은 곳에서 통제집단합성법으로 처치효과를 추정한 것이기 때문입니다. 모든 위약 효과를 캘리포니아의 처치효과와 함께 그리면 다음 그림이 나옵니다.
코드
plt.figure(figsize=(12,7))for state in synthetic_states: plt.plot(state["year"], state["cigsale"] - state["synthetic"], color="C5",alpha=0.4)plt.plot(cigar.query("california")["year"], cigar.query("california")["cigsale"] - calif_synth, label="California");plt.vlines(x=1988, ymin=-50, ymax=120, linestyle=":", lw=2, label="Proposition 99")plt.hlines(y=0, xmin=1970, xmax=2000, lw=3)plt.ylabel("Gap in per-capita cigarette sales (in packs)")plt.title("State - Synthetic Across Time")plt.legend();
이 그림에서 두 가지가 눈에 띕니다. 첫째, 개입 후의 분산이 개입 전보다 큽니다. 가상의 대조군은 개입 전 기간의 차이를 최소화하도록 설계되었으므로 예상할 수 있는 결과입니다. 또 하나 흥미로운 점은 개입 전 기간에도 잘 맞추지 못하는 대상이 있다는 것입니다. 이것 역시 예상할 수 있습니다. 예를 들어 담배 소비량이 아주 많은 주가 있다면, 다른 주들을 어떻게 볼록 조합하더라도 그 주와 맞출 수 없습니다.
이런 대상들은 적합이 매우 나쁘므로 분석에서 빼는 것이 좋습니다. 객관적으로 빼는 한 가지 방법은 개입 전 오차에 임곗값(threshold)을 정하고
def pre_treatment_error(state): pre_treat_error = (state.query("~after_treatment")["cigsale"] - state.query("~after_treatment")["synthetic"]) **2return pre_treat_error.mean()plt.figure(figsize=(12,7))for state in synthetic_states:# remove units with mean error above 80.if pre_treatment_error(state) <80: plt.plot(state["year"], state["cigsale"] - state["synthetic"], color="C5",alpha=0.4)plt.plot(cigar.query("california")["year"], cigar.query("california")["cigsale"] - calif_synth, label="California");plt.vlines(x=1988, ymin=-50, ymax=120, linestyle=":", lw=2, label="Proposition 99")plt.hlines(y=0, xmin=1970, xmax=2000, lw=3)plt.ylabel("Gap in per-capita cigarette sales (in packs)")plt.title("Distribution of Effects")plt.title("State - Synthetic Across Time (Large Pre-Treatment Errors Removed)")plt.legend();
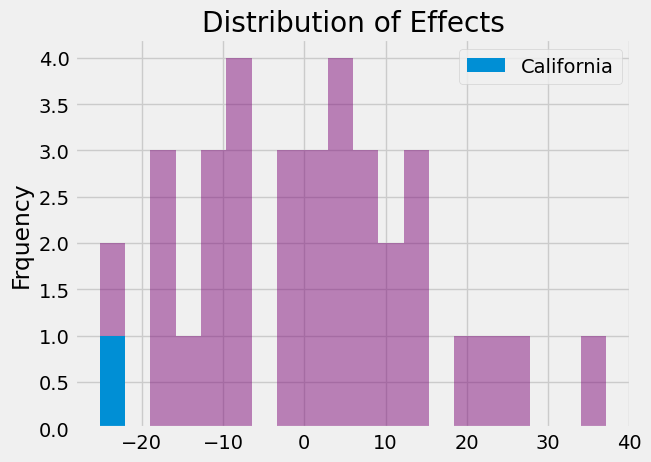
잡음을 걷어 내고 나니 캘리포니아 주의 효과가 얼마나 극단적인 값인지 보입니다. 이 그림은 다른 어떤 주에 처치가 일어났다고 가정하더라도 캘리포니아만큼 극단적인 효과는 거의 나오지 않는다는 것을 보여 줍니다.
이 그림 자체도 일종의 추론이지만, 이 결과로 p 값(p-value)을 구할 수도 있습니다. 구한 효과 가운데 캘리포니아의 효과보다 작은 것이 몇 번이나 되는지 세기만 하면 됩니다.
코드
calif_number =3effects = [state.query("year==2000").iloc[0]["cigsale"] - state.query("year==2000").iloc[0]["synthetic"]for state in synthetic_statesif pre_treatment_error(state) <80] # filter out noisecalif_effect = cigar.query("california & year==2000").iloc[0]["cigsale"] - calif_synth[-1] print("California Treatment Effect for the Year 2000:", calif_effect)np.array(effects)
California Treatment Effect for the Year 2000: -24.830159747347786
도시나 주처럼 집계 수준의 데이터밖에 없으면 이중차분법으로는 추론을 할 수 없다는 것을 배웠습니다. 이중차분법에는 다른 한계도 있습니다. 대조 대상을 하나 정해야 하는데, 대조 대상 하나만으로는 처치받은 대상의 반사실(counterfactual)을 제대로 대변하지 못할 수 있습니다.
이를 바로잡기 위해, 여러 대조 대상을 조합해 처치받은 대상과 닮게 만든 가상의 대조군을 구축할 수 있다는 것을 배웠습니다. 이 가상의 대조군 덕분에 처치가 없었다면 처치받은 대상에 어떤 일이 일어났을지 볼 수 있었습니다.
마지막으로 피셔의 정확 검정을 이용해 통제집단합성법으로 추론하는 방법을 살펴보았습니다. 처치받지 않은 대상들이 실제로 처치받았다고 치고 그 효과를 계산했습니다. 이것이 위약 효과, 즉 처치가 없어도 관측될 효과입니다. 이를 이용해 추정한 처치효과가 통계적으로 유의한지 확인했습니다.
참고 자료
저는 이 책 전체를 Joshua Angrist, Alberto Abadie, Christopher Walters의 훌륭한 계량경제학 강의에 바치는 헌사라고 생각합니다. 이 책에 담긴 아이디어 대부분은 이들이 미국경제학회(American Economic Association)에서 한 강의에서 가져왔습니다. 힘든 2020년을 버틸 수 있는 것도 이 강의들을 보는 덕분입니다. * Cross-Section Econometrics * Mastering Mostly Harmless Econometrics
Angrist의 멋진 책들도 참고 자료로 소개하고 싶습니다. 이 책들 덕분에 계량경제학, 이들 표현으로는 ’Metrics가 아주 유용할 뿐 아니라 무척 재미있다는 것을 알게 되었습니다.
Causal Inference for the Brave and True는 과학의 통계학이라 할 수 있는 인과추론을 다루는 오픈소스 자료입니다. 파이썬 기반의 무료 소프트웨어만 사용하며, 돈이 없어도, 배경지식이 많지 않아도 누구나 볼 수 있는 자료를 목표로 합니다. 이 책이 도움이 되었고 후원하고 싶다면 Patreon을 방문해 주세요. 금전적으로 기여하기 어렵다면 오타를 고치거나, 수정할 부분을 제안하거나, 이해하기 어려웠던 부분에 의견을 주는 것으로도 도울 수 있습니다. 책의 저장소에서 이슈를 열어 주세요. 마지막으로 이 내용이 마음에 들었다면 도움이 될 만한 사람들과 공유하고 GitHub에서 스타를 눌러 주세요.
의견 나누기
번역이 어색한 곳, 더 쉬운 설명, 궁금한 점을 남겨 주세요. GitHub 계정으로 로그인하면 댓글을 달 수 있고, 남긴 의견은 GitHub Discussions에 장별로 모입니다.