이제 이 책의 1부를 마무리합니다. 1부에서는 인과추론의 핵심을 다뤘습니다. 거기서 소개한 기법들은 널리 알려져 있고 확실히 자리를 잡은, 오랜 세월의 검증을 견뎌 낸 방법들입니다. 1부는 믿고 기댈 수 있는 탄탄한 토대를 쌓는 부분이었습니다. 좀 더 전문적으로 말하면, 1부에서는 인과추론이 무엇인지 정의하고 상관관계가 인과관계가 되지 못하게 가로막는 편향(bias)에는 어떤 것이 있는지 살펴봤습니다. 그리고 그 편향을 보정하는 여러 방법(회귀분석, 매칭, 성향점수)과 대표적인 식별 전략(도구변수, 이중차분법, 회귀 불연속 설계)을 다뤘습니다. 요약하면 1부는 평균 처치효과(ATE) \(E[Y_1 - Y_0]\)를 식별하는 표준 기법에 초점을 맞췄습니다.
2부로 넘어가면 발밑이 조금 흔들리기 시작합니다. 인과추론 문헌의 최근 발전, 머신러닝과의 관계, 그리고 산업 현장에서의 응용을 다루기 때문입니다. 그런 의미에서 2부는 학문적 엄밀함을 조금 내주는 대신 실용성과 경험적 근거를 택합니다. 2부에서 소개하는 방법 가운데 일부는 왜 작동하는지 설명하는 탄탄한 이론이 없습니다. 그래도 막상 써 보면 어쨌든 잘 작동하는 것처럼 보입니다. 그래서 2부는 세상의 근본적인 인과관계를 연구하려는 과학자보다, 일상 업무에서 인과추론을 활용하려는 실무자에게 더 유용할 것입니다.
2부의 처음 몇 장은 이질적 처치효과(heterogeneous treatment effect)를 추정하는 데 집중합니다. 평균 처치효과 \(E[Y_1 - Y_0]\)만 신경 쓰던 세계에서, 분석단위마다 처치에 얼마나 다르게 반응하는지 \(E[Y_1 - Y_0 | X]\)를 알고 싶어 하는 세계로 넘어가는 것입니다. 이 세계에서는 개인화(personalisation)가 무엇보다 중요합니다. 처치효과가 가장 클 대상을 먼저 처치하고 싶고, 처치가 오히려 해가 될 대상은 처치하고 싶지 않습니다. 어떤 의미에서는 평균 처치효과가 얼마인가라는 실증적 질문에서 누구를 처치해야 하는가라는 규범적 질문으로 옮겨 가는 셈입니다.
대부분의 기업이 스스로에게 던지는 질문이 바로 이것입니다. 표현만 조금 다를 뿐입니다. 누구에게 할인을 줘야 할까? 대출 이자율을 얼마로 매겨야 할까? 이 사용자에게 어떤 상품을 추천해야 할까? 고객마다 어떤 페이지 레이아웃을 보여 줘야 할까? 모두 2부에서 소개할 도구로 답할 수 있는 처치효과 이질성 문제입니다. 하지만 그 전에 산업 현장에서 머신러닝이 어떤 의미인지부터 소개하는 것이 순서일 것입니다. 머신러닝은 나중에 인과추론에 쓸 기본 도구가 되기 때문입니다.
산업 현장의 머신러닝
이 장에서는 산업 현장에서 머신러닝을 보통 어떻게 쓰는지 이야기합니다. 머신러닝이 익숙하지 않다면 이 장을 머신러닝 속성 강좌로 여겨도 좋습니다. 머신러닝을 한 번도 다뤄 본 적이 없다면, 앞으로 나올 내용을 제대로 소화할 수 있도록 적어도 기초는 공부해 두기를 강력히 권합니다. 그렇다고 머신러닝을 이미 잘 안다면 이 장을 건너뛰어도 된다는 뜻은 아닙니다. 끝까지 읽어 보면 여전히 얻는 것이 있으리라 생각합니다. 다른 머신러닝 자료와 달리 이 장에서는 의사결정 트리나 신경망 같은 알고리즘의 세부 사항을 다루지 않습니다. 대신 머신러닝이 현실 세계에 어떻게 적용되는지에만 온전히 집중합니다.
가장 먼저 짚고 싶은 것은 인과추론 책에서 왜 머신러닝 이야기를 하느냐는 점입니다. 짧게 답하면, 인과관계를 이해하는 가장 좋은 방법 중 하나가 머신러닝이 가져온 예측 모델 접근법과 대비해 보는 것이라고 생각하기 때문입니다. 길게 답하면 이유는 두 가지입니다. 첫째, 이 책을 여기까지 읽었다면 이미 머신러닝에 익숙할 가능성이 높습니다. 둘째, 그렇지 않더라도 요즘 워낙 인기 있는 주제라 머신러닝이 무엇인지 대략은 알고 있을 것입니다. 다만 머신러닝을 둘러싼 과열된 기대 때문에, 독자를 현실로 끌어내려 머신러닝이 실제로 무슨 일을 하는지 아주 실용적인 말로 설명해야 할지도 모릅니다. 마지막으로, 인과추론의 최근 연구가 머신러닝 알고리즘을 적극적으로 활용한다는 점도 있습니다.
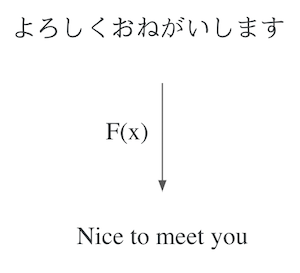
아주 직설적으로 말하면, 머신러닝은 빠르고 자동화된 좋은 예측을 하는 방법입니다. 이것이 전부는 아니지만 90%는 설명합니다. 컴퓨터 비전, 자율주행 자동차, 언어 번역, 진단처럼 멋진 발전은 대부분 지도 학습 분야에서 나왔습니다. 처음에는 이런 일이 예측 문제처럼 보이지 않을 수도 있습니다. 언어 번역이 어떻게 예측일까요? 바로 이 점이 머신러닝의 매력입니다. 예측으로 풀 수 있는 문제는 처음 생각보다 훨씬 많습니다. 언어 번역이라면, 기계에 문장 하나를 보여 주고 같은 문장을 다른 언어로 예측하게 하는 예측 문제로 정의할 수 있습니다. 여기서 예측이라는 단어를 미래를 내다보거나 점친다는 뜻으로 쓰는 것이 아니라는 점에 유의하세요. 예측은 그저 정의된 입력 하나를 출력에 대응시키는 일입니다. 그 출력은 처음에는 알 수 없지만, 입력과 마찬가지로 잘 정의되어 있고 관측할 수 있습니다.
머신러닝이 실제로 하는 일은 이 대응 함수를 학습하는 것입니다. 함수가 아주 복잡해도 상관없습니다. 결국 핵심은, 어떤 문제를 입력에서 출력으로의 대응으로 정의할 수 있다면 머신러닝이 그 문제를 풀 좋은 후보가 될 수 있다는 것입니다. 자율주행 자동차는 하나가 아니라 여러 개의 복잡한 예측 문제로 볼 수 있습니다. 차 앞쪽 센서 데이터로 바퀴의 올바른 각도를 예측하고, 차 주변 카메라 영상으로 브레이크를 밟을 세기를 예측하고, GPS 데이터로 가속 페달을 밟을 세기를 예측하는 식입니다. 이런 예측 문제(와 그 밖의 수많은 예측 문제)를 풀어내는 것이 곧 자율주행 자동차를 만드는 일입니다.
머신러닝을 좀 더 기술적으로 생각하면, (아주 복잡할 수도 있는) 기댓값 함수를 추정하는 일로 볼 수 있습니다.
\[
E[Y|X]
\]
여기서 \(Y\)는 알고 싶은 것(번역된 문장, 진단 결과)이고, \(X\)는 이미 알고 있는 것(입력 문장, 엑스레이 영상)입니다. 머신러닝은 그저 이 조건부 기댓값 함수를 추정하는 방법입니다.
좋습니다. 이제 예측이 처음 생각보다 강력할 수 있다는 것을 알았습니다. 자율주행 자동차와 언어 번역은 멋지긴 하지만, 구글이나 우버 같은 대형 테크 기업에서 일하지 않는 한 꽤 먼 이야기입니다. 그러니 좀 더 와닿게, 거의 모든 회사가 안고 있는 문제인 고객 획득(customer acquisition), 즉 새 고객을 확보하는 문제로 이야기해 보겠습니다.
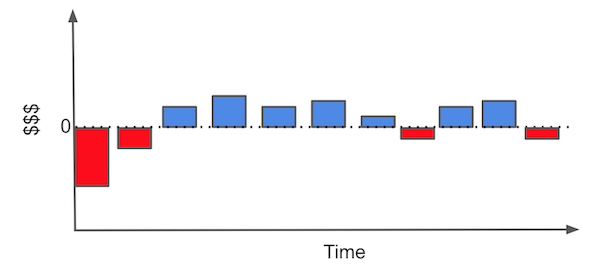
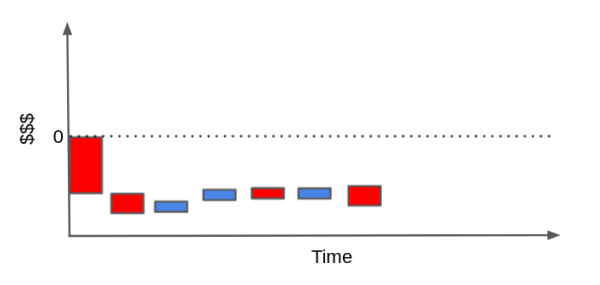
고객 획득 관점에서 보통 해야 하는 일은 어떤 고객이 수익을 내는지 알아내는 것입니다. 이 문제에서는 고객마다 획득 비용(마케팅 비용, 온보딩 비용, 배송비 등)이 들고, 바라건대 고객은 회사에 양의 현금 흐름을 만들어 줍니다. 예를 들어 인터넷 서비스 회사나 가스 회사라고 해 봅시다. 전형적인 고객의 현금 흐름은 대략 다음과 같을 것입니다.
막대 하나하나는 고객과의 관계에서 생기는 금전적 사건을 나타냅니다. 예를 들어 고객을 데려오려면 처음부터 마케팅에 투자해야 합니다. 그다음 누군가 거래하기로 결정하면 온보딩 비용(고객에게 제품 사용법을 설명하는 비용)이나 설치 비용이 들 수 있습니다. 그 뒤에야 고객이 매달 매출을 만들어 내기 시작합니다. 어느 시점에는 고객에게 지원이 필요해져 유지 보수 비용이 들 수도 있습니다. 마지막으로 고객이 계약을 끝내기로 하면 그에 따른 최종 비용이 생길 수도 있습니다.
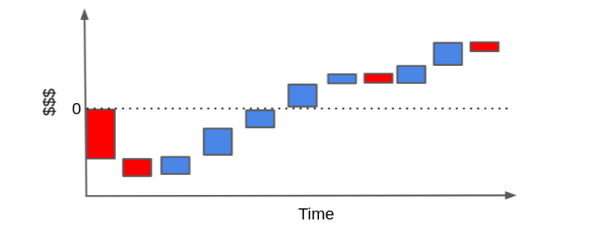
이 고객이 수익을 내는지 보려면 막대를 폭포 차트(cascade plot)라고 부르는 형태로 다시 배열하면 됩니다. 현금 사건을 모두 더한 값이 0선보다 한참 위에서 끝나기를 바랄 것입니다.
반대로 고객이 매출보다 훨씬 많은 비용을 만들어 낼 수도 있습니다. 제품은 거의 쓰지 않으면서 유지 보수 요구는 많은 고객이라면, 현금 사건을 쌓아 올렸을 때 0선 아래에서 끝날 수 있습니다.
물론 사업 유형에 따라 현금 흐름은 더 단순할 수도, 훨씬 복잡할 수도 있습니다. 이자율로 시간 할인을 적용하는 등 얼마든지 정교하게 파고들 수 있지만, 요점은 충분히 전달됐다고 생각합니다.
그렇다면 여기서 무엇을 할 수 있을까요? 수익을 내는 고객과 그렇지 않은 고객의 사례가 많다면, 이들을 가려내는 머신러닝 모델을 훈련할 수 있습니다. 그러면 수익을 내는 고객만 끌어들이는 마케팅 전략에 집중할 수 있습니다. 계약 조건이 허락한다면, 고객이 비용을 더 만들어 내기 전에 관계를 끝낼 수도 있습니다. 본질적으로 여기서 하는 일은 비즈니스 문제를 예측 문제로 정의해서 머신러닝으로 풀 수 있게 만드는 것입니다. 수익을 내는 고객과 내지 못하는 고객을 예측하거나 가려내서, 수익을 내는 고객과만 거래하려는 것입니다.
코드
import pandas as pdimport numpy as npfrom sklearn import ensemblefrom sklearn.model_selection import train_test_splitfrom sklearn.pipeline import Pipelinefrom sklearn.metrics import r2_scoreimport seaborn as snsfrom matplotlib import pyplot as pltfrom matplotlib import stylestyle.use("ggplot")
예를 들어 고객 10,000명의 30일치 거래 데이터가 있다고 해 봅시다. 고객 획득 비용 cacq도 알고 있습니다. 이 비용은 온라인 마케팅을 한다면 고객을 잡으려고 거는 입찰가일 수도 있고, 배송비나 고객이 제품을 쓸 수 있도록 해 주는 교육 비용일 수도 있습니다. 또 문제를 단순하게 만들기 위해(이 장은 속성 강좌이지 고객 가치 평가를 한 학기 동안 배우는 수업이 아닙니다), 거래할 고객을 완전히 통제할 수 있다고 가정하겠습니다. 다시 말해 고객이 거래를 원하더라도 거절할 권한이 있습니다. 그렇다면 할 일은 누가 수익을 낼지 미리 가려내서 그 고객과만 거래하는 것입니다.
이제 이 거래 데이터로 좋은 고객과 나쁜 고객을 구분해야 합니다. 간단하게 모든 거래 금액과 CACQ를 더하겠습니다. 다만 이렇게 하면 많은 세부 사항을 덮어 두게 된다는 점을 기억하세요. 예를 들어 이탈한 고객과, 한 번 구매한 뒤 다음 구매까지 잠시 쉬고 있는 고객을 구분하지 못합니다.
그다음 net_value라고 이름 붙인 이 합계를 고객별 특성(feature)과 결합합니다. 목표는 거래를 시작하기로 결정하기 전에 어떤 고객이 수익을 낼지 알아내는 것이므로, 고객 획득 이전 시점의 데이터만 쓸 수 있습니다. 여기서는 나이, 지역, 소득이 그런 특성이며, 모두 별도의 csv 파일 하나에 들어 있습니다.
좋습니다! 과제가 조금 더 구체적으로 바뀌었습니다. 수익을 내지 못하는 고객과 수익을 내는 고객(net_value > 0)을 구분하려고 합니다. 여러 방법을 시도해 보고 어느 것이 더 나은지 보겠습니다. 하지만 그 전에 머신러닝을 빠르게 훑어봐야 합니다(머신러닝이 어떻게 작동하는지 이미 안다면 건너뛰어도 됩니다).
머신러닝 속성 강좌
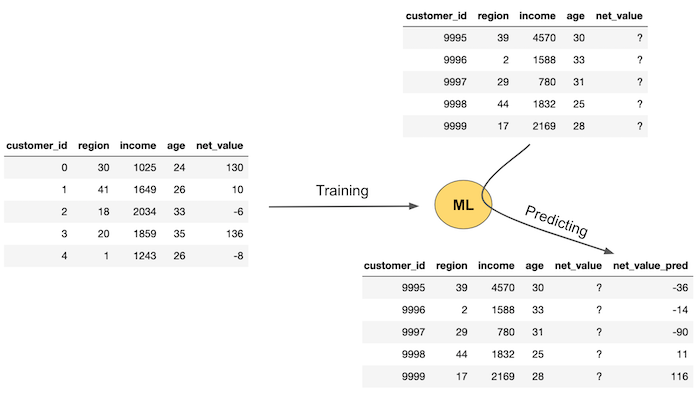
여기서의 목적에 비춰 보면 머신러닝은 예측을 하는 엄청나게 강력한 방법이라고 생각하면 됩니다. 머신러닝을 쓰려면 레이블이 붙은 데이터, 즉 예측하려는 대상의 참값(ground truth)이 있는 데이터가 필요합니다. 그 데이터로 머신러닝 모델을 훈련한 다음, 아직 참값을 모르는 곳에서 그 모델로 예측합니다. 아래 그림은 전형적인 머신러닝 흐름을 보여 줍니다.
먼저 참값(여기서는 net_value)을 아는 데이터가 필요합니다. 그다음 특성(이 예에서는 지역, 소득, 나이)으로 net_value를 예측하는 머신러닝 모델을 훈련합니다. 이 훈련 또는 추정 단계를 거치면, 실제 net_value를 아직 모를 때 net_value를 예측하는 데 쓸 머신러닝 모델이 만들어집니다. 그림의 왼쪽 부분이 이 과정입니다. 특성(지역, 소득, 나이)은 있지만 net_value는 아직 모르는 새 데이터를 모델에 넣으면, 모델이 net_value 예측값을 내놓습니다.
기술적인 표기가 더 편하다면, 머신러닝을 조건부 기댓값 \(E[Y|X]\)를 추정하는 일로 이해할 수도 있습니다. 여기서 \(Y\)를 목표 변수(target variable) 또는 결과변수라 하고, \(X\)를 특성 변수라고 합니다. 머신러닝은 보통 어떤 오차 함수나 손실 함수를 최적화해서 \(\hat{E}[Y|X]\)를 얻는 강력한 방법일 뿐입니다.
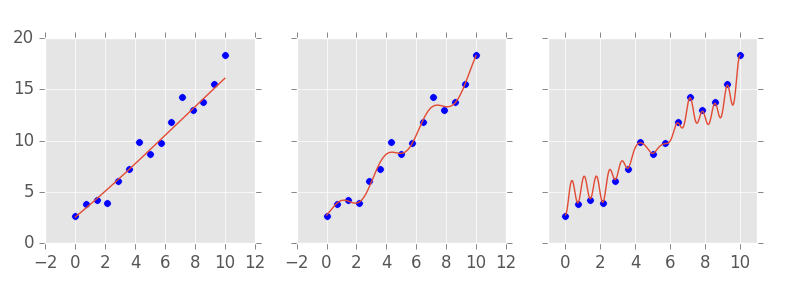
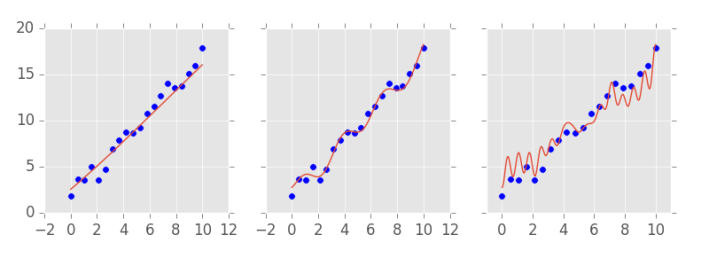
머신러닝 모델의 까다로운 점 하나는 거의 모든 함수를 근사할 수 있다는 것입니다. 달리 말하면, 모델을 훈련 셋의 데이터에 완벽하게 들어맞을 만큼 강력하게 만들 수 있다는 뜻입니다. 머신러닝 모델에는 보통 복잡도 하이퍼파라미터라는 것이 있어서, 모델이 얼마나 강력하고 복잡해질 수 있는지를 조절합니다. 아래 그림에서 단순한 모델(왼쪽), 중간 모델(가운데), 복잡하고 강력한 모델(오른쪽)의 예를 볼 수 있습니다. 복잡한 모델이 훈련 데이터에 완벽하게 들어맞는다는 점을 눈여겨보세요.
여기서 몇 가지 문제가 생깁니다. 무엇보다, 현실 세계에서 예측에 쓰기 전에 모델이 쓸 만한지 어떻게 알 수 있을까요? 한 가지 방법은 참값이 있는 데이터셋에서 예측값과 참값을 비교하는 것입니다. \(R^2\) 같은 이른바 적합도(goodness of fit) 지표가 이런 방법입니다. 하지만 모델을 데이터에 완벽하게 들어맞을 만큼 강력하게 만들 수 있다는 점을 떠올려 보세요. 그렇게 되면 예측값이 참값과 완벽하게 일치합니다. 그러면 모델을 더 강력하고 복잡하게 만들기만 해도 이 검증을 통과할 수 있으니, 검증 결과를 믿을 수 없게 됩니다.
게다가 아주 복잡한 모델은 일반적으로 좋지 않습니다. 왜 그런지는 이미 어느 정도 직감하고 있을 것입니다. 예를 들어 위 그림에서 어떤 모델이 마음에 드나요? 모든 예측을 맞히는 가장 복잡한 모델일까요? 아마 아닐 것입니다. 가운데 모델을 고를 가능성이 큽니다. 데이터에 완벽하게 들어맞지는 않지만, 더 매끄럽고 단순하면서도 여전히 꽤 좋은 예측을 합니다.
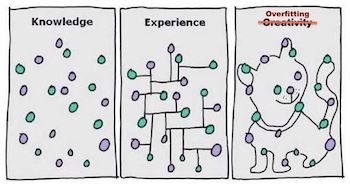
그 직감이 맞습니다. 모델에 힘을 너무 많이 주면, 모델은 데이터의 패턴뿐 아니라 무작위 잡음까지 학습합니다. 현실 세계에서 모델로 예측할 때는 잡음이 달라지므로(잡음은 어쨌든 무작위입니다), “완벽한” 모델은 실수를 저지릅니다. 머신러닝 용어로는 너무 복잡한 모델이 과적합(overfitting)되어 일반화를 잘하지 못한다고 말합니다. 그럼 어떻게 해야 할까요?
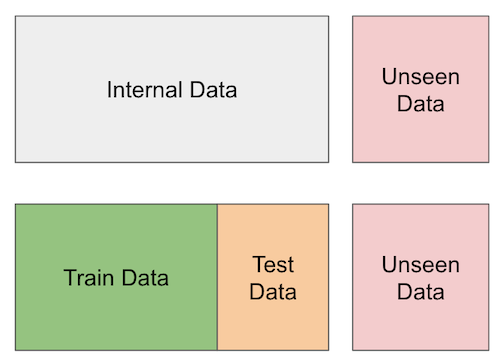
데이터 일부에 접근할 수 없는 척하면 됩니다. 참값이 있는 데이터셋을 둘로 나누는 것이 핵심입니다. 한쪽은 모델 훈련에 쓰고, 다른 쪽은 모델의 예측을 검증하는 데 씁니다. 이를 교차 검증(cross validation)이라고 합니다.
모델이 훈련 중에 보지 못한 위 데이터셋에서는 복잡한 모델이 그다지 잘하지 못합니다. 반면 가운데 모델은 더 잘하는 것처럼 보입니다. 알맞은 모델 복잡도를 고르려면 복잡도가 서로 다른 여러 모델을 훈련한 다음, 참값은 있지만 모델 훈련에는 쓰지 않은 데이터에서 각 모델이 얼마나 잘하는지 보면 됩니다. 교차 검증은 아주 중요하니 좀 더 시간을 들여 살펴보겠습니다.
교차 검증
교차 검증은 모델 복잡도를 고르는 데 꼭 필요하지만, 그 밖에도 쓸모가 많습니다. 여러 가지를 시도해 보고 각각이 현실 세계에서 어떤 결과를 낼지 가늠하고 싶을 때면 언제든 쓸 수 있습니다. 교차 검증의 기본 아이디어는 현실 세계를 흉내 내는 것입니다. 현실에서는 가진 데이터로 모델을 추정하지만, 예측은 처음 보는 새 데이터에서 합니다. 없는 척하는 홀드아웃 데이터는 실전에서 마주칠 데이터의 대리 역할을 합니다.
어떤 고객이 수익을 내는지 알아내는 문제 전체에 교차 검증을 어떻게 적용하는지 보겠습니다. 할 일을 정리하면 다음과 같습니다.
기존 고객의 데이터가 있습니다. 이 데이터에서는 어떤 고객이 수익을 내고 어떤 고객이 그렇지 않은지 압니다(참값을 압니다). 이 내부 데이터를 훈련 셋이라고 부르겠습니다.
내부 데이터로 어떤 고객이 수익을 내는지 알려 주는 규칙을 학습합니다(그래서 훈련이라고 부릅니다).
규칙을 학습하는 데 쓰지 않은 홀드아웃 데이터에 그 규칙을 적용합니다. 이렇게 하면 한 데이터셋에서 규칙을 학습하고 다른 데이터셋에 적용하는 과정을 흉내 낼 수 있습니다. 모델을 실제 서비스에 배포해 정말 처음 보는 데이터에 점수를 매길 때는 이 과정을 피할 수 없습니다.
아래 그림은 교차 검증이 어떤 모습인지 보여 줍니다. 그림 맨 오른쪽에는 정말로 처음 보는 데이터가 있고, 그 앞에는 학습할 때 없는 척만 하는 데이터가 있습니다.
정리하면, 내부 데이터를 훈련 셋과 테스트 셋으로 나눕니다. 훈련 셋으로는 고객이 수익을 낼지 예측하는 모델이나 규칙을 만들고, 그 규칙은 데이터셋의 다른 부분인 테스트 셋에서 검증합니다. 테스트 셋은 학습 과정에서 감춰 둡니다.
덧붙이자면, 이렇게 단순히 훈련 셋과 테스트 셋으로 나누는 것 말고도 교차 검증을 더 잘하는 방법은 아주 많습니다(예를 들어 k-폴드 교차 검증이나 시계열 교차 검증). 하지만 여기서 할 작업에는 이 정도면 충분합니다. 교차 검증의 정신은 실제 서비스 환경에 들어갔을 때 벌어질 일을 시뮬레이션하는 데 있다는 점을 기억하세요. 그렇게 해서 더 현실적인 추정값을 얻기를 기대하는 것입니다.
여기서는 별다른 기교를 부리지 않겠습니다. 그냥 데이터셋을 둘로 나눕니다. 70%는 수익을 내는 고객을 가려내는 방법을 만드는 데 쓰고, 30%는 그 방법이 얼마나 좋은지 평가하는 데 씁니다.
코드
train, test = train_test_split(customer_features, test_size=0.3, random_state=13)train.shape, test.shape
((7000, 5), (3000, 5))
예측과 정책
지금까지 수익을 내는 고객을 가려내는 방법과 접근법을 이야기했는데, 이제 개념을 좀 더 정확하게 다듬을 때입니다. 새로운 개념 두 가지를 소개하겠습니다. 예측(prediction)은 무언가를 추정하거나 예측하는 숫자로, \(\hat{E}[y_i|X_i]\)의 추정값입니다. 예를 들어 고객의 수익성을 예측하면 예측값은 16헤알(BRL) 같은 숫자가 되고, 이 고객이 16헤알의 매출을 낼 것으로 예측한다는 뜻입니다. 요점은 예측이 단순한 숫자라는 것입니다.
두 번째 개념은 정책(policy)입니다. 정책은 자동화된 의사결정 규칙입니다. 예측이 숫자라면 정책은 결정입니다. 예를 들어 소득이 1000보다 큰 고객과는 거래하고 그렇지 않으면 거래하지 않는 정책을 세울 수 있습니다. 정책은 보통 예측 위에 세웁니다. 수익성 예측값이 10을 넘는 모든 고객과 거래하고 그렇지 않으면 거래하지 않는 식입니다(\(\hat{E}[y_i|X_i] > 10\)). 머신러닝은 보통 첫 번째 개념, 즉 예측을 담당합니다. 하지만 예측만으로는 아무 쓸모가 없다는 점에 주목하세요. 예측에 어떤 결정, 즉 정책을 붙여야 합니다.
정책과 모델은 아주 단순하게 만들 수도, 아주 복잡하게 만들 수도 있습니다. 정책이든 예측이든 교차 검증을 해야 합니다. 즉, 데이터의 한 부분에서 정책이나 예측을 추정하고 다른 부분에서 그 쓸모를 검증해야 합니다. 이미 데이터를 둘로 나눠 두었으니 준비는 끝났습니다.
특성 하나로 만드는 정책
이 수익성 문제에 머신러닝을 마구 들이대기 전에 단순한 것부터 시도해 보겠습니다. 20%의 노력으로 80%의 성과를 얻는 방법들 말입니다. 이런 방법은 종종 놀라운 효과를 내는데, 의외로 대부분의 데이터 과학자가 이를 잊어버립니다. 그렇다면 할 수 있는 가장 단순한 일은 무엇일까요? 당연히 그냥 모든 고객과 거래하는 것입니다! 어떤 고객이 수익을 내는지 따지는 대신, 모두와 거래하면서 수익을 내는 고객이 그렇지 않은 고객의 손실을 충분히 메워 주기를 바라는 것입니다.
이것이 좋은 생각인지 확인하려면 고객의 평균 순가치(net value)를 보면 됩니다. 이 값이 양수라면 평균적으로 고객에게서 돈을 번다는 뜻입니다. 물론 수익을 내는 고객도 있고 그렇지 않은 고객도 있겠지만, 고객이 충분히 많다면 평균적으로 돈을 벌게 됩니다. 반대로 이 값이 음수라면 모든 고객과 거래했을 때 돈을 잃는다는 뜻입니다.
코드
train["net_value"].mean()
-29.169428571428572
아쉽게 됐습니다… 모두와 거래하면 거래하는 고객 한 명당 약 30헤알씩 손해를 봅니다. 아주 단순한 첫 시도는 실패했으니, 문을 닫고 싶지 않다면 더 가능성 있는 방법을 찾아야 합니다. 잠깐 짚고 넘어가자면, 이것은 교육용 예시라는 점을 기억하세요. 여기서는 “모두를 똑같이 대하는” 아주 단순한 정책이 통하지 않았지만, 현실에서는 이런 정책이 통하는 경우가 많습니다. 모두에게 마케팅 이메일을 보내는 편이 보내지 않는 편보다 낫거나, 모두에게 할인 쿠폰을 주는 편이 주지 않는 편보다 나은 경우가 흔합니다.
그럼 그다음으로 단순한 방법은 무엇일까요? 한 가지 아이디어는 특성을 하나씩 살펴보면서 그것만으로 좋은 고객과 나쁜 고객을 구분할 수 있는지 보는 것입니다. income을 예로 들어 봅시다. 부유한 고객일수록 수익도 더 많이 낼 것 같지 않나요? 가장 부유한 고객들과만 거래하면 어떨까요? 좋은 생각일까요?
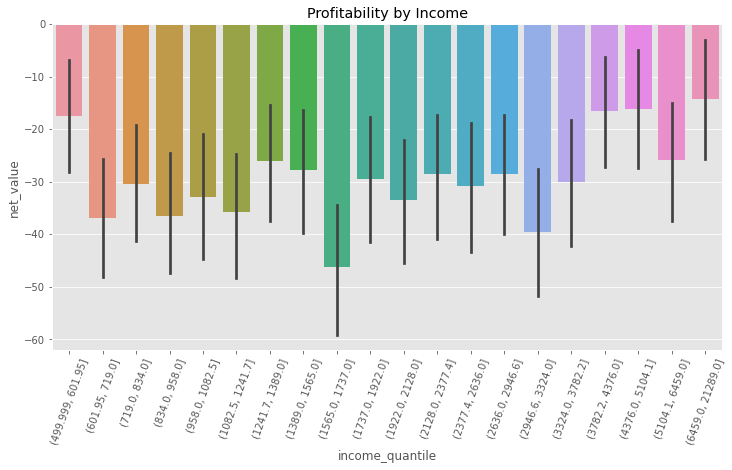
이를 알아보려면 데이터를 소득 분위수로 나누면 됩니다(분위수는 데이터를 같은 크기의 구간으로 나눠 준다는 성질이 있어서 제가 좋아합니다). 그다음 소득 분위수마다 평균 순가치를 계산합니다. 기대하는 것은 이렇습니다. 전체 평균 순가치는 음수이지만(\(E[NetValue]<0\)), 소득으로 정의되는 어떤 하위 모집단, 아마도 소득이 높은 집단에서는 순가치가 양수일 수 있습니다(\(E[NetValue|Income=x]>0\)).
코드
plt.figure(figsize=(12,6))np.random.seed(123) ## seed because the CIs from seaborn uses boostrap# pd.qcut create quantiles of a columnsns.barplot(data=train.assign(income_quantile=pd.qcut(train["income"], q=20)), x="income_quantile", y="net_value")plt.title("Profitability by Income")plt.xticks(rotation=70);
안타깝게도 아닙니다. 이번에도 모든 소득 수준에서 평균 순가치가 음수입니다. 부유한 고객이 그렇지 않은 고객보다 “덜 나쁜” 것은 사실이지만, 여전히 평균적으로는 음의 순가치를 만들어 냅니다. 소득은 별 도움이 되지 않았지만, 지역 같은 다른 변수는 어떨까요? 비용 대부분이 가령 먼 곳에 사는 고객에게 서비스를 제공하는 데서 나온다면, 지역이 수익을 내는 고객과 그렇지 않은 고객을 가를 것이라고 기대할 만합니다.
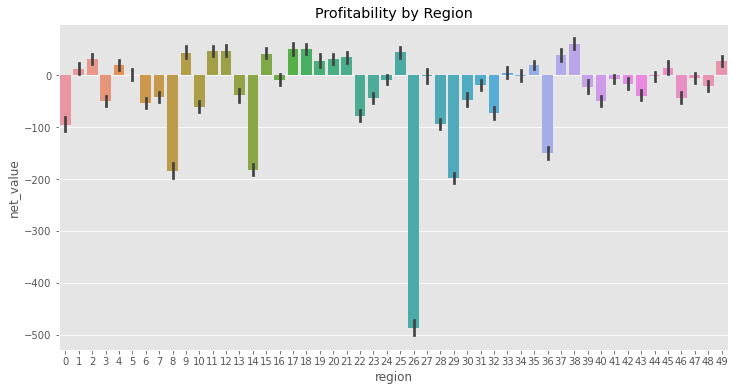
지역은 이미 범주형 변수이므로 여기서는 분위수를 쓸 필요가 없습니다. 지역별 평균 순가치를 바로 보겠습니다.
코드
plt.figure(figsize=(12,6))np.random.seed(123)region_plot = sns.barplot(data=train, x="region", y="net_value")plt.title("Profitability by Region");
빙고! 2, 17, 39 지역처럼 수익을 내는 지역도 있고, 0, 9, 29 지역과 특히 나쁜 26 지역처럼 수익을 내지 못하는 지역도 분명히 있습니다. 아주 유망해 보입니다! 이를 정책으로 바꿀 수 있습니다. 지금 가진 데이터에 따르면 수익을 내는 것으로 나타난 지역과만 거래하는 것입니다.
눈여겨볼 점은 지금 하는 일이 머신러닝이 하는 일과 같되, 훨씬 단순한 방식이라는 것입니다. 즉, 각 지역의 순가치 기댓값 \(E[NetValue|Region]\)을 추정하고 있습니다. 이제 이 추정값을 가지고 무언가를 해야 합니다.
이 정책을 만드는 방법은 아주 간단합니다. 지역별 순가치 기댓값에 95% 신뢰구간을 구하고, 그 구간이 0보다 크면 그 지역과 거래합니다.
아래 코드는 지역을 키로, 95% 신뢰구간의 하한을 값으로 하는 딕셔너리를 만듭니다. 그다음 딕셔너리 컴프리헨션으로 순가치 기댓값이 양수인 지역만 걸러 냅니다. 그 결과가 정책에 따라 거래할 지역입니다.
코드
# extract the lower bound of the 95% CI from the plot aboveregions_to_net = train.groupby('region')['net_value'].agg(['mean', 'count', 'std'])regions_to_net = regions_to_net.assign( lower_bound=regions_to_net['mean'] -1.96*regions_to_net['std']/(regions_to_net['count']**0.5))regions_to_net_lower_bound = regions_to_net['lower_bound'].to_dict()regions_to_net = regions_to_net['mean'].to_dict()# filters regions where the net value lower bound is > 0.regions_to_invest = {region: net for region, net in regions_to_net_lower_bound.items()if net >0}regions_to_invest
regions_to_invest에는 거래할 지역이 모두 들어 있습니다. 이제 이 정책이 테스트 셋, 즉 없는 척했던 데이터에서 어떤 성과를 냈을지 보겠습니다. 정책을 평가하는 데 아주 중요한 단계입니다. 훈련 셋에서는 순전히 우연 때문에 어떤 지역이 수익을 내는 것처럼 보일 수 있기 때문입니다. 정말 우연일 뿐이라면 테스트 셋에서 같은 패턴이 나타날 가능성은 낮습니다.
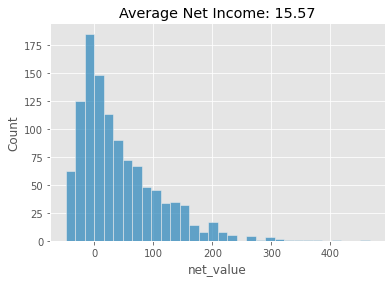
이를 위해 테스트 셋에서 (훈련 셋 기준으로) 수익을 낸다고 판단한 지역의 고객만 남깁니다. 그다음 이 고객들의 순이익 분포를 그리고, 정책의 평균 순이익도 함께 표시합니다.
코드
region_policy = (test[test["region"]# filter regions in regions_to_invest .isin(regions_to_invest.keys())]) sns.histplot(data=region_policy, x="net_value")# average has to be over all customers, not just the one we've filtered with the policyplt.title("Average Net Income: %.2f"% (region_policy["net_value"].sum() / test.shape[0]));
정책의 입력으로 쓰는 머신러닝 모델
더 잘하고 싶다면 이제 머신러닝의 힘을 빌릴 수 있습니다. 다만 그러면 전체 과정이 엄청나게 복잡해질 수 있는 데 비해, 얻는 이득은 대개 미미하다는 점을 기억하세요. 하지만 상황에 따라서는 미미한 이득이 막대한 돈으로 바뀔 수 있고, 그래서 요즘 머신러닝이 그토록 귀한 대접을 받습니다.
여기서는 그레이디언트 부스팅(gradient boosting) 모델을 쓰겠습니다. 설명하기는 꽤 복잡하지만 쓰기는 아주 간단한 모델입니다. 지금 목적에는 이 모델이 어떻게 작동하는지 자세히 알 필요가 없습니다. 대신 머신러닝 속성 강좌에서 본 내용만 기억하면 됩니다. 머신러닝 모델은 복잡도 매개변수가 있는 아주 강력한 예측 기계이고, \(E[Y|X]\)를 추정하는 도구입니다. 복잡할수록 모델은 더 강력해집니다. 하지만 복잡도가 너무 높으면 모델이 과적합되어 잡음을 학습하고, 처음 보는 데이터에는 잘 일반화되지 않습니다. 그래서 여기서도 모델의 복잡도가 적절한지 교차 검증으로 확인해야 합니다.
이제 물어야 할 질문은 이것입니다. 좋은 예측을 어떻게 활용하면, 수익을 내는 고객을 가려내 거래하는 단순한 지역 정책을 개선할 수 있을까요? 저는 크게 두 가지를 개선할 수 있다고 봅니다. 첫째, 좋은 고객과 나쁜 고객을 가르는 특성을 찾으려고 모든 특성을 하나하나 살펴보는 일이 번거롭다는 데는 동의할 것입니다. 여기서는 특성이 나이, 소득, 지역 세 개뿐이라 그리 힘들지 않았지만, 100개가 넘는다고 상상해 보세요. 게다가 다중 검정 문제와 거짓 양성 비율도 조심해야 합니다. 둘째, 고객을 구분하려면 특성 하나로는 부족할 가능성이 큽니다. 이 예에서도 지역 말고 다른 특성 역시 고객 수익성에 관한 정보를 어느 정도 담고 있다고 봅니다. 물론 소득만 따로 봤을 때는 별 도움이 되지 않았지만, 아슬아슬하게 수익을 내지 못하는 지역에서 소득을 함께 보면 어떨까요? 그런 지역에서도 부유한 고객에게만 집중하면 여전히 수익을 낼 수 있을지 모릅니다. 기술적으로 말하면, \(E[NetValue|Region, Income, Age]\)가 \(E[NetValue|Region]\)보다 NetValue를 더 잘 예측한다는 주장입니다. 충분히 일리 있는 이야기입니다. 지역에 더해 소득과 나이 정보까지 쓰면 순가치를 더 잘 예측할 수 있을 것입니다.
특성 여러 개를 상호작용시키는 복잡한 정책을 직접 고안하는 일은 매우 어려울 수 있습니다. 살펴봐야 할 조합이 특성 개수에 따라 기하급수적으로 늘어나므로 현실적으로 할 수 있는 일이 아닙니다. 대신 특성을 모두 머신러닝 모델에 넣고, 그 상호작용을 모델이 대신 학습하게 할 수 있습니다. 바로 다음에 할 일이 이것입니다.
이 모델의 목표는 region, income, age로 net_value를 예측하는 것입니다. 학습을 돕기 위해 범주형인 지역 특성을 숫자로 인코딩하겠습니다. 각 지역을 훈련 셋에서 구한 그 지역의 평균 순가치로 바꿉니다. 이 값을 regions_to_net 딕셔너리에 저장해 둔 것을 기억하나요? 덕분에 .replace() 메서드를 호출하면서 이 딕셔너리를 인수로 넘기기만 하면 됩니다. 이 치환은 여러 번 할 것이므로 함수로 만들어 두겠습니다. 이렇게 학습이 잘되도록 특성을 변환하는 과정을 일반적으로 특성 엔지니어링(feature engineering)이라고 합니다.
다음으로 모델은 Sklearn에서 가져옵니다. Sklearn의 모델은 모두 사용법이 꽤 표준화되어 있습니다. 먼저 복잡도 매개변수를 넘겨 모델 인스턴스를 만듭니다. 이 모델에서는 추정기(estimator) 개수를 400, 최대 깊이를 4로 하는 식으로 설정합니다. 모델이 깊을수록, 추정기 개수가 많을수록 모델은 더 강력해집니다. 물론 너무 강력하게 둘 수는 없습니다. 그러면 훈련 데이터의 잡음까지 학습하거나 훈련 데이터에 과적합되기 때문입니다. 다시 말하지만 이 매개변수들이 정확히 무슨 일을 하는지 자세히 알 필요는 없습니다. 이것이 아주 좋은 예측 모델이라는 점만 기억하면 됩니다. 그다음 모델을 훈련하려면 .fit() 메서드를 호출하면서 특성 X와 예측하려는 변수, 즉 목표 변수인 net_value를 넘깁니다.
코드
model_params = {'n_estimators': 400,'max_depth': 4,'min_samples_split': 10,'learning_rate': 0.01,'loss': 'ls'}features = ["region", "income", "age"]target ="net_value"np.random.seed(123)reg = ensemble.GradientBoostingRegressor(**model_params)# fit model on the training setencoded_train = train[features].pipe(encode)reg.fit(encoded_train, train[target]);
이제 모델 훈련이 끝났습니다. 다음으로 모델이 쓸 만한지 확인해야 합니다. 그러려면 테스트 셋에서 이 모델의 예측 성능을 보면 됩니다. 머신러닝 모델의 예측 성능을 평가하는 지표는 아주 많습니다. 여기서는 \(R^2\)라는 지표를 쓰겠습니다. 자세히 들어갈 필요는 없습니다. \(R^2\)는 (net_income처럼) 연속형 변수를 예측하는 모델을 평가할 때 쓴다는 정도만 알면 충분합니다. 또 \(R^2\)는 음의 무한대(예측이 평균보다 못하면 음수가 됩니다)부터 1.0까지의 값을 가질 수 있습니다. \(R^2\)는 net_income의 분산 가운데 얼마만큼을 모델이 설명하는지 알려 줍니다.
Train R2:  0.7108790300152951
Test R2:  0.6938513063048141
이 경우 모델은 훈련 셋에서 net_income 분산의 약 71%를 설명하지만, 테스트 셋에서는 약 69%만 설명합니다. 예상한 결과입니다. 모델은 훈련 셋을 보고 학습했으므로 훈련 셋에서의 성능은 대개 과대평가됩니다. 재미 삼아(그리고 과적합을 더 잘 이해하기 위해) 모델의 ’max_depth’를 14로 바꿔 보고 어떻게 되는지 확인해 보세요. 훈련 셋의 \(R^2\)는 치솟지만 테스트 셋의 \(R^2\)는 오히려 낮아질 것입니다. 이것이 과적합의 모습입니다.
다음으로 정책을 만들기 위해 테스트 셋의 예측값을 prediction 열에 저장합니다. 이 예측값은 \(E[NetValue|Age, Income, Region ]\)의 추정값입니다.
힌트옮긴이
직접 ’max_depth’를 14로 바꿔 실행해 보면 훈련 셋에서는 약 0.92, 테스트 셋에서는 약 0.63이 나옵니다.
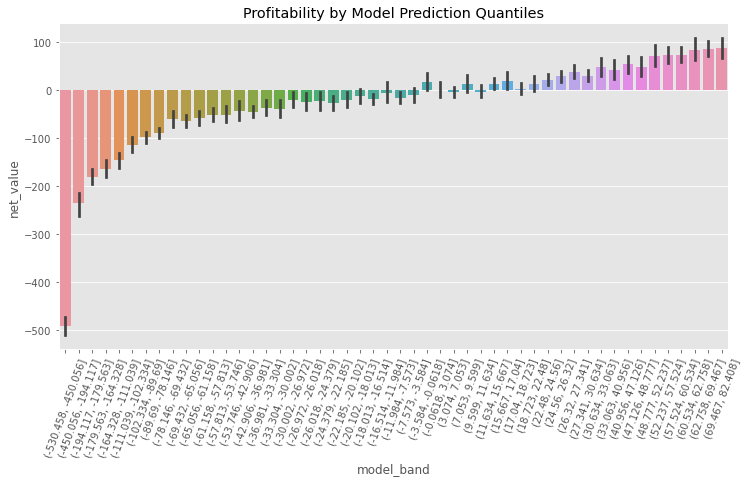
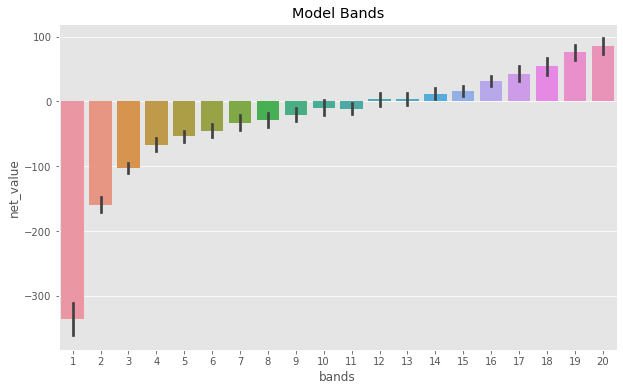
regions 특성에서 했던 것처럼 모델 예측값별 평균 순가치를 볼 수 있습니다. 모델 예측값은 범주형이 아니라 연속형이므로 먼저 이산화해야 합니다. 한 가지 방법은 판다스의 pd.qcut(세상에, 저는 이 함수가 정말 좋습니다!)을 쓰는 것입니다. 이 함수는 모델 예측값을 기준으로 데이터를 분위수로 나눕니다. 지역이 50개였으니 분위수도 50개를 쓰겠습니다. 그리고 관례상 저는 이런 모델 분위수를 모델 구간이라고 부르는 편입니다. 한 그룹에 속한 모델 예측값이 가령 -10에서 200 같은 하나의 띠(band) 안에 들어 있다는 직관을 주기 때문입니다.
코드
plt.figure(figsize=(12,6))n_bands =50bands = [f"band_{b}"for b inrange(1,n_bands+1)]np.random.seed(123)model_plot = sns.barplot(data=model_policy .assign(model_band = pd.qcut(model_policy["prediction"], q=n_bands)), x="model_band", y="net_value")plt.title("Profitability by Model Prediction Quantiles")plt.xticks(rotation=70);
모델 구간 가운데에는 순가치가 크게 음수인 구간도 있고, 크게 양수인 구간도 있습니다. 순가치가 음수인지 양수인지 정확히 알 수 없는 구간도 있습니다. 마지막으로 왼쪽에서 오른쪽으로 갈수록 올라가는 추세가 보입니다. 순가치를 예측하고 있으니, 예측값이 예측 대상에 비례하는 것은 당연합니다.
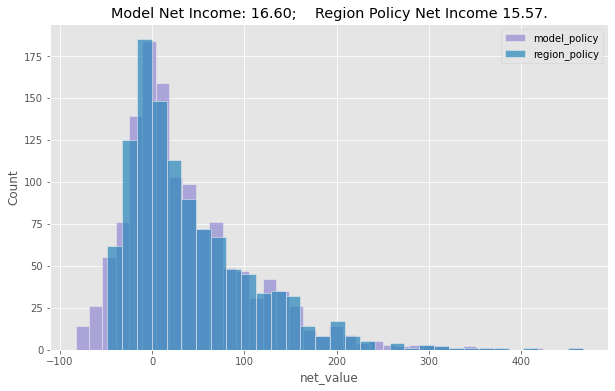
이제 \(\hat{E}[NetValue|Region, Income, Age] > 0\)인 고객을 고르는 모델 정책을 지역만 쓰는 정책과 비교해 보겠습니다. 두 정책의 순이익 히스토그램과 테스트 셋에서의 평균 순가치를 함께 표시합니다.
코드
plt.figure(figsize=(10,6))model_plot_df = (model_policy[model_policy["prediction"]>0])sns.histplot(data=model_plot_df, x="net_value", color="C2", label="model_policy")region_plot_df = (model_policy[model_policy["region"].isin(regions_to_invest.keys())])sns.histplot(data=region_plot_df, x="net_value", label="region_policy")plt.title("Model Net Income: %.2f; Region Policy Net Income %.2f."% (model_plot_df["net_value"].sum() / test.shape[0], region_plot_df["net_value"].sum() / test.shape[0]))plt.legend();
보다시피 모델은 region 특성만 쓸 때보다 더 나은 정책을 만들어 내지만, 차이가 크지는 않습니다. 테스트 셋에서 모델 정책은 고객 한 명당 약 16.6헤알을 벌어 줬겠지만, 지역 정책은 고객 한 명당 15.5헤알에 그쳤을 것입니다. 아주 조금 나을 뿐이지만, 고객이 정말 많다면 이 정도만으로도 특성 하나짜리 단순한 정책 대신 모델을 쓸 이유가 충분할 수 있습니다.
더 세밀한 정책
지금까지를 정리해 보겠습니다. 먼저 모든 정책 중 가장 단순한 정책, 즉 모든 고객과 거래하는 정책을 시험했습니다. 이 정책은 주변 순가치(marginal net value)를 추정하는 것, 즉 \(\hat{E}[NetValue] > 0\)으로 볼 수 있습니다. 이 정책이 통하지 않자(고객 한 명당 평균 순이익이 음수였습니다), 지역을 기반으로 한 단일 특성 정책을 만들었습니다. 어떤 지역과는 거래하고 다른 지역과는 거래하지 않는 정책, 즉 \(\hat{E}[NetValue|Region] > 0\)입니다. 이것만으로도 이미 아주 좋은 결과를 얻었습니다. 그다음에는 모든 특성을 쓰는 예측 모델, 즉 \(\hat{E}[NetValue|Region, Income, Age] > 0\)으로 머신러닝을 본격적으로 활용했습니다. 그리고 그 모델을 정책의 입력으로 삼아, 순이익 예측값이 0보다 큰 모든 고객과 거래하기로 했습니다.
여기서 정책이 내리는 결정은 아주 단순합니다. 고객과 거래하거나, 거래하지 않거나입니다. 지금까지의 정책은 이처럼 이진 결정을 다뤘고, 다음과 같은 형태였습니다.
if prediction > 0 then do business else don't do business.
이런 방식을 임곗값 설정(thresholding)이라고 합니다. 예측값이 어떤 임곗값(여기서는 0이지만 다른 값일 수도 있습니다)을 넘으면 한 가지 결정을 내리고, 넘지 않으면 다른 결정을 내립니다. 현실에서 이를 적용할 수 있는 다른 예로 거래 사기 탐지가 있습니다. 사기를 탐지하는 모델의 예측 점수가 어떤 임곗값 X보다 높으면 거래를 거절하고, 그렇지 않으면 승인합니다.
임곗값 설정은 많은 실제 상황에서 잘 통하며, 특히 결정 자체가 이진적일 때 유용합니다. 하지만 상황이 좀 더 미묘한 경우도 생각해 볼 수 있습니다. 예를 들어 수익성이 아주 높은 고객의 관심을 끌기 위해 마케팅에 더 많이 쓸 의향이 있을 수 있습니다. 또는 그런 고객을 우수 고객 목록에 올려 특별 대우를 하고 싶을 수도 있는데, 그러려면 비용도 더 듭니다. 이런 가능성까지 포함하면 결정은 이진(거래한다 대 거래하지 않는다)에서 연속(고객에게 얼마를 투자할 것인가)으로 바뀝니다.
다음 예에서는 누구와 거래할지만이 아니라 고객마다 마케팅 비용을 얼마나 투자할지를 결정해야 한다고 해 봅시다. 그리고 예시를 위해 다른 회사들과 경쟁하고 있으며, 특정 고객에게 마케팅 비용을 더 많이 쓰는 쪽이 그 고객을 차지한다고 가정합니다(입찰 방식과 매우 비슷합니다). 이 경우 수익성이 높은 고객에게는 더 많이, 수익이 겨우 나는 고객에게는 더 적게 투자하고, 수익을 내지 못하는 고객에게는 전혀 투자하지 않는 것이 합리적입니다.
한 가지 방법은 예측값을 여러 구간으로 이산화하는 것입니다. 앞에서 모델 비교를 위해 이미 해 봤지만, 이번에는 의사결정을 위해 합니다. 구간을 20개 만들어 보겠습니다. 각 구간은 분위수, 즉 크기가 같은 그룹으로 생각할 수 있습니다. 첫 번째 구간에는 예측값 기준으로 수익성이 가장 낮은 5%의 고객이, 두 번째 구간에는 하위 5%에서 10% 사이의 고객이 들어가는 식입니다. 마지막 20번 구간에는 수익성이 가장 높은 고객이 들어갑니다.
구간을 나누는 기준 역시 훈련 셋에서 추정하고 테스트 셋에 적용해야 한다는 점에 유의하세요! 그래서 구간 경계는 훈련 셋에서 pd.qcut으로 계산합니다. 실제로 고객을 구간에 나눠 넣을 때는 np.digitize에 훈련 셋에서 미리 계산한 구간 경계를 넘깁니다.
코드
def model_binner(prediction_column, bins):# find the bins according to the training set bands = pd.qcut(prediction_column, q=bins, retbins=True)[1]def binner_function(prediction_column):return np.digitize(prediction_column, bands)return binner_function# train the binning functionbinner_fn = model_binner(train_pred["predictions"], 20)# apply the binningmodel_band = model_policy.assign(bands = binner_fn(model_policy["prediction"]))model_band.head()
이렇게 나눈 구간을 이용하면 마케팅 투자의 대부분을 20번과 19번 구간에 배정할 수 있습니다. 이진 결정(거래한다 대 거래하지 않는다)에서 연속적인 결정(고객마다 마케팅에 얼마를 투자할 것인가)으로 넘어갔다는 점에 주목하세요. 물론 구간을 더 늘려 더 세밀하게 조정할 수도 있습니다. 그 극한에서는 구간을 아예 나누지 않게 됩니다. 대신 모델의 예측값을 그대로 쓰면서 다음과 같은 의사결정 규칙을 만들 수 있습니다.
mkt_investments_i = model_prediction_i * 0.3
여기서는 고객 \(i\)마다 모델이 예측한 net_value의 30%를 투자합니다(30%는 임의로 정한 숫자지만, 무슨 뜻인지는 충분히 알 것입니다).
핵심 요약
아주 짧은 시간에 정말 많은 내용을 다뤘으니, 무엇을 해냈는지 되짚어 보는 이 요약이 특히 중요하다고 생각합니다. 먼저 머신러닝 응용 대부분이 결국 좋은 예측을 하는 일에 지나지 않는다는 점을 배웠습니다. 여기서 예측이란 알려진 입력을, 처음에는 알 수 없지만 잘 정의된 출력으로 대응시키는 일을 말합니다. 예측을 기댓값 함수 \(E[Y|X]\)를 추정하는 일로 이해할 수도 있습니다. 하지만 “지나지 않는다”는 말은 썩 공정하지 않습니다. 언어 번역이나 자율주행 자동차처럼, 좋은 예측이 언뜻 생각하는 것보다 훨씬 많은 문제를 풀 수 있다는 것도 확인했기 때문입니다.
그런 다음 다시 현실로 내려와, 어떤 고객을 받아들이고 어떤 고객을 피할지 알아내는 것처럼 더 흔한 과제에 좋은 예측이 어떻게 도움이 되는지 살펴봤습니다. 구체적으로는 고객이 낼 수익을 예측하고, 그 예측을 바탕으로 누구와 거래할지 결정하는 정책을 만들었습니다. 이것은 예측 모델을 적용할 수 있는 사례 하나일 뿐이라는 점에 유의하세요. 신용카드 발급 심사, 사기 탐지, 암 진단처럼 좋은 예측이 쓸모 있는 곳이라면 어디든 다른 응용 사례가 셀 수 없이 많을 것입니다.
핵심 교훈은 비즈니스 문제를 예측 문제로 정의할 수 있다면 머신러닝이 그 일에 알맞은 도구일 가능성이 높다는 것입니다. 아무리 강조해도 지나치지 않습니다. 머신러닝을 둘러싼 과열된 기대 속에서 사람들이 이 중요한 점을 잊고, 아무짝에도 쓸모없는 것을 아주 잘 예측하는 모델을 만드는 일이 많은 것 같습니다. 비즈니스 문제를 예측 문제로 어떻게 정의할지 고민하고 그다음에 머신러닝으로 푸는 대신, 예측 모델부터 만들어 놓고 그 예측으로 득을 볼 비즈니스 문제가 무엇일지 찾아 나서는 경우가 많습니다. 이 방법이 통할 수도 있지만, 대개는 문제를 찾아 헤매는 해결책만 만들어 내는 어둠 속의 헛발질이 되고 맙니다.
참고 자료
여기 쓴 내용은 대부분 제 머릿속에서 나온 것으로, 경험으로 배운 것들입니다. 그래서 직접 소개할 참고 문헌이 없고, 좋은 과학이라면 보통 거치는 학계의 엄밀한 검증도 통과하지 않았습니다. 실무에서 통하는 것들을 이야기하면서도 왜 그런지는 길게 설명하지 않았다는 점을 눈여겨보세요. 말하자면 길거리 과학인 셈입니다. 대신 누구나 검토할 수 있게 공개해 두었으니, 터무니없는 내용을 발견하면 주저하지 말고 이슈를 열어 주세요. 최선을 다해 답하겠습니다.
마지막으로, 머신러닝을 포괄적이고 자세하게 소개해 주기를 기대한 분들에게는 너무 빨리 지나갔을지도 모르겠습니다. 솔직히 말하면, 제가 정말 가치를 만들어 낼 수 있는 분야는 머신러닝이 아니라 인과추론을 가르치는 일이라고 생각합니다. 머신러닝에 관해서는 제가 꿈꿀 수 있는 것보다 훨씬 좋은 온라인 자료가 넘쳐납니다. 고전으로는 Andrew Ng의 머신러닝 강좌가 있으니, 머신러닝이 처음이라면 꼭 한번 살펴보기를 권합니다.
기여하기
Causal Inference for the Brave and True는 과학의 통계학이라 할 수 있는 인과추론을 다루는 오픈소스 자료입니다. 파이썬 기반의 무료 소프트웨어만 사용하며, 돈이 없어도, 배경지식이 많지 않아도 누구나 볼 수 있는 자료를 목표로 합니다. 이 책이 도움이 되었고 후원하고 싶다면 Patreon을 방문해 주세요. 금전적으로 기여하기 어렵다면 오타를 고치거나, 수정할 부분을 제안하거나, 이해하기 어려웠던 부분에 의견을 주는 것으로도 도울 수 있습니다. 책의 저장소에서 이슈를 열어 주세요. 마지막으로 이 내용이 마음에 들었다면 도움이 될 만한 사람들과 공유하고 GitHub에서 스타를 눌러 주세요.
의견 나누기
번역이 어색한 곳, 더 쉬운 설명, 궁금한 점을 남겨 주세요. GitHub 계정으로 로그인하면 댓글을 달 수 있고, 남긴 의견은 GitHub Discussions에 장별로 모입니다.