코드
import warnings
warnings.filterwarnings('ignore')

import pandas as pd
import numpy as np
import graphviz as gr
from matplotlib import style
import seaborn as sns
from matplotlib import pyplot as plt
style.use("fivethirtyeight")유튜브 요리 영상에 나오는 요리사들이 음식을 얼마나 그럴듯하게 묘사하는지 눈여겨본 적이 있나요? “소스가 벨벳처럼 부드러워질 때까지 졸이세요.” 이제 막 요리를 배우는 사람이라면 이게 대체 무슨 뜻인지 감도 오지 않습니다. 그냥 불에 몇 분 올려 두면 되는지만 알려 주세요! 인과관계도 마찬가지입니다. 어느 술집에 들어갔는데 사람들이 인과관계를 두고 이야기하고 있다고 해 봅시다(아마 경제학과 건물 옆 술집일 겁니다). 그러면 소득이 교란을 일으키는 바람에 그 동네에 이민이 미친 효과를 식별하기 어려웠고, 그래서 도구변수를 써야 했다는 이야기가 들려올 겁니다. 지금은 무슨 말인지 잘 모를 수 있지만, 이 문제를 적어도 일부는 지금 바로 해결해 드리겠습니다.
그래프 모델(graphical model)은 인과관계의 언어입니다. 다른 용감하고 진실한 인과관계 애호가들과 대화할 때 쓰는 언어일 뿐 아니라, 자기 생각을 더 투명하게 정리할 때도 쓰는 도구입니다.
출발점으로 잠재적 결과의 조건부 독립을 예로 들어 보겠습니다. 인과추론을 할 때 성립해야 하는 주요 가정 중 하나입니다.
\[ (Y_0, Y_1) \perp T | X \]
조건부 독립 덕분에 주변에 숨어 있는 다른 변수가 아니라 오로지 처치 때문에 생긴 결과의 변화를 측정할 수 있습니다. 대표적인 예가 아픈 환자에게 약이 미치는 효과입니다. 상태가 아주 심각한 환자만 약을 받는다면, 약을 주는 것이 오히려 환자의 건강을 해치는 것처럼 보일 수도 있습니다. 병의 심각도가 미치는 영향이 약의 효과와 뒤섞이기 때문입니다. 환자를 중증과 경증으로 나누고 각 하위 집단에서 약의 효과를 분석하면 실제 효과를 더 분명하게 볼 수 있습니다. 이렇게 모집단을 특성에 따라 나누는 것을 X를 통제한다(controlling for) 또는 X를 조건부로 둔다(conditioning on)고 합니다. 중증 환자를 조건부로 두면 처치가 배정되는 방식은 무작위나 다름없어집니다. 중증 집단 안의 환자들은 심각도라는 차원에서 모두 같으므로, 이제 약을 받을지 말지는 높은 심각도가 아니라 순전히 우연으로 정해집니다. 그리고 집단 안에서 처치가 무작위로 배정된다면, 처치는 잠재적 결과와 조건부 독립이 됩니다.
독립과 조건부 독립은 인과추론의 핵심입니다. 그런데 이 개념을 머릿속에 제대로 담기란 꽤 어렵습니다. 다만 문제를 설명할 올바른 언어를 쓰면 이야기가 달라집니다. 바로 여기서 그래프 인과 모델(causal graphical model)이 등장합니다. 그래프 인과 모델은 무엇이 무엇의 원인이 되는지를 바탕으로 인과관계가 어떻게 작동하는지 표현하는 방법입니다.
그래프 모델은 다음과 같이 생겼습니다.
import warnings
warnings.filterwarnings('ignore')
import pandas as pd
import numpy as np
import graphviz as gr
from matplotlib import style
import seaborn as sns
from matplotlib import pyplot as plt
style.use("fivethirtyeight")g = gr.Digraph()
g.edge("Z", "X")
g.edge("U", "X")
g.edge("U", "Y")
g.edge("medicine", "survived")
g.edge("severeness", "survived")
g.edge("severeness", "medicine")
g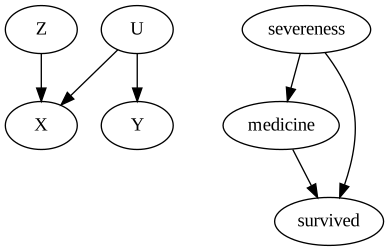
각 노드는 확률변수입니다. 화살표, 즉 엣지(edge)로 한 변수가 다른 변수의 원인인지를 나타냅니다. 위의 첫 번째 그래프 모델은 Z가 X의 원인이고, U가 X와 Y의 원인이라는 뜻입니다. 좀 더 구체적인 예로, 약이 환자의 생존에 미치는 영향을 어떻게 보는지 위의 두 번째 그래프로 옮겨 볼 수 있습니다. 심각도는 약과 생존 모두의 원인이고, 약 역시 생존의 원인입니다. 앞으로 보겠지만, 그래프 인과 모델이라는 언어는 세상이 어떻게 돌아가는지에 대한 믿음을 분명히 드러내 주기 때문에 인과관계를 더 명확하게 생각하는 데 도움이 됩니다.
그래프 모델만 한 학기 내내 다루는 강의도 있습니다. 하지만 이 책의 목적에서는 그래프 모델이 어떤 독립 가정과 조건부 독립 가정을 담고 있는지 이해하는 것이 (아주) 중요합니다. 앞으로 보겠지만, 독립성은 물이 개울을 따라 흐르듯 그래프 모델을 따라 흐릅니다. 그래프 안의 변수를 어떻게 다루느냐에 따라 이 흐름을 막을 수도, 흐르게 할 수도 있습니다. 이를 이해하기 위해 자주 나오는 그래프 구조와 예시를 몇 가지 살펴보겠습니다. 구조 자체는 꽤 단순하지만, 그래프 모델에서 독립과 조건부 독립에 관한 모든 것을 이해하는 데 필요한 기본 재료로는 충분합니다.
먼저 아주 단순한 그래프를 보겠습니다. A가 B의 원인이고, B가 C의 원인입니다. 또는 X가 Y의 원인이고, Y가 Z의 원인입니다.
g = gr.Digraph()
g.edge("A", "B")
g.edge("B", "C")

g.edge("X", "Y")
g.edge("Y", "Z")
g.node("Y", "Y", color="red")


g.edge("causal knowledge", "solve problems")
g.edge("solve problems", "job promotion")

g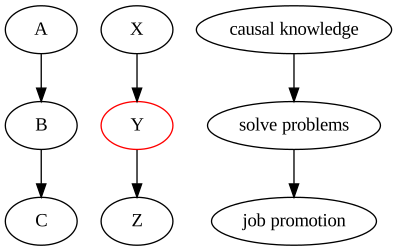
첫 번째 그래프에서 종속성은 화살표 방향을 따라 흐릅니다. 직관적으로는 조금 덜 와닿지만, 종속성은 대칭이라는 점에 주목하세요. 좀 더 구체적인 예를 들어 보겠습니다. 인과추론을 아는 것이 비즈니스 문제를 푸는 유일한 방법이고, 그 문제를 푸는 것이 승진하는 유일한 방법이라고 해 봅시다. 그러면 인과추론 지식이 있어야 문제를 풀 수 있고, 문제를 풀어야 승진합니다. 이때 승진은 인과추론 지식에 종속되어 있다고 말할 수 있습니다. 인과추론 전문성이 높을수록 승진할 가능성도 커집니다. 반대로 승진할 가능성이 클수록 인과추론 지식을 갖췄을 가능성도 큽니다. 그렇지 않다면 승진하기 어려웠을 테니 말입니다.
이제 중간 변수를 조건부로 둔다고 해 봅시다. 이 경우 종속성은 차단됩니다. 즉, Y가 주어지면 X와 Z는 독립입니다. 위 그래프에서 빨간색은 Y가 조건부로 둔 변수라는 뜻입니다. 마찬가지로 앞의 예시에서 여러분이 문제를 잘 푼다는 사실을 이미 안다면, 인과추론을 안다는 사실은 승진 가능성에 관해 아무런 추가 정보도 주지 않습니다. 수식으로 쓰면 \(E[Promotion|Solve \ problems, Causal \ knowledge]=E[Promotion|Solve \ problems]\)입니다. 그 반대도 성립합니다. 문제를 얼마나 잘 푸는지 알고 나면, 승진 여부를 알아도 인과추론을 알 가능성에 관해서는 더 알 수 있는 것이 없습니다.
일반적으로 A에서 C로 곧장 이어지는 경로에 흐르는 종속성은 중간 변수 B를 조건부로 두면 차단됩니다. 즉,
\(A \not \perp C\)
이고
\[ A \perp C | B \]
입니다.
이번에는 분기(fork) 구조를 생각해 보겠습니다. 하나의 변수가 그래프 아래쪽에 있는 다른 두 변수의 원인이 되는 구조입니다. 이 경우 종속성은 화살표를 거슬러 흐르고, 이런 경로를 뒷문 경로(backdoor path)라고 합니다. 공통 원인을 조건부로 두면 뒷문 경로를 닫고 종속성을 끊을 수 있습니다.
g = gr.Digraph()
g.edge("C", "A")
g.edge("C", "B")

g.edge("X", "Y")
g.edge("X", "Z")
g.node("X", "X", color="red")

g.edge("statistics", "causal inference")
g.edge("statistics", "machine learning")

g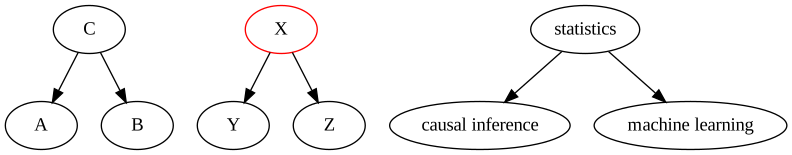
예를 들어, 통계학을 알면 인과추론과 머신러닝도 더 잘 알게 된다고 해 봅시다. 제가 여러분의 통계 지식수준을 모른다면, 인과추론을 잘한다는 사실을 알았을 때 머신러닝도 잘할 가능성이 높다고 판단하게 됩니다. 통계 지식수준을 모르더라도 인과추론 지식으로 짐작할 수 있기 때문입니다. 인과추론을 잘한다면 아마 통계도 잘할 것이고, 그렇다면 머신러닝도 잘할 가능성이 높습니다.
이제 여러분의 통계 지식을 조건부로 두면, 머신러닝을 얼마나 아는지는 인과추론을 얼마나 아는지와 독립이 됩니다. 통계 수준만 알면 머신러닝 실력을 짐작하는 데 필요한 정보는 이미 다 얻은 셈입니다. 이 경우 인과추론 수준을 알아도 더 얻을 정보는 없습니다.
일반적으로 공통 원인을 공유하는 두 변수는 종속이지만, 공통 원인을 조건부로 두면 독립입니다. 즉,
\(A \not \perp B\)
이고
\[ A \perp B | C \]
입니다.
마지막으로 남은 구조는 충돌부(collider)입니다. 충돌부는 두 화살표가 한 변수에서 부딪히는 구조입니다. 이 경우 두 변수가 공통 효과를 공유한다고 말할 수 있습니다.
g = gr.Digraph()
g.edge("B", "C")
g.edge("A", "C")

g.edge("Y", "X")
g.edge("Z", "X")
g.node("X", "X", color="red")

g.edge("statistics", "job promotion")
g.edge("flatter", "job promotion")

g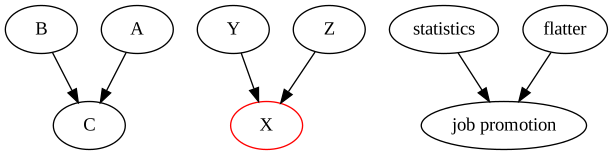
예를 들어, 승진하는 방법이 두 가지 있다고 해 봅시다. 통계를 잘하거나 상사에게 아부를 잘하면 됩니다. 승진을 조건부로 두지 않는다면, 즉 승진할지 말지 전혀 모른다면, 통계 실력과 아부 실력은 독립입니다. 다시 말해 통계를 얼마나 잘하는지 알아도 상사에게 얼마나 아부를 잘하는지는 알 수 없습니다. 반면에 승진했다면, 갑자기 통계 실력만 알아도 아부 실력을 짐작할 수 있게 됩니다. 통계는 못하는데 승진했다면 아부에 능할 가능성이 큽니다. 그렇지 않았다면 승진하지 못했을 테니 말입니다. 반대로 아부를 못한다면 통계를 잘하는 사람임이 틀림없습니다. 이런 현상을 종종 다른 원인으로 설명되어 버리는(explaining away) 현상이라고 부릅니다. 한 원인이 이미 효과를 설명해 버리므로 다른 원인일 가능성이 낮아지기 때문입니다.
일반적으로 충돌부를 조건부로 두면 종속 경로가 열립니다. 조건부로 두지 않으면 경로는 닫힌 채로 남습니다. 즉,
\(A \perp B\)
이고
\[ A \not \perp B | C \]
입니다.
이 세 가지 구조를 알면 훨씬 더 일반적인 규칙을 끌어낼 수 있습니다. 경로는 다음 조건 중 하나를 만족할 때, 그리고 그때에만 차단됩니다. 1. 조건부로 둔 비충돌부가 경로에 있다. 2. 조건부로 두지 않았고, 조건부로 둔 자손도 없는 충돌부가 경로에 있다.
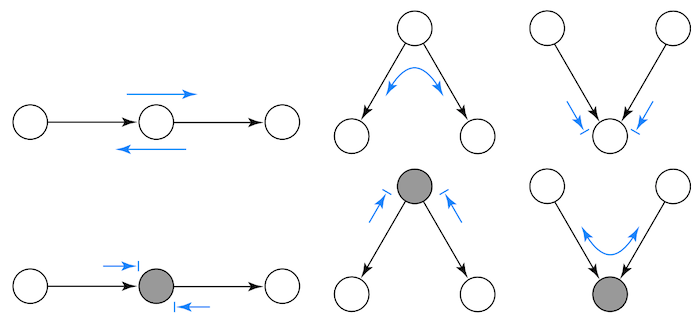
다음은 그래프에서 종속성이 어떻게 흐르는지 정리한 치트 시트입니다. Mark Paskin의 스탠퍼드 강의 자료에서 가져왔습니다. 끝에 선이 그어진 화살표는 독립을, 선이 없는 화살표는 종속을 뜻합니다.
마지막 예제로, 다음 인과 그래프에서 독립 관계와 종속 관계를 찾아보세요. 1. \(D \perp C\)인가요? 2. \(D \perp C| A\)인가요? 3. \(D \perp C| G\)인가요? 4. \(A \perp F\)인가요? 5. \(A \perp F|E\)인가요? 6. \(A \perp F|E,C\)인가요?
g = gr.Digraph()
g.edge("C", "A")
g.edge("C", "B")
g.edge("D", "A")
g.edge("B", "E")
g.edge("F", "E")
g.edge("A", "G")

g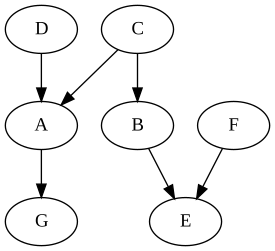
정답: 1. \(D \perp C\). 조건부로 두지 않은 충돌부가 경로에 있습니다. 2. \(D \not\perp C| A\). 조건부로 둔 충돌부가 경로에 있습니다. 3. \(D \not\perp C| G\). 경로에 있는 충돌부의 자손을 조건부로 두었습니다. 여기서 G는 A의 일종의 대리변수로 볼 수 있습니다. 4. \(A \perp F\). 경로에 조건부로 두지 않은 충돌부 B->E<-F가 있습니다. 5. \(A \not\perp F|E\). 경로에 조건부로 둔 충돌부 B->E<-F가 있습니다. 6. \(A \perp F|E, C\). 경로에 조건부로 둔 충돌부 B->E<-F가 있지만, 조건부로 둔 비충돌부도 있습니다. E를 조건부로 두면 경로가 열리지만, C를 조건부로 두면 다시 닫힙니다.
그래프 인과 모델을 알면 인과추론에서 생기는 문제를 이해할 수 있습니다. 앞서 보았듯이 문제는 언제나 편향(bias)으로 귀결됩니다.
\[ E[Y|T=1] - E[Y|T=0] = \underbrace{E[Y_1 - Y_0|T=1]}_{ATET} + \underbrace{\{ E[Y_0|T=1] - E[Y_0|T=0] \}}_{BIAS} \]
그래프 모델을 쓰면 지금 어떤 편향을 다루고 있는지, 그 편향을 바로잡으려면 어떤 도구가 필요한지 진단할 수 있습니다.
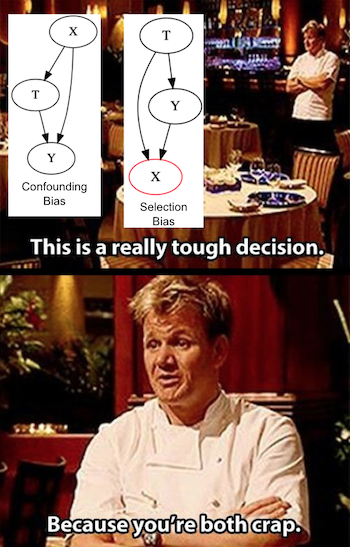
편향의 첫 번째 주요 원인은 교란(confounding)입니다. 교란은 처치와 결과가 공통 원인을 공유할 때 생깁니다. 예를 들어 처치가 교육이고 결과가 소득이라고 해 봅시다. 교육이 임금에 미치는 인과효과는 알아내기 어려운데, 둘 다 지능이라는 공통 원인을 공유하기 때문입니다. 그래서 교육을 많이 받은 사람이 돈을 더 버는 것은 교육을 더 받아서가 아니라 그저 더 똑똑하기 때문이라고 주장할 수도 있습니다. 인과효과를 식별하려면 처치와 결과 사이의 뒷문 경로를 모두 닫아야 합니다. 그렇게 하면 남는 효과는 T->Y라는 직접 효과뿐입니다. 이 예에서 지능을 통제한다면, 즉 지능 수준은 같지만 교육 수준이 다른 사람들을 비교한다면, 모두 지능이 같으므로 결과의 차이는 오로지 교육 수준의 차이에서 비롯됩니다. 교란편향을 바로잡으려면 처치와 결과의 공통 원인을 모두 통제해야 합니다.
g = gr.Digraph()
g.edge("X", "T")
g.edge("X", "Y")
g.edge("T", "Y")

g.edge("Intelligence", "Educ"),
g.edge("Intelligence", "Wage"),
g.edge("Educ", "Wage")
g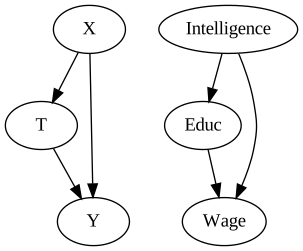
안타깝게도 공통 원인을 모두 통제할 수 있는 것은 아닙니다. 알려지지 않은 원인이 있을 수도 있고, 알고는 있지만 측정할 수 없는 원인이 있을 수도 있습니다. 지능은 후자에 해당합니다. 온갖 노력에도 불구하고 과학자들은 아직 지능을 제대로 측정하는 방법을 찾지 못했습니다. 여기서는 측정되지 않은 변수를 U로 표시하겠습니다. 이제 잠시 지능이 교육 수준에 직접 영향을 줄 수는 없다고 가정해 봅시다. 지능은 SAT 점수에 영향을 주고, SAT는 좋은 대학에 갈 가능성을 열어 주므로 교육 수준을 결정합니다. 측정할 수 없는 지능은 통제하지 못하더라도, SAT를 통제하면 그 뒷문 경로를 닫을 수 있습니다.
g = gr.Digraph()
g.edge("X1", "T")
g.edge("T", "Y")
g.edge("X2", "T")
g.edge("X1", "Y")
g.edge("U", "X2")
g.edge("U", "Y")

g.edge("Family Income", "Educ")
g.edge("Educ", "Wage")
g.edge("SAT", "Educ")
g.edge("Family Income", "Wage")
g.edge("Intelligence", "SAT")
g.edge("Intelligence", "Wage")
g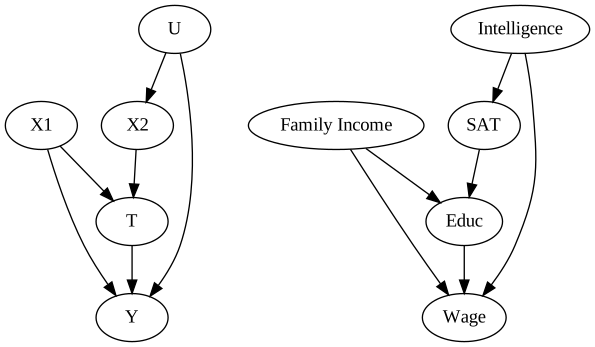
위 그래프에서는 X1과 X2, 즉 SAT와 가구 소득을 조건부로 두는 것만으로 처치와 결과 사이의 뒷문 경로를 모두 닫을 수 있습니다. 다시 말해 \((Y_0, Y_1) \perp T | X1, X2\)입니다. 따라서 공통 원인을 모두 측정할 수 없더라도, 측정되지 않은 변수가 처치에 미치는 영향을 매개하는 측정 가능한 변수를 통제하면 여전히 조건부 독립을 얻을 수 있습니다. 짧게 덧붙이면 \((Y_0, Y_1) \perp T | X1, U\)도 성립하지만, U는 관측할 수 없으므로 조건부로 둘 수 없습니다.
그런데 이런 경우가 아니라면 어떨까요? 측정되지 않은 변수가 처치와 결과의 직접적인 원인이라면요? 다음 예에서는 이제 지능이 교육과 소득의 원인입니다. 그래서 처치인 교육과 결과인 임금의 관계에 교란이 생깁니다. 이 경우 교란 요인(confounder)은 측정할 수 없으므로 통제할 수도 없습니다. 하지만 교란 요인의 대리변수 역할을 할 수 있는 다른 측정 변수들이 있습니다. 이 변수들은 뒷문 경로 위에 있지 않지만, 통제하면 편향을 줄이는 데 도움이 됩니다(편향을 없애지는 못합니다). 이런 변수를 대리 교란 요인(surrogate confounder)이라고 부르기도 합니다.
이 예에서 지능은 측정할 수 없지만, 아버지와 어머니의 학력처럼 지능의 원인이 되는 변수나 IQ, SAT 점수처럼 지능의 결과로 나타나는 변수는 측정할 수 있습니다. 이런 대리변수를 통제하는 것만으로는 편향을 없애기에 충분하지 않지만 도움은 됩니다.
g = gr.Digraph()
g.edge("X", "U")
g.edge("U", "T")
g.edge("T", "Y")
g.edge("U", "Y")

g.edge("Intelligence", "IQ")
g.edge("Intelligence", "SAT")
g.edge("Father's Educ", "Intelligence")
g.edge("Mother's Educ", "Intelligence")

g.edge("Intelligence", "Educ")
g.edge("Educ", "Wage")
g.edge("Intelligence", "Wage")

g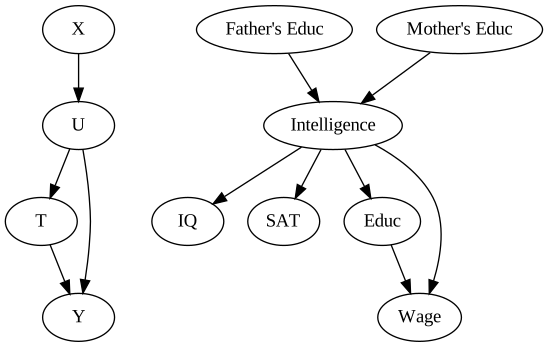
교란편향이 생기지 않도록 측정할 수 있는 것은 전부 모델에 넣는 게 좋겠다고 생각할 수도 있습니다. 글쎄요, 다시 생각해 보세요.
편향의 두 번째 주요 원인은 여기서 선택편향(selection bias)이라고 부를 현상입니다. 저는 선택편향과 교란편향을 구분하는 것이 도움이 된다고 생각하므로 이 구분을 따르겠습니다. 교란편향이 공통 원인을 통제하지 않을 때 생긴다면, 선택편향은 효과 쪽과 더 관련이 있습니다. 한 가지 주의할 점은, 경제학자들은 온갖 종류의 편향을 다 선택편향이라고 부르는 경향이 있다는 것입니다.
선택편향은 통제해야 할 변수보다 더 많은 변수를 통제할 때 자주 생깁니다. 처치와 잠재적 결과가 주변적으로(marginally) 독립이더라도, 충돌부를 조건부로 두는 순간 종속이 될 수 있습니다.
어떤 기적이 일어나 마침내 교육을 무작위로 배정해서 교육이 임금에 미치는 효과를 측정할 수 있게 되었다고 상상해 봅시다. 그런데 교란이 없다는 것을 확실히 하려고 여러 변수를 통제합니다. 그중에는 투자도 있습니다. 하지만 투자는 교육과 임금의 공통 원인이 아닙니다. 오히려 둘 모두의 결과입니다. 교육을 많이 받은 사람은 돈도 더 벌고 투자도 더 많이 합니다. 또 돈을 많이 버는 사람은 투자도 더 많이 합니다. 투자는 충돌부이므로, 투자를 조건부로 두면 처치와 결과 사이에 두 번째 경로가 열리고 직접 효과를 측정하기가 더 어려워집니다. 이렇게 생각해 볼 수 있습니다. 투자를 통제하면 투자 수준이 같은 작은 집단들을 들여다보고 각 집단 안에서 교육의 효과를 찾게 됩니다. 그런데 그러면서 의도치 않게 간접적으로 임금이 크게 변하지 못하도록 막게 됩니다. 결국 임금이 마땅히 변해야 할 만큼 변하지 못하게 막았으니, 교육이 임금을 어떻게 바꾸는지 볼 수 없게 됩니다.
g = gr.Digraph()
g.edge("T", "X")
g.edge("T", "Y")
g.edge("Y", "X")
g.node("X", "X", color="red")

g.edge("Educ", "Investments")
g.edge("Educ", "Wage")
g.edge("Wage", "Investments")

g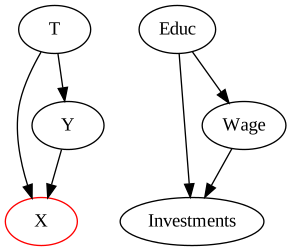
왜 그런지 보여 주기 위해 투자와 교육이 두 가지 값만 가진다고 해 봅시다. 사람들은 투자를 하거나 하지 않습니다. 교육을 받았거나 받지 않았습니다. 처음에 투자를 통제하지 않았을 때는 교육을 무작위로 배정했으므로 편향 항이 0, 즉 \(E[Y_0|T=1] - E[Y_0|T=0] = 0\)입니다. 즉, 교육을 받지 않았다면 받았을 임금 \(Wage_0\)는 실제로 교육이라는 처치를 받았든 받지 않았든 같습니다. 그런데 투자를 조건부로 두면 어떻게 될까요?
투자하는 사람들을 보면 아마 \(E[Y_0|T=0, I=1] > E[Y_0|T=1, I=1]\)일 것입니다. 말로 풀면, 투자하는 사람 중에서 교육을 받지 않고도 투자할 수 있었던 사람은 교육 수준과 관계없이 높은 소득을 올릴 가능성이 큽니다. 그래서 이들이 받는 임금 \(Wage_0|T=0\)은 교육받은 집단이 교육을 받지 않았다면 받았을 임금 \(Wage_0|T=1\)보다 높을 가능성이 큽니다. 투자하지 않는 사람들에게도 비슷한 논리를 적용할 수 있고, 여기서도 아마 \(E[Y_0|T=0, I=0] > E[Y_0|T=1, I=0]\)일 것입니다. 교육을 받고도 투자하지 않은 사람은, 만약 교육을 받지 않았다면 교육도 받지 않고 투자도 하지 않은 사람보다 임금이 낮았을 가능성이 큽니다.
순수하게 그래프로만 따지면, 어떤 사람이 투자한다는 것을 알 때, 학력이 높다는 사실만으로 투자가 설명되므로 또 다른 원인인 임금은 설명에서 밀려납니다. 투자를 조건부로 두면 높은 학력은 낮은 임금과 연관되고, \(E[Y_0|T=0, I=i] > E[Y_0|T=1, I=i]\)라는 음의 편향이 생깁니다.
덧붙이면, 지금까지 이야기한 내용은 공통 효과의 자손을 조건부로 두어도 모두 똑같이 성립합니다.
g = gr.Digraph()
g.edge("T", "X")
g.edge("T", "Y")
g.edge("Y", "X")
g.edge("X", "S")
g.node("S", "S", color="red")
g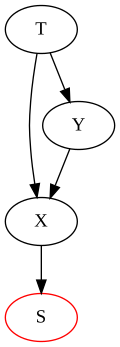
처치의 매개자(mediator)를 조건부로 둘 때도 비슷한 일이 생깁니다. 매개자는 처치와 결과 사이에 있는 변수입니다. 이름 그대로 인과효과를 매개하는 변수입니다. 예를 들어 이번에도 교육을 무작위로 배정할 수 있다고 해 봅시다. 그런데 혹시 몰라서 그 사람이 사무직인지 여부를 통제하기로 합니다. 이번에도 이렇게 조건부로 두면 인과효과 추정값이 편향됩니다. 다만 이번에는 충돌부 때문에 앞문 경로가 열려서가 아니라, 처치가 작용하는 통로 중 하나를 닫아 버리기 때문입니다. 이 예에서 사무직 일자리를 얻는 것은 교육을 많이 받으면 임금이 높아지는 통로 중 하나입니다. 이것을 통제하면 이 통로가 닫히고, 교육이 임금에 미치는 직접 효과만 열린 채로 남습니다.
g = gr.Digraph()
g.edge("T", "X")
g.edge("T", "Y")
g.edge("X", "Y")
g.node("X", "X", color="red")

g.edge("educ", "white collar")
g.edge("educ", "wage")
g.edge("white collar", "wage")

g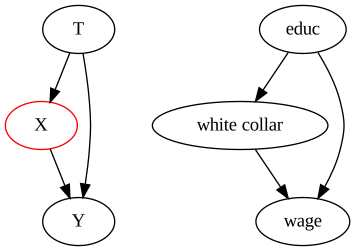
잠재적 결과로 설명해 보겠습니다. 무작위 배정 덕분에 편향은 0, 즉 \(E[Y_0|T=0] - E[Y_0|T=1] = 0\)입니다. 하지만 사무직인 사람들을 조건부로 두면 \(E[Y_0|T=0, WC=1] > E[Y_0|T=1, WC=1]\)이 됩니다. 교육 없이도 사무직 일자리를 얻은 사람은 같은 직업을 얻는 데 교육의 도움이 필요했던 사람보다 아마 더 성실할 것이기 때문입니다. 같은 논리로 \(E[Y_0|T=0, WC=0] > E[Y_0|T=1, WC=0]\)입니다. 교육을 받고도 사무직 일자리를 얻지 못한 사람은 교육을 받지 않았고 사무직 일자리도 얻지 못한 사람보다 아마 덜 성실할 것이기 때문입니다.
이 경우 매개자를 조건부로 두면 음의 편향이 생깁니다. 교육의 효과가 실제보다 작아 보이게 됩니다. 인과효과가 양수이기 때문에 이렇게 됩니다. 효과가 음수였다면 매개자를 조건부로 둘 때 양의 편향이 생겼을 것입니다. 어느 경우든 이렇게 조건부로 두면 효과가 실제보다 약해 보입니다.
좀 더 일상적인 예로 말해 보겠습니다. 회사에서 두 지원자 중 한 명을 뽑아야 한다고 해 봅시다. 두 사람의 경력상 성과는 똑같이 인상적인데, 한 사람은 고등교육 학위가 없습니다. 누구를 뽑아야 할까요? 당연히 고등교육을 받지 않은 사람입니다. 불리한 조건을 딛고 다른 사람과 같은 성과를 냈기 때문입니다.
인과관계에 관한 생각을 더 잘 이해하고 표현하는 언어로서 그래프 모델을 공부했습니다. 그래프에서 조건부 독립이 성립하는 규칙을 빠르게 정리했고, 이를 바탕으로 편향을 일으킬 수 있는 세 가지 구조를 살펴보았습니다.
첫 번째는 교란으로, 처치와 결과에 공통 원인이 있는데 이를 고려하거나 통제하지 않을 때 생깁니다. 두 번째는 공통 효과를 조건부로 두어서 생기는 선택편향입니다. 세 번째 구조도 선택편향의 한 형태인데, 이번에는 매개자를 지나치게 통제해서 생깁니다. 이런 과잉 통제는 처치를 무작위로 배정했더라도 편향을 일으킬 수 있습니다. 선택편향은 그냥 아무것도 하지 않으면 해결되는 경우가 많은데, 바로 그래서 위험합니다. 우리는 뭔가 행동하는 쪽으로 편향되어 있다 보니, 무언가를 통제하자는 아이디어가 득보다 실이 클 때도 영리한 생각처럼 보이기 쉽습니다.
저는 이 책 전체를 Joshua Angrist, Alberto Abadie, Christopher Walters의 훌륭한 계량경제학 강의에 바치는 헌사라고 생각합니다. 이 책에 담긴 아이디어 대부분은 이들이 미국경제학회(American Economic Association)에서 한 강의에서 가져왔습니다. 힘든 2020년을 버틸 수 있는 것도 이 강의들을 보는 덕분입니다. * Cross-Section Econometrics * Mastering Mostly Harmless Econometrics
Angrist의 멋진 책들도 참고 자료로 소개하고 싶습니다. 이 책들 덕분에 계량경제학, 이들 표현으로는 ’Metrics가 아주 유용할 뿐 아니라 무척 재미있다는 것을 알게 되었습니다.
마지막 참고 자료는 Miguel Hernan과 Jamie Robins의 책입니다. 까다로운 인과적 질문에 답해야 할 때마다 믿음직한 동반자가 되어 주었습니다.
Causal Inference for the Brave and True는 과학의 통계학이라 할 수 있는 인과추론을 다루는 오픈소스 자료입니다. 파이썬 기반의 무료 소프트웨어만 사용하며, 돈이 없어도, 배경지식이 많지 않아도 누구나 볼 수 있는 자료를 목표로 합니다. 이 책이 도움이 되었고 후원하고 싶다면 Patreon을 방문해 주세요. 금전적으로 기여하기 어렵다면 오타를 고치거나, 수정할 부분을 제안하거나, 이해하기 어려웠던 부분에 의견을 주는 것으로도 도울 수 있습니다. 책의 저장소에서 이슈를 열어 주세요. 마지막으로 이 내용이 마음에 들었다면 도움이 될 만한 사람들과 공유하고 GitHub에서 스타를 눌러 주세요.
한국어판의 오역이나 오탈자는 한국어판 이슈 페이지에 알려 주세요. 한국어판이 도움이 되었다면 한국어판 저장소에도 스타를 부탁드립니다.
의견 나누기
번역이 어색한 곳, 더 쉬운 설명, 궁금한 점을 남겨 주세요. GitHub 계정으로 로그인하면 댓글을 달 수 있고, 남긴 의견은 GitHub Discussions에 장별로 모입니다.