import warningswarnings.filterwarnings('ignore')import pandas as pdimport numpy as npfrom matplotlib import stylefrom matplotlib import pyplot as pltimport statsmodels.formula.api as smfimport graphviz as grfrom linearmodels.datasets import wage_panel%matplotlib inlinepd.set_option("display.max_columns", 6)style.use("fivethirtyeight")
이전 장에서는 아주 단순한 이중차분법(DID) 설정을 살펴봤습니다. 실험군 포르투알레그리(POA)와 대조군 플로리아노폴리스(FLN)가 하나씩 있고, 기간도 개입 전과 개입 후 두 개뿐이었습니다. 그런데 기간이 더 많다면 어떻게 될까요? 그룹이 더 많다면요? 이런 설정은 인과추론에서 워낙 흔하고 강력해서 따로 이름까지 붙어 있습니다. 바로 패널데이터(panel data)입니다. 패널은 같은 대상을 여러 기간에 걸쳐 반복해서 관측한 데이터를 말합니다. 여러 도시나 주의 데이터를 여러 해에 걸쳐 추적할 수 있는 정부 정책 평가에서 자주 볼 수 있습니다. 업계에서도 아주 흔한데, 기업은 사용자 데이터를 몇 주, 몇 달에 걸쳐 추적하기 때문입니다.
이런 데이터 구조를 어떻게 활용하는지 이해하기 위해 먼저 이전 장의 이중차분법 예제를 이어가 보겠습니다. 포르투알레그리에 광고판을 설치하는 것(처치)의 효과를 추정하려던 예제입니다. 이런 오프라인 마케팅 전략이 투자 상품 이용을 늘릴 수 있는지 알아보려는 것이었습니다. 구체적으로는 광고판을 설치하면 투자 계좌의 예금이 얼마나 늘어나는지 알고 싶었습니다.
그 장에서는 DID 추정량을 일종의 대체(imputation) 전략으로 소개했습니다. 광고판을 설치하지 않았다면 포르투알레그리에 무슨 일이 일어났을지를 채워 넣는 전략이었습니다. 개입 후(광고판 설치 후) 포르투알레그리의 반사실적 결과(counterfactual outcome) \(Y_0\)는 개입 전 포르투알레그리의 예금에 증가분을 더한 값으로 대체할 수 있다고 했습니다. 이 증가분은 대조군 도시인 플로리아노폴리스에서 추정했습니다. 표기법을 다시 정리하는 차원에서, 이 반사실적 결과를 추정하는 방법을 수식으로 쓰면 다음과 같습니다.
\[
\underbrace{\widehat{Y_0(1)|D=1}}_{\substack{\text{POA outcome after intervention}} \\ \substack{\text{if no intervention had taken place}}}
= \underbrace{Y_0(0)|D=1}_{\substack{\text{POA outcome}} \\ \substack{\text{before intervention}}}
+ \big( \underbrace{Y_0(1)|D=0}_{\substack{\text{FLN outcome after}} \\ \substack{\text{intervention in POA}}}
- \underbrace{Y_0(0)|D=0}_{\substack{\text{FLN outcome before}} \\ \substack{\text{intervention in POA}}} \big)
\]
여기서 \(t\)는 시간을, \(D\)는 처치를 나타내며(\(t\)는 이미 시간을 가리키므로 처치에는 다른 글자를 씁니다), \(Y_D(t)\)는 기간 \(t\)에서 처치 \(D\)에 대한 잠재적 결과(potential outcome)입니다. 예를 들어 \(Y_0(1)\)은 기간 1에서 처치를 받지 않았을 때의 결과입니다. 이렇게 대체한 잠재적 결과를 이용하면 POA에 대한 처치효과, 즉 실험군에 대한 평균 처치효과(ATT)를 다음과 같이 구할 수 있습니다.
다시 말해, POA에 광고판을 설치한 효과는 광고판을 설치한 뒤 POA에서 관측한 결과에서, 광고판을 설치하지 않았다면 어땠을지에 대한 추정값을 뺀 것입니다. DID가 강력한 이유도 떠올려 보세요. 이 반사실을 추정하는 데 필요한 조건은 POA의 예금 증가가 FLN의 예금 증가와 같아야 한다는 것 하나뿐입니다. 이것이 핵심인 평행 추세(parallel trends) 가정입니다. 이 가정은 뒤에서 아주 중요해지니 꼭 시간을 들여 살펴봐야 합니다.
평행 추세
평행(또는 공통) 추세 가정을 바라보는 한 가지 방법은 이를 일종의 독립성 가정(independence assumption)으로 보는 것입니다. 책 앞부분의 장들에서 다룬 내용을 떠올려 보면, 독립성 가정은 처치 배정이 잠재적 결과와 독립이어야 한다는 가정입니다.
\[
Y_d \perp D
\]
즉, 결과가 높은 대상에 처치를 더 많이 주거나(이러면 효과 추정에 상향 편향이 생깁니다) 결과가 낮은 대상에 처치를 더 많이 주지(하향 편향이 생깁니다) 않는다는 뜻입니다. 덜 추상적으로, 예제에 대입해 보겠습니다. 마케팅 매니저가 이미 예금이 아주 많은 도시에만 광고판을 설치하기로 했다고 해 봅시다. 그러면 나중에 광고판을 설치한 도시에서 예금이 더 많이 나왔으니 마케팅 캠페인은 당연히 대성공이었다고 자랑할 수 있습니다. 도덕적인 문제는 일단 제쳐 두더라도, 이것이 독립성 가정을 위반한다는 것은 알 수 있을 겁니다. \(Y_0\)가 높은 도시에 처치를 주고 있기 때문입니다. 그리고 이 가정을 자연스럽게 확장한 것이 조건부 독립성 가정(conditional independence assumption)이라는 것도 기억해 두세요. 이 가정에서는 잠재적 결과가 처음에는 처치와 독립이 아니어도 괜찮지만, 교란 요인(confounder) \(X\)로 조건화하고 나면 독립이어야 합니다.
\[
Y_d \perp D | X
\]
여기까지는 이미 다 아는 내용입니다. 그런데 이것이 DID와 평행 추세 가정에 정확히 어떻게 연결될까요? 전통적인 독립성 가정이 처치 배정은 잠재적 결과의 수준과 관련이 없어야 한다고 말한다면, 평행 추세 가정은 처치 배정이 시간에 따른 잠재적 결과의 증가와 관련이 없어야 한다고 말합니다. 실제로 평행 추세 가정은 다음과 같이 쓸 수 있습니다.
\[
\big(Y_d(t) - Y_d(t-1) \big) \perp D
\]
수식을 빼고 말하면, 이 가정은 결과 수준이 높거나 낮은 대상에 처치를 배정해도 괜찮다는 뜻입니다. 하면 안 되는 것은 결과가 어떻게 증가하고 있는지를 보고 처치를 배정하는 것입니다. 광고판 예제로 말하면, 원래 예금 수준이 높은 도시에만 광고판을 설치하는 것은 괜찮습니다. 하지만 예금이 가장 빠르게 늘고 있는 도시에만 광고판을 설치해서는 안 됩니다. DID가 실험군의 반사실적 증가분을 대조군의 증가분으로 대체한다는 점을 떠올리면 당연한 이야기입니다. 처치를 받지 않았을 때 실험군이 늘어나는 정도가 대조군이 늘어나는 정도와 다르다면 곤란해집니다.
보이지 않는 것을 통제하기
성향점수(propensity score), 선형회귀, 매칭 같은 방법은 무작위 배정이 아닌 데이터에서 교란을 통제하는 데 매우 뛰어나지만, 한 가지 핵심 가정에 기대고 있습니다. 바로 조건부 비교란성(conditional unconfoundedness)입니다.
\[
(Y_0, Y_1) \perp T | X
\]
말로 풀면, 이 방법들을 쓰려면 모든 교란 요인을 알고 있고 측정할 수 있어서, 그 교란 요인으로 조건화하면 처치를 무작위 배정이나 다름없게 만들 수 있어야 합니다. 큰 문제는 교란 요인을 아예 측정할 수 없을 때가 있다는 점입니다. 예를 들어 노동경제학의 고전적인 문제인, 결혼이 남성의 소득에 미치는 영향을 생각해 봅시다. 기혼 남성이 미혼 남성보다 돈을 더 많이 번다는 것은 경제학에서 잘 알려진 사실입니다. 하지만 이 관계가 인과관계인지는 분명하지 않습니다. 교육 수준이 높은 남성일수록 결혼할 가능성도 높고 소득이 높은 직업을 가질 가능성도 높을 수 있습니다. 그렇다면 교육은 결혼이 소득에 미치는 효과의 교란 요인이 됩니다. 이런 교란 요인이라면 연구 대상자의 교육 수준을 측정해 회귀분석에서 통제하면 됩니다. 하지만 외모라는 또 다른 교란 요인이 있을 수 있습니다. 잘생긴 남성일수록 결혼할 가능성도 높고 보수가 높은 직업을 가질 가능성도 높을 수 있습니다. 안타깝게도 외모는 지능처럼 제대로 측정하기 어려운 특성입니다.
측정되지 않은 교란 요인이 있으면 편향이 생기므로 난처한 상황에 놓입니다. 이 문제를 다루는 한 가지 방법은 앞에서 본 도구변수(instrumental variable)입니다. 하지만 좋은 도구변수를 찾기란 쉽지 않고 창의력도 많이 필요합니다. 그래서 여기서는 도구변수 대신 패널데이터의 구조를 활용해 보겠습니다.
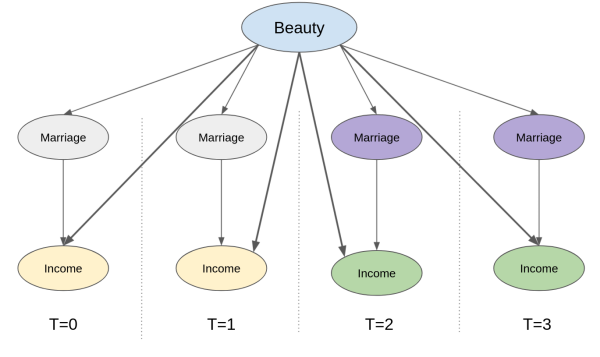
패널데이터를 이용하면 비교란성 가정을 평행 추세 가정으로 바꿀 수 있다는 것은 이미 살펴봤습니다. 그런데 이것이 측정되지 않은 교란 요인 문제에 정확히 어떻게 도움이 될까요? 먼저 시간에 걸쳐 반복 관측이 있는 이 설정을 나타낸 인과 그래프를 보겠습니다. 여기서는 같은 대상을 4개 기간에 걸쳐 추적합니다. 결혼(처치)과 소득(결과)은 시간에 따라 바뀝니다. 구체적으로, 결혼은 기간 3과 4에 켜지고(0에서 1로 바뀌고) 같은 기간에 소득도 늘어납니다. 측정되지 않은 교란 요인인 외모는 모든 기간에서 같습니다(과감한 주장이지만, 기간이 몇 년 정도라면 합리적입니다). 그렇다면 소득이 늘어난 이유가 결혼 때문이지, 단순히 교란 요인인 외모가 나아졌기 때문이 아니라는 것을 어떻게 알 수 있을까요? 그리고 더 중요한 질문으로, 보이지 않는 교란 요인을 어떻게 통제할 수 있을까요?
요령은 이렇습니다. 한 대상을 가까이 들여다보며 시간에 따라 어떻게 변하는지 추적하면, 시간에 따라 변하지 않는 것은 이미 모두 통제하고 있는 셈입니다. 시간에 따라 변하지 않으면서 측정되지 않은 교란 요인도 여기에 포함됩니다. 예를 들어 위 그래프에서 시간에 따라 소득이 늘어난 것이 외모가 나아졌기 때문일 수는 없다는 것을 이미 알 수 있습니다. 외모는 그대로이기 때문입니다(애초에 시간에 따라 고정된 변수니까요). 결론적으로, 외모는 측정할 수 없으니 통제할 수도 없지만, 패널 구조를 이용하면 더 이상 문제가 되지 않습니다.
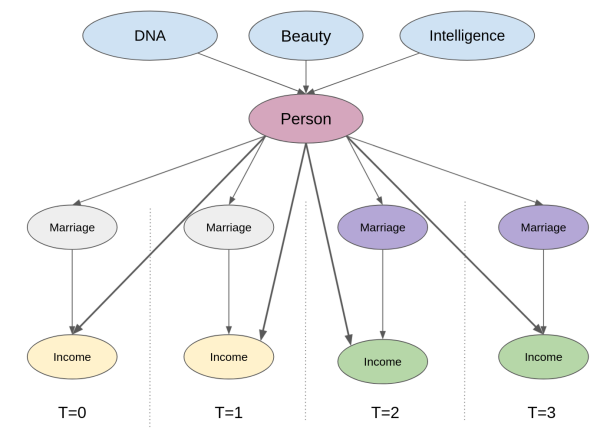
이를 바라보는 또 다른 방법은 시간에 따라 변하지 않는 교란 요인을 각 대상에 고유한 속성으로 생각하는 것입니다. 이는 인과 그래프에 대상을 나타내는 중간 노드를 추가하는 것과 같습니다. 이제 대상 자체를 통제하면, 관측되지 않았지만 시간에 따라 변하지 않는 교란 요인과 결과 사이의 뒷문 경로(backdoor path)가 이미 막힌다는 점에 주목하세요.
생각해 보세요. 외모나 지능 같은 속성은 측정할 수 없지만, 그런 속성을 지닌 사람이 시간이 지나도 같은 사람이라는 것은 알고 있습니다. 이 통제를 실제로 하는 방법은 아주 간단합니다. 그 사람을 나타내는 더미변수(dummy variable)를 만들어 선형 모델에 추가하기만 하면 됩니다. 사람 자체를 통제할 수 있다는 말은 바로 이런 뜻입니다. 특정 인물을 나타내는 변수(여기서는 더미)를 추가하는 것입니다. 이렇게 사람 더미를 넣은 모델로 결혼이 소득에 미치는 효과를 추정하면, 회귀분석은 사람 변수를 고정한 채로 결혼의 효과를 찾습니다. 이처럼 대상 더미를 추가한 모델을 고정효과모델(fixed effect model)이라고 합니다.
고정효과
좀 더 엄밀하게 다루기 위해 먼저 가지고 있는 데이터부터 살펴보겠습니다. 앞의 예제를 이어서 결혼이 소득에 미치는 효과를 추정해 보겠습니다. 데이터에는 여러 개인(nr)을 여러 해에 걸쳐 측정한 married와 lwage 두 변수가 들어 있습니다. 임금은 로그를 취한 값이라는 점에 주의하세요. 이 밖에도 그해 일한 시간, 교육 연수 같은 다른 통제 변수가 있습니다.
코드
data = wage_panel.load()data.head()
nr
year
black
...
lwage
expersq
occupation
0
13
1980
0
...
1.197540
1
9
1
13
1981
0
...
1.853060
4
9
2
13
1982
0
...
1.344462
9
9
3
13
1983
0
...
1.433213
16
9
4
13
1984
0
...
1.568125
25
5
5 rows × 12 columns
일반적으로 고정효과모델은 다음과 같이 정의합니다.
\[
y_{it} = \beta X_{it} + \gamma U_i + e_{it}
\]
여기서 \(y_{it}\)는 시점 \(t\)에서 개인 \(i\)의 결과이고, \(X_{it}\)는 시점 \(t\)에서 개인 \(i\)의 변수 벡터입니다. \(U_i\)는 개인 \(i\)의 관측되지 않는 변수들의 집합입니다. 이 관측되지 않는 변수들은 시간에 따라 변하지 않으므로 시간 첨자가 없다는 점에 주목하세요. 마지막으로 \(e_{it}\)는 오차항입니다. 이 장의 예제라면 \(y_{it}\)는 로그 임금, \(X_{it}\)는 결혼이나 경력처럼 시간에 따라 변하는 관측 변수, \(U_i\)는 외모나 지능처럼 관측되지 않지만 개인마다 일정한 변수입니다.
앞에서 패널데이터로 고정효과모델을 쓰는 것은 대상별 더미를 추가하는 것만큼 간단하다고 했던 것을 기억하나요? 맞는 말이지만, 실무에서는 그렇게 하지 않습니다. 고객이 100만 명인 데이터셋을 떠올려 보세요. 고객마다 더미를 하나씩 추가하면 열이 100만 개가 되는데, 아마 좋은 생각은 아닐 겁니다. 대신 선형회귀를 두 개의 모델로 나누는 요령을 씁니다. 앞에서도 본 내용이지만, 지금 다시 정리해 두면 좋겠습니다. 특성 집합 \(X_1\)과 또 다른 특성 집합 \(X_2\)가 있는 선형회귀 모델이 있다고 해 봅시다.
여기서 \(X_1\)과 \(X_2\)는 특성 행렬(특성마다 행 하나, 관측값마다 열 하나)이고 \(\hat{\beta_1}\)과 \(\hat{\beta_2}\)는 행 벡터입니다. 다음 절차를 따르면 정확히 같은 \(\hat{\beta_1}\) 매개변수를 얻을 수 있습니다.
결과 \(y\)를 두 번째 특성 집합에 회귀합니다. \(\hat{y^*} = \hat{\gamma_1} X_2\)
첫 번째 특성 집합을 두 번째 특성 집합에 회귀합니다. \(\hat{X_1} = \hat{\gamma_2} X_2\)
이 마지막 회귀의 매개변수는 모든 특성을 넣고 회귀했을 때와 정확히 같습니다. 그런데 이것이 어떻게 도움이 될까요? 대상 더미가 들어간 모델의 추정을 두 단계로 나눌 수 있습니다. 먼저 더미를 사용해 결과와 특성을 예측합니다. 위의 1, 2단계에 해당합니다.
이제 더미변수에 회귀하는 것은 그 더미의 평균을 추정하는 것만큼 간단하다는 점을 떠올려 보세요. 기억나지 않는다면 데이터로 직접 확인해 보겠습니다. 연도 더미의 함수로 임금을 예측하는 모델을 실행해 봅시다.
코드
mod = smf.ols("lwage ~ C(year)", data=data).fit()mod.summary().tables[1]
coef
std err
t
P>|t|
[0.025
0.975]
Intercept
1.3935
0.022
63.462
0.000
1.350
1.437
C(year)[T.1981]
0.1194
0.031
3.845
0.000
0.059
0.180
C(year)[T.1982]
0.1782
0.031
5.738
0.000
0.117
0.239
C(year)[T.1983]
0.2258
0.031
7.271
0.000
0.165
0.287
C(year)[T.1984]
0.2968
0.031
9.558
0.000
0.236
0.358
C(year)[T.1985]
0.3459
0.031
11.140
0.000
0.285
0.407
C(year)[T.1986]
0.4062
0.031
13.082
0.000
0.345
0.467
C(year)[T.1987]
0.4730
0.031
15.232
0.000
0.412
0.534
이 모델은 1980년의 평균 소득을 1.3935로, 1981년의 평균 소득을 1.5129(1.3935+0.1194)로 예측하는 식입니다. 이제 연도별 평균을 직접 계산해 보면 정확히 같은 결과가 나옵니다(기준 연도인 1980년이 절편이라는 점을 기억하세요. 그래서 각 연도의 lwage 평균을 구하려면 다른 연도의 매개변수에 절편을 더해야 합니다).
이렇게 시간에 따라 일정한 관측되지 않은 변수는 모두 사라집니다. 사실 사라지는 것은 관측되지 않은 변수만이 아닙니다. 시간에 따라 일정한 변수는 모두 사라집니다. 그래서 시간에 따라 일정한 변수는 모델에 넣을 수 없습니다. 그런 변수는 더미변수들의 선형결합이 되어 모델이 돌아가지 않기 때문입니다.
어떤 변수가 그런지 확인하려면 데이터를 개인별로 묶어 표준편차를 구한 뒤 모두 더해 보면 됩니다. 합이 0이면 그 변수는 어떤 개인에게서도 시간에 따라 변하지 않는다는 뜻입니다.
코드
data.groupby("nr").std().sum()
year            1334.971910
black              0.000000
exper           1334.971910
hisp               0.000000
hours         203098.215649
married          140.372801
educ               0.000000
union            106.512445
lwage            173.929670
expersq        17608.242825
occupation       739.222281
dtype: float64
이 데이터에서는 개인마다 일정한 인종 더미 black과 hisp를 빼야 합니다. 교육 변수도 빼야 합니다. 직업 변수도 쓰지 않겠습니다. 직업은 결혼이 임금에 미치는 효과를 매개할 가능성이 높기 때문입니다(미혼 남성이 시간을 더 많이 쏟아야 하는 자리를 맡을 수 있을지도 모릅니다). 사용할 특성을 골랐으니 이제 모델을 추정할 차례입니다.
고정효과모델을 실행하기 위해 먼저 평균 데이터를 구하겠습니다. 모든 변수를 개인별로 묶어 평균을 내면 됩니다.
코드
Y ="lwage"T ="married"X = [T, "expersq", "union", "hours"]mean_data = data.groupby("nr")[X+[Y]].mean()mean_data.head()
married
expersq
union
hours
lwage
nr
13
0.000
25.5
0.125
2807.625
1.255652
17
0.000
61.5
0.000
2504.125
1.637786
18
1.000
61.5
0.000
2350.500
2.034387
45
0.125
35.5
0.250
2225.875
1.773664
110
0.500
77.5
0.125
2108.000
2.055129
평균을 제거하려면 원래 데이터의 인덱스를 개인 식별자인 nr로 지정해야 합니다. 그다음에는 원래 데이터프레임에서 평균 데이터프레임을 빼기만 하면 됩니다.
코드
demeaned_data = (data .set_index("nr") # set the index as the person indicator [X+[Y]]- mean_data) # subtract the mean datademeaned_data.head()
married
expersq
union
hours
lwage
nr
13
0.0
-24.5
-0.125
-135.625
-0.058112
13
0.0
-21.5
0.875
-487.625
0.597408
13
0.0
-16.5
-0.125
132.375
0.088810
13
0.0
-9.5
-0.125
152.375
0.177561
13
0.0
-0.5
-0.125
263.375
0.312473
마지막으로 시간 평균을 제거한 데이터로 고정효과모델을 실행합니다.
코드
mod = smf.ols(f"{Y} ~ {'+'.join(X)}", data=demeaned_data).fit()mod.summary().tables[1]
coef
std err
t
P>|t|
[0.025
0.975]
Intercept
-6.679e-17
0.005
-1.32e-14
1.000
-0.010
0.010
married
0.1147
0.017
6.756
0.000
0.081
0.148
expersq
0.0040
0.000
21.958
0.000
0.004
0.004
union
0.0784
0.018
4.261
0.000
0.042
0.115
hours
-8.46e-05
1.25e-05
-6.744
0.000
-0.000
-6e-05
고정효과가 누락 변수 편향(omitted variable bias)을 모두 없앤다고 믿는다면, 이 모델은 결혼이 남성의 임금을 11% 올린다고 말해 줍니다. 이 결과는 통계적으로 매우 유의합니다. 한 가지 짚고 넘어갈 점은 고정효과모델에서는 표준오차를 군집화(cluster)해야 한다는 것입니다. 그러니 모든 추정을 손으로 하는 대신(이건 교육 목적으로나 좋습니다) linearmodels 라이브러리를 사용하고 cluster_entity 인자를 True로 지정하면 됩니다.
매개변수 추정값이 시간 평균을 제거한 데이터로 얻은 값과 똑같다는 점에 주목하세요. 유일한 차이는 표준오차가 조금 더 크다는 것입니다. 이제 데이터의 시간 구조를 고려하지 않는 단순한 최소제곱법(OLS) 모델과 비교해 보겠습니다. 이 모델에는 시간에 따라 일정한 변수를 다시 넣습니다.
코드
mod = smf.ols("lwage ~ expersq+union+married+hours+black+hisp+educ", data=data).fit()mod.summary().tables[1]
coef
std err
t
P>|t|
[0.025
0.975]
Intercept
0.2654
0.065
4.103
0.000
0.139
0.392
expersq
0.0032
0.000
15.750
0.000
0.003
0.004
union
0.1829
0.017
10.598
0.000
0.149
0.217
married
0.1410
0.016
8.931
0.000
0.110
0.172
hours
-5.32e-05
1.34e-05
-3.978
0.000
-7.94e-05
-2.7e-05
black
-0.1347
0.024
-5.679
0.000
-0.181
-0.088
hisp
0.0132
0.021
0.632
0.528
-0.028
0.054
educ
0.1057
0.005
22.550
0.000
0.097
0.115
이 모델은 결혼이 남성의 임금을 14% 올린다고 말합니다. 고정효과모델로 찾은 효과보다 다소 큽니다. 이는 지능이나 외모처럼 개인마다 고정된 요인을 모델에 넣지 못해서 누락 변수 편향이 생겼음을 시사합니다.
고정효과 시각화하기
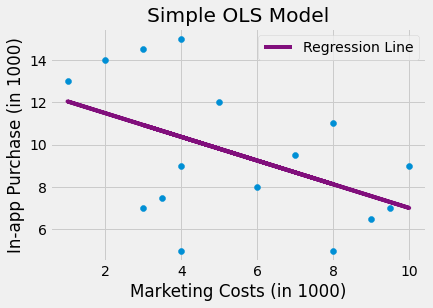
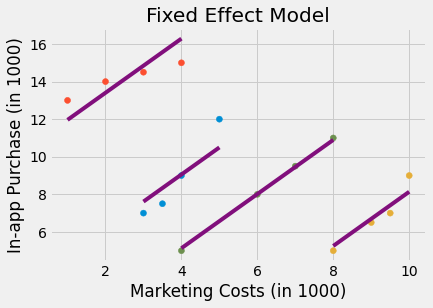
고정효과모델이 어떻게 작동하는지 직관을 넓히기 위해 잠시 다른 예제로 넘어가 보겠습니다. 대형 테크 기업에서 일하면서 광고판 마케팅 캠페인이 인앱 구매에 미치는 효과를 추정하려 한다고 해 봅시다. 과거 데이터를 보니 마케팅 부서는 구매 수준이 낮은 도시일수록 광고판 설치에 돈을 더 많이 쓰는 경향이 있습니다. 말이 되죠? 매출이 치솟고 있다면 굳이 광고를 많이 할 필요가 없을 테니 말입니다. 이 데이터로 회귀 모델을 돌리면 마케팅 비용이 클수록 인앱 구매가 줄어드는 것처럼 보입니다. 하지만 이는 마케팅 투자가 소비가 적은 지역에 쏠려 있기 때문일 뿐입니다.
인과추론을 잘 아는 여러분은 도시를 나타내는 더미변수를 넣은 고정효과모델을 돌려 보기로 합니다. 고정효과모델은 시간에 따라 변하지 않는 도시별 특성을 통제하므로, 어떤 도시가 제품을 잘 받아들이지 않는 곳이라면 그 특성을 잡아냅니다. 이 모델을 돌리면 마침내 마케팅 비용이 많을수록 인앱 구매도 많아진다는 것을 볼 수 있습니다.
코드
fe = smf.ols("purchase ~ mkt_costs + C(city)", data=toy_panel).fit()fe_toy = toy_panel.assign(y_hat = fe.fittedvalues)plt.scatter(toy_panel.mkt_costs, toy_panel.purchase, c=toy_panel.city)for city in fe_toy["city"].unique(): plot_df = fe_toy.query(f"city=='{city}'") plt.plot(plot_df.mkt_costs, plot_df.y_hat, c="C5")plt.title("Fixed Effect Model")plt.xlabel("Marketing Costs (in 1000)")plt.ylabel("In-app Purchase (in 1000)");
위 그림이 고정효과가 하는 일을 어떻게 보여 주는지 잠시 음미해 보세요. 고정효과가 도시마다 회귀선을 하나씩 적합하고, 그 선들이 서로 평행하다는 점에 주목하세요. 선의 기울기는 마케팅 비용이 인앱 구매에 미치는 효과입니다. 즉, 고정효과는 인과효과가 모든 대상에서 일정하다고 가정합니다. 여기서 대상은 도시입니다. 이 가정은 보기에 따라 약점이 될 수도 있고 장점이 될 수도 있습니다. 도시별 인과효과를 알고 싶다면 약점입니다. 고정효과모델은 효과가 대상마다 같다고 가정하므로 인과효과의 차이를 전혀 찾을 수 없습니다. 하지만 마케팅이 인앱 구매에 미치는 전반적인 효과를 알고 싶다면, 데이터의 패널 구조는 고정효과가 활용할 수 있는 아주 유용한 지렛대가 됩니다.
시간 효과
개인 수준에서 고정효과를 만든 것처럼 시간 수준의 고정효과도 만들 수 있습니다. 개인마다 더미를 추가하면 개인별로 고정된 특성이 통제되듯이, 시간 더미를 추가하면 각 기간 안에서는 고정되어 있지만 시간에 따라 바뀔 수 있는 변수가 통제됩니다. 이런 변수의 예로 인플레이션이 있습니다. 물가와 임금은 시간이 지나면서 오르는 경향이 있지만, 각 기간의 인플레이션은 모든 대상에 똑같이 적용됩니다. 좀 더 구체적인 예로, 결혼이 시간이 지나며 늘어나고 있다고 해 봅시다. 임금과 결혼 비율이 모두 시간에 따라 변한다면 시간이 교란 요인이 됩니다. 인플레이션 때문에 임금도 시간이 지나면서 오르므로, 결혼과 임금 사이에 보이는 양의 연관관계 중 일부는 단순히 둘 다 시간에 따라 늘어나기 때문일 수 있습니다. 이를 보정하려면 기간마다 더미변수를 추가하면 됩니다. linear models에서는 수식에 TimeEffects를 추가하고 cluster_time을 true로 지정하기만 하면 됩니다.
이 새 모델에서는 결혼이 임금에 미치는 효과가 0.1147에서 0.0476으로 크게 줄었습니다. 그래도 이 결과는 99% 수준에서 유의하므로, 남성은 여전히 결혼으로 소득이 늘어나리라 기대할 수 있습니다.
패널데이터가 도움이 되지 않을 때
패널데이터와 고정효과모델은 인과추론을 위한 매우 강력한 도구입니다. 무작위 배정된 데이터도, 좋은 도구변수도 없을 때 비실험 데이터로 인과추론을 한다면 고정효과만큼 설득력 있는 방법은 찾기 어렵습니다. 그래도 만병통치약은 아니라는 점은 짚어 둘 만합니다. 패널데이터로도 해결할 수 없는 상황이 있습니다.
가장 분명한 경우는 시간에 따라 변하는 교란 요인이 있을 때입니다. 고정효과는 개인마다 일정한 속성에서 생기는 편향만 없앨 수 있습니다. 예를 들어 책을 읽고 좋은 지방을 많이 먹으면 지능을 높일 수 있다고 해 봅시다. 그렇게 높아진 지능 덕분에 보수가 더 좋은 직업도 얻고 아내도 얻게 됩니다. 이 예에서는 지능이 시간에 따라 변하므로, 고정효과는 측정되지 않은 지능이라는 교란 요인 때문에 생기는 편향을 없앨 수 없습니다.
고정효과가 실패하는 덜 분명한 경우는 역인과관계가 있을 때입니다. 예를 들어 돈을 더 많이 벌게 만드는 것이 결혼이 아니라고 해 봅시다. 오히려 돈을 더 많이 벌어서 결혼할 가능성이 높아지는 것입니다. 이 경우 둘 사이에 양의 상관관계가 있는 것처럼 보이지만, 소득이 먼저 옵니다. 두 변수는 시간에 따라 같은 방향으로 변하므로 고정효과로는 이를 통제할 수 없습니다.
핵심 요약
이 장에서는 같은 개인을 여러 기간에 걸쳐 여러 번 측정한 데이터, 즉 패널데이터를 사용하는 방법을 살펴봤습니다. 이런 데이터가 있으면 대상을 통제하는 고정효과모델을 쓸 수 있습니다. 이 모델은 시간에 따라 변하지 않는 개인의 속성을 모두 고정합니다. 교란을 통제하는 강력하고 매우 설득력 있는 방법이며, 무작위 배정이 아닌 데이터로 할 수 있는 최선에 가깝습니다.
마지막으로 고정효과가 만병통치약은 아니라는 점도 살펴봤습니다. 고정효과가 통하지 않는 두 가지 상황을 봤는데, 역인과관계가 있을 때와 측정되지 않은 교란 요인이 시간에 따라 변할 때입니다.
참고 자료
저는 이 책 전체를 Joshua Angrist, Alberto Abadie, Christopher Walters의 훌륭한 계량경제학 강의에 바치는 헌사라고 생각합니다. 이 책에 담긴 아이디어 대부분은 이들이 미국경제학회(American Economic Association)에서 한 강의에서 가져왔습니다. 힘든 2020년을 버틸 수 있는 것도 이 강의들을 보는 덕분입니다. * Cross-Section Econometrics * Mastering Mostly Harmless Econometrics
Angrist의 멋진 책들도 참고 자료로 소개하고 싶습니다. 이 책들 덕분에 계량경제학, 이들 표현으로는 ’Metrics가 아주 유용할 뿐 아니라 무척 재미있다는 것을 알게 되었습니다.
Causal Inference for the Brave and True는 과학의 통계학이라 할 수 있는 인과추론을 다루는 오픈소스 자료입니다. 파이썬 기반의 무료 소프트웨어만 사용하며, 돈이 없어도, 배경지식이 많지 않아도 누구나 볼 수 있는 자료를 목표로 합니다. 이 책이 도움이 되었고 후원하고 싶다면 Patreon을 방문해 주세요. 금전적으로 기여하기 어렵다면 오타를 고치거나, 수정할 부분을 제안하거나, 이해하기 어려웠던 부분에 의견을 주는 것으로도 도울 수 있습니다. 책의 저장소에서 이슈를 열어 주세요. 마지막으로 이 내용이 마음에 들었다면 도움이 될 만한 사람들과 공유하고 GitHub에서 스타를 눌러 주세요.
의견 나누기
번역이 어색한 곳, 더 쉬운 설명, 궁금한 점을 남겨 주세요. GitHub 계정으로 로그인하면 댓글을 달 수 있고, 남긴 의견은 GitHub Discussions에 장별로 모입니다.