지금까지 선형회귀와 성향점수 가중치(propensity score weighting)로 \(E[Y|T=1] - E[Y|T=0] | X\)를 추정하는 방법을 배웠습니다. 그렇다면 둘 중 무엇을, 언제 써야 할까요? 확신이 없다면 둘 다 쓰면 됩니다! 이중 강건 추정(doubly robust estimation)은 성향점수와 선형회귀를 결합해서 어느 한쪽에만 의존하지 않아도 되게 해 주는 방법입니다.
어떻게 작동하는지 보기 위해 마인드셋 실험을 살펴보겠습니다. 이 실험은 미국 공립 고등학교에서 진행한 무작위 연구로, 성장 마인드셋(growth mindset)의 효과를 알아내는 것이 목적입니다. 방식은 이렇습니다. 학생들은 학교에서 성장 마인드셋을 심어 주는 세미나를 듣습니다. 그런 다음 연구진은 이 학생들이 대학에 진학한 뒤 학업 성과가 어땠는지 추적해 측정합니다. 측정 결과는 성취도 점수로 집계해 표준화했습니다. 학생들의 개인정보를 보호하기 위해 이 연구의 실제 데이터는 공개되어 있지 않습니다. 대신 Athey와 Wager가 실제 데이터와 통계적 특성이 같은 시뮬레이션 데이터셋을 제공했으므로, 여기서는 그 데이터를 사용하겠습니다.
코드
import warningswarnings.filterwarnings('ignore')import pandas as pdimport numpy as npfrom matplotlib import stylefrom matplotlib import pyplot as pltimport seaborn as snsfrom sklearn.linear_model import LogisticRegression, LinearRegression%matplotlib inlinestyle.use("fivethirtyeight")pd.set_option("display.max_columns", 6)
코드
data = pd.read_csv("./data/learning_mindset.csv")data.sample(5, random_state=5)
schoolid
intervention
achievement_score
...
school_ethnic_minority
school_poverty
school_size
259
73
1
1.480828
...
-0.515202
-0.169849
0.173954
3435
76
0
-0.987277
...
-1.310927
0.224077
-0.426757
9963
4
0
-0.152340
...
0.875012
-0.724801
0.761781
4488
67
0
0.358336
...
0.315755
0.054586
1.862187
2637
16
1
1.360920
...
-0.033161
-0.982274
1.591641
5 rows × 13 columns
무작위 연구이긴 했지만 이 데이터에 교란(confounding)이 없어 보이지는 않습니다. 한 가지 가능한 이유는 처치변수를 학생이 세미나를 실제로 들었는지로 측정했다는 점입니다. 참여할 기회는 무작위로 주어졌지만 실제 참여는 무작위가 아닙니다. 즉, 여기서는 불응(non-compliance) 사례를 다루고 있습니다. 학생의 성공 기대가 세미나 참여와 상관관계가 있다는 점이 그 증거 중 하나입니다. 스스로 보고한 성공 기대가 높은 학생일수록 성장 마인드셋 세미나에 참여했을 가능성이 높습니다.
여기서 \(\hat{P}(x)\)는 성향점수의 추정값(예를 들어 로지스틱 회귀로 구한 값), \(\hat{\mu_1}(x)\)은 \(E[Y|X, T=1]\)의 추정값(예를 들어 선형회귀로 구한 값), \(\hat{\mu_0}(x)\)은 \(E[Y|X, T=0]\)의 추정값입니다. 짐작했겠지만 이중 강건 추정량의 앞부분은 \(E[Y_1]\)을, 뒷부분은 \(E[Y_0]\)을 추정합니다. 앞부분을 자세히 살펴보겠습니다. 같은 직관을 뒷부분에도 그대로 적용할 수 있습니다.
처음 보면 이 식이 무섭게 느껴진다는 걸 압니다(걱정 마세요, 알고 보면 아주 단순합니다). 그래서 먼저 이 추정량을 코드로 어떻게 구현하는지 보여 드리겠습니다. 수식보다 코드를 덜 무서워하는 사람도 있을 것 같아서요. 이 추정량이 실제로 어떻게 작동하는지 볼까요?
이중 강건 추정량을 맛보았으니, 이제 이 추정량이 왜 그렇게 훌륭한지 살펴보겠습니다. 우선 이중 강건이라는 이름은 \(\hat{P}(x)\)와 \(\hat{\mu}(x)\) 두 모델 중 하나만 올바르게 지정하면 된다는 데서 왔습니다. 이를 확인하기 위해 \(E[Y_1]\)을 추정하는 앞부분을 찬찬히 들여다보겠습니다.
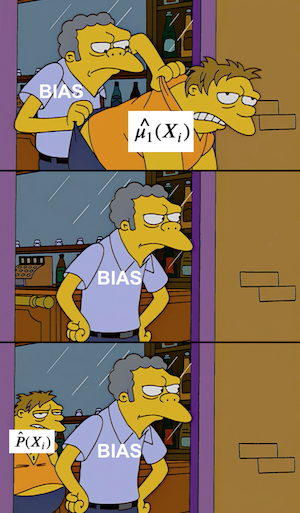
\(\hat{\mu_1}(x)\)이 정확하다고 가정해 봅시다. 그러면 성향점수 모델이 틀렸더라도 걱정할 필요가 없습니다. \(\hat{\mu_1}(x)\)이 정확하면 \(E[T_i(Y_i - \hat{\mu_1}(X_i))]=0\)이기 때문입니다. \(T_i\)를 곱하면 실험군만 남는데, 실험군에서 \(\hat{\mu_1}\)의 잔차는 정의상 평균이 0입니다. 그러면 식 전체가 \(\hat{\mu_1}(X_i)\)로 줄어들고, 가정에 따라 이 값은 \(E[Y_1]\)을 정확하게 추정합니다. 즉, \(\hat{\mu_1}(X_i)\)이 정확하기만 하면 성향점수 모델이 어떻든 상관없어집니다. \(E[Y_0]\)의 추정량도 같은 논리로 이해할 수 있습니다.
하지만 제 말만 믿지 마세요. 코드로 직접 확인해 봅시다! 다음 추정량에서는 성향점수를 추정하는 로지스틱 회귀를 0.1에서 0.9 사이의 균등분포 난수로 바꿨습니다(가중치가 너무 작아져서 성향점수의 분산이 폭발하는 건 원치 않으니까요). 무작위로 뽑은 값이니 좋은 성향점수 모델일 리가 없습니다. 그런데도 이중 강건 추정량은 로지스틱 회귀로 성향점수를 추정했을 때와 아주 가까운 추정값을 내놓습니다.
이제 성향점수 \(\hat{P}(X_i)\)를 올바르게 지정했다고 가정해 봅시다. 이 경우 \(E[T_i - \hat{P}(X_i)]=0\)이므로 \(\hat{\mu_1}(X_i)\)에 의존하는 부분이 사라집니다. 그러면 이중 강건 추정량은 성향점수 가중치 추정량 \(\frac{T_iY_i}{\hat{P}(X_i)}\)로 줄어들고, 가정에 따라 이 추정량은 정확합니다. 따라서 성향점수만 올바르게 지정했다면 \(\hat{\mu_1}(X_i)\)이 틀리더라도 추정량은 여전히 정확합니다.
이번에도 수식보다 코드를 더 믿는 분들을 위해 실제로 확인해 보겠습니다. 아래 코드에서는 두 회귀 모델을 모두 정규분포 난수로 바꿨습니다. \(\hat{\mu}(X_i)\)를 올바르게 지정하지 않았다는 점에는 의심의 여지가 없습니다. 그래도 이중 강건 추정은 앞서 본 약 0.38이라는 \(\hat{ATE}\)를 그대로 되찾아 냅니다.
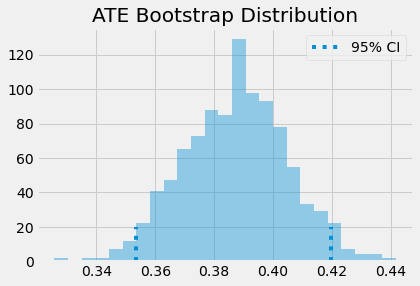
print(f"Original ATE 95% CI:", (np.percentile(ates, 2.5), np.percentile(ates, 97.5)))print(f"Wrong Mu ATE 95% CI:", (np.percentile(wrong_mux, 2.5), np.percentile(wrong_mux, 97.5)))
Original ATE 95% CI: (0.35364752721776144, 0.41978441342477585)
Wrong Mu ATE 95% CI: (0.33863822614929406, 0.433173164584189)
다시 한번, 조건부 평균 모델만 엉망으로 만들었을 때도 ATE는 조금 달라질 뿐입니다. 이 정도면 이중 강건 추정의 위력이 충분히 와닿았기를 바랍니다. 이런 마법이 일어나는 이유는 인과추론에서 인과 추정값의 편향을 없애는 방법이 두 가지이기 때문입니다. 처치 메커니즘을 모델링하거나 결과 메커니즘을 모델링하는 것입니다. 둘 중 하나만 맞으면 됩니다.
다만 한 가지 주의할 점이 있습니다. 실무에서는 둘 중 어느 쪽도 정확하게 모델링하기가 매우 어렵습니다. 실제로는 성향점수 모델도 결과 모델도 100% 맞지 않는 경우가 더 흔합니다. 둘 다 틀리는데, 틀리는 방식이 서로 다릅니다. 이럴 때는 단일 모델을 쓰는 편이 나은지 이중 강건 추정을 쓰는 편이 나은지 아직 명확하게 결론 나지 않았습니다 [1][2][3]. 저는 그래도 이중 강건 추정을 즐겨 씁니다. 적어도 맞힐 기회가 두 번은 생기기 때문입니다.
힌트옮긴이
이 추정량은 역확률 가중치(IPW) 추정량에 결과 모델로 만든 보정 항을 덧붙인 형태라서 Augmented IPW(AIPW)라고도 부릅니다.
핵심 요약
이 장에서는 선형회귀와 성향점수를 결합해 이중 강건 추정량을 만드는 간단한 방법을 살펴봤습니다. 이 추정량은 두 모델 중 하나만 맞으면 되기 때문에 이런 이름이 붙었습니다. 성향점수 모델이 맞으면 결과 모델이 틀려도 인과효과를 식별할 수 있습니다. 반대로 결과 모델이 맞으면 성향점수 모델이 틀려도 인과효과를 식별할 수 있습니다.
참고 자료
저는 이 책 전체를 Joshua Angrist, Alberto Abadie, Christopher Walters의 훌륭한 계량경제학 강의에 바치는 헌사라고 생각합니다. 이 책에 담긴 아이디어 대부분은 이들이 미국경제학회(American Economic Association)에서 한 강의에서 가져왔습니다. 힘든 2020년을 버틸 수 있는 것도 이 강의들을 보는 덕분입니다. * Cross-Section Econometrics * Mastering Mostly Harmless Econometrics
Angrist의 멋진 책들도 참고 자료로 소개하고 싶습니다. 이 책들 덕분에 계량경제학, 이들 표현으로는 ’Metrics가 아주 유용할 뿐 아니라 무척 재미있다는 것을 알게 되었습니다.
Causal Inference for the Brave and True는 과학의 통계학이라 할 수 있는 인과추론을 다루는 오픈소스 자료입니다. 파이썬 기반의 무료 소프트웨어만 사용하며, 돈이 없어도, 배경지식이 많지 않아도 누구나 볼 수 있는 자료를 목표로 합니다. 이 책이 도움이 되었고 후원하고 싶다면 Patreon을 방문해 주세요. 금전적으로 기여하기 어렵다면 오타를 고치거나, 수정할 부분을 제안하거나, 이해하기 어려웠던 부분에 의견을 주는 것으로도 도울 수 있습니다. 책의 저장소에서 이슈를 열어 주세요. 마지막으로 이 내용이 마음에 들었다면 도움이 될 만한 사람들과 공유하고 GitHub에서 스타를 눌러 주세요.
의견 나누기
번역이 어색한 곳, 더 쉬운 설명, 궁금한 점을 남겨 주세요. GitHub 계정으로 로그인하면 댓글을 달 수 있고, 남긴 의견은 GitHub Discussions에 장별로 모입니다.