앞 장에서는 도구변수(instrumental variable)를 좀 더 전통적인 관점에서 살펴보았습니다. 그 관점에서 도구변수는 활용할 수 있는 일종의 자연 실험이었습니다. 반면 현대의 도구변수 분석은 의학에서 많은 통찰을 얻습니다. 도구변수에 어떻게 반응하는지에 따라 세상 사람들을 네 부류로 나눕니다.
순응자(Compliers)
항시 불참자(Never Takers)
항시 참여자(Always Takers)
반항자(Defiers)
이 명칭은 약학에서 왔습니다. 어떤 질병에 신약이 효과가 있는지 확인하는 실험을 한다고 해 봅시다. 피험자는 각각 신약이나 위약 중 한 가지 처치에 배정됩니다. 순응자는 배정받은 대로 따르는 피험자입니다. 위약을 받으면 위약을 먹고, 신약을 받으면 신약을 먹습니다. 항시 불참자는 약 먹기를 거부하는 피험자입니다. 신약에 배정되더라도 먹지 않습니다. 반대로 항시 참여자는 위약에 배정되더라도 어떻게든 신약을 구해 먹는 사람들입니다. 마지막으로 반항자는 대조군에 배정되면 처치를 받고, 처치에 배정되면 대조 조건을 택하는 사람들입니다. 시키는 것과 반대로만 하는 얄미운 청개구리 같은 아이를 떠올리면 됩니다. 실제로는 그리 흔하지 않아서(아이들 말고 반항자가 말입니다) 보통은 무시하고 넘어갑니다.
현대의 도구변수 분석은 도구를 순응이 완벽하지 않은 준실험 설계로 다룹니다. 그렇게 해서 내적으로 타당한 인과효과와 외적으로 타당한 인과효과를 구분합니다. 다시 짚어 보면, 내적으로 타당한 효과는 식별할 수 있는 효과입니다. 그 특정한 상황, 그 특정한 데이터 안에서 타당합니다. 도구변수 분석에서는 도구 때문에 처치가 바뀌는 사람들의 처치효과가 여기에 해당합니다. 반면 외적 타당성은 그 인과효과의 예측력과 관련이 있습니다. 이 표본에서 찾은 효과를 다른 모집단에도 일반화할 수 있느냐는 질문입니다. 예를 들어, 기부할 유인을 주었을 때 사람들이 너그럽게 행동하는지 알아보려고 여러분의 대학교에서 무작위 통제 실험(RCT)을 했다고 해 봅시다. 실험은 잘 설계했지만 참가자로 경제학과 학생들만 불렀습니다. 그랬더니 모두 이기적인 얌체라는 결과가 나왔습니다. 내적으로는 타당한 결론입니다. 이 데이터 포인트들만 놓고 보면 맞는 말입니다. 하지만 이 실험만으로 인류가 이기적이라고 추론할 수 있을까요? 그렇다고 보기는 어렵습니다. 그래서 이 실험에 그 결과를 일반화할 만한 외적 타당성이 있는지 의문을 품게 됩니다. 아무튼 다시 도구변수로 돌아가겠습니다.
좀 더 구체적으로, 인앱 구매로 측정하는 사용자 참여를 높이고 싶은 상황을 생각해 봅시다. 한 가지 방법은 마케팅 부서에 사용자 참여를 끌어올릴 푸시 알림을 만들어 달라고 요청하는 것입니다. 마케팅 부서는 멋진 디자인과 아주 화려한 사용자 인터랙션을 갖춘 푸시를 만들어 옵니다. 이 푸시를 가지고 무작위 실험을 설계합니다. 고객 10000명을 무작위로 뽑고, 각 고객에게 50% 확률로 푸시를 배정합니다. 그런데 테스트를 실행해 보니, 푸시를 받도록 배정된 고객 중 일부가 푸시를 받지 못하고 있습니다. 엔지니어에게 물어보니, 아마 그 고객들의 휴대전화가 오래되어서 마케팅팀이 디자인한 형태의 푸시를 지원하지 않기 때문일 거라고 합니다.
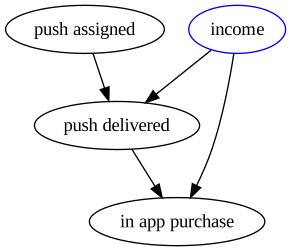
처음에는 별일 아니라고 생각할 수도 있습니다. 배정된 처치 대신 실제로 받은 처치를 처치변수로 쓰면 되지 않을까요? 알고 보면 그렇게 간단하지 않습니다. 이 상황 전체를 인과 그래프로 그리면 다음과 같습니다.
코드
import warningswarnings.filterwarnings('ignore')import pandas as pdimport numpy as npfrom scipy import statsfrom matplotlib import styleimport seaborn as snsfrom matplotlib import pyplot as pltimport statsmodels.formula.api as smffrom linearmodels.iv import IV2SLSimport graphviz as gr%matplotlib inlinestyle.use("fivethirtyeight")
코드
g = gr.Digraph()g.edge("push assigned", "push delivered")g.edge("push delivered", "in app purchase")g.edge("income", "in app purchase")g.edge("income", "push delivered")g.node("income", color="blue")g
인과 그래프 맨 위에는 푸시 배정이 있습니다. 설계상 무작위이므로 이것을 일으키는 원인은 없습니다. 그다음에는 푸시가 실제로 전달되었는지를 나타내는 노드가 있습니다. 푸시를 받도록 배정된 사람이 모두 푸시를 받은 것은 아니므로 여기에는 불응(non-compliance)이 있습니다. 더 구체적으로는 처치에 배정되어도 처치를 받지 않는 항시 불참자가 있습니다. 그리고 이 불응이 단순히 우연이 아니라고 의심할 만한 이유도 있습니다. 오래된 휴대전화를 가진 사람들이 푸시를 받지 못하므로, 소득도 푸시 전달에 영향을 준다고 볼 수 있습니다. 부유할수록 더 좋은 휴대전화를 가지고 있을 가능성이 높고, 그러면 푸시를 받을 가능성도 높아집니다. 마지막으로 결과변수인 인앱 구매가 있습니다. 소득은 알 수 없으므로 통제할 수 없다는 점을 기억하세요. 이 점을 염두에 두고, 배정된 푸시를 그대로 처치변수로 쓰면 어떻게 되는지, 그리고 대신 전달된 푸시를 처치로 쓰면 어떻게 되는지 살펴보겠습니다.
이제는 잘 알고 있듯이, 이 값은 편향 \(E[Y_0|pushAssigned=0] - E[Y_0|pushAssigned=1]\)이 0일 때만 \(E[Y_1] - E[Y_0]\)의 편향되지 않은 추정값입니다. pushAssigned는 무작위이므로 편향은 0입니다. 그럼 이걸로 해결된 걸까요? 꼭 그렇지는 않습니다. 이렇게 하면 사실 원래 묻고 싶던 것과는 다른 질문에 답하게 됩니다. 처치 자체의 효과가 아니라 처치 배정의 인과효과를 구하게 됩니다. 그렇다면 둘은 다른 것일까요, 아니면 처치 배정의 인과효과를 평균 처치효과(ATE)로 확장해서 볼 수 있을까요? 다시 말해, 처치 배정의 인과효과는 ATE의 편향되지 않은 추정값일까요?
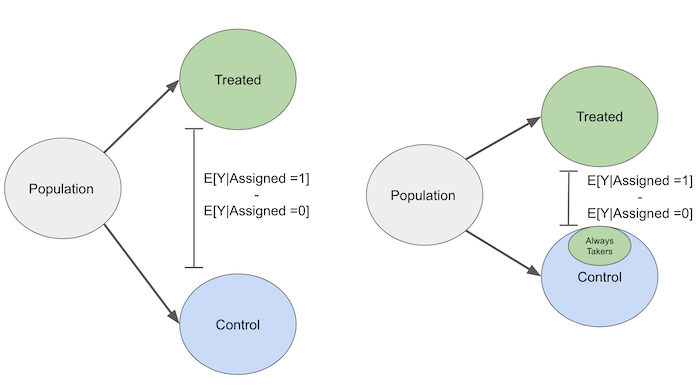
결론부터 말하면 아닙니다. 불응 때문에 처치에 배정된 사람들의 결과가 대조군에 배정된 사람들의 결과 쪽으로 끌려갑니다. 불응은 의도치 않게 처치를 뒤집어서, 실험군과 대조군의 결과를 서로 비슷하게 만듭니다. 이것을 변수가 비슷한 것과 혼동하지 마세요. 실험군과 대조군은 변수 면에서는 비슷하길 바랍니다. 그래야 둘을 비교할 수 있으니까요. 바라지 않는 것은, 실제로 처치효과가 있는데도 두 그룹의 결과가 비슷해지는 것입니다.
이를 이해하기 위해 먼저 항시 참여자가 있다고 해 봅시다. 이들 중 일부는 우연히 대조군에 배정됩니다. 하지만 대조군에 배정된 사람들도 어차피 처치를 받습니다. 그러면 이들은 사실상 대조군에 섞여 든 실험군이 됩니다. 이렇게 섞이기 때문에, 불응이 있으면 인과효과를 찾아내기가 더 어려워집니다.
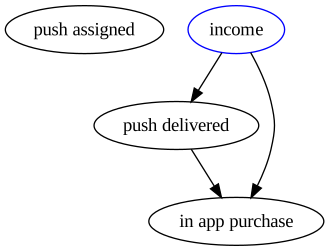
같은 논리로, 항시 불참자는 처치에 배정되어도 처치를 받지 않으므로 처치에 배정된 사람들을 처치받지 않은 사람들과 조금 닮아 보이게 만듭니다. 이런 의미에서 불응은 감지할 수 있는 효과를 줄이므로 처치 배정의 인과효과는 0 쪽으로 편향됩니다. 극단적인 경우를 상상해 보면 이를 다른 방식으로 이해할 수 있습니다. 불응이 정말 심하다고 해 봅시다. 처치 배정을 봐서는 실제로 받은 처치를 전혀 알 수 없습니다. 이 경우 실제로 받은 처치는 순전히 무작위입니다. 도구변수 용어로 말하면 1단계(first stage)가 아주 약하다는 뜻입니다. 처치 배정을 Z로 나타내면 다음과 같습니다.
\[
E[Y|Z=1] - E[Y|Z=0] = 0
\]
처치 배정에서 결과로 가는 인과적 연결이 더는 없을 것입니다. Z는 그저 아무 의미 없이 떠다니는 확률변수가 됩니다.
코드
g = gr.Digraph()g.node("push assigned")g.edge("push delivered", "in app purchase")g.edge("income", "in app purchase")g.edge("income", "push delivered")g.node("income", color="blue")g
좋습니다. 이렇게 해서 배정의 인과효과로 처치의 인과효과를 추정하는 방법은 제외했습니다. 그렇다면 실제로 받은 처치를 그대로 쓰면 어떨까요?
이번에도 이 값에 편향이 없는지, 즉 \(E[Y_0|\mathrm{push}=0] = E[Y_0|\mathrm{push}=1]\)인지 따져 봐야 합니다. 위 인과 그래프만 봐도 그렇지 않다는 것을 알 수 있습니다. 측정되지 않은 교란 요인인 소득이 도사리고 있으니, 분명 일을 망쳐 놓을 겁니다. 앞서 말했듯이 이 사례에서는 고객의 휴대전화가 오래되어서 푸시 전달이 실패합니다. 그렇다면 아마도 \(E[Y_0|\mathrm{push}=0] < E[Y_0|\mathrm{push}=1]\)일 것입니다. 돈이 적은 고객일수록 오래된 휴대전화를 가지고 있어서 \(\mathrm{push}=0\)이 되기 쉽고, 동시에 잠재적 인앱 구매액 \(Y_0\)도 낮을 것이기 때문입니다.
아쉽게도 배정된 처치로도, 실제로 받은 처치로도 ATE를 추정할 수 없습니다. 하지만 다행히 쓸 수 있는 도구가 있습니다. 바로 도구변수입니다. 여기서 배정된 처치는 처치에 대한 완벽한 도구입니다. 무작위 배정이나 다름없고, 오직 처치를 거쳐서만 인앱 구매에 영향을 줍니다.
국지적 평균 처치효과: LATE
국지적 평균 처치효과(local average treatment effect, LATE)는 인과효과를 추정할 수 있는 모집단이 누구인지 명시합니다. LATE는 도구변수를 바라보는 또 다른 관점이기도 해서, 활용할 만한 멋진 직관을 줍니다. 현대의 도구변수 분석에서는 도구가 인과 사슬을 시작한다고 봅니다. Z가 T를 일으키고, T가 Y를 일으키는 식입니다. 이 맥락에서 배제 제약(exclusion restriction)이란 Z가 T에 미치는 영향을 거치지 않고는 Y에 영향을 주지 않는다는 뜻입니다. 1단계는 이제 Z가 T에 미치는 인과효과로 봅니다. 또한 잠재적 결과를 이중 첨자 표기법으로 다시 씁니다. 첫 번째 첨자는 도구에 대한 반사실을, 두 번째 첨자는 처치에 대한 반사실을 나타냅니다.
힌트옮긴이
본문은 첫 번째 첨자가 도구, 두 번째 첨자가 처치라고 설명하지만, 아래 식에서 Y_i(1, 0)이 T_i=1, Z_i=0인 경우를 가리키듯 실제로는 첫 번째 첨자가 처치, 두 번째 첨자가 도구입니다. 가정 1, 2의 식도 이 순서를 따릅니다.
\(T_{0i}, T_{1i} \perp Z_i\) 그리고 \(Y_i(T_{1i},1), Y_i(T_{0i},0) \perp Z_i\). 독립성 가정(independence assumption)입니다. 도구가 무작위로 배정된 것이나 다름없다는 뜻입니다. 다시 말해 도구 Z는 잠재적 처치와 상관관계가 없으며, 이는 도구 값이 다른 그룹에 속한 사람들끼리 비교할 수 있다는 말과 같습니다.
\(Y_i(1, 0)=Y_i(1, 1)=Y_{i1}\) 그리고 \(Y_i(0, 0)=Y_i(0, 1)=Y_{i0}\). 배제 제약입니다. 처치를 받은 경우의 잠재적 결과를 보면, 도구 값이 어느 쪽이든 똑같다는 뜻입니다. 즉, 도구는 잠재적 결과에 영향을 주지 않고 오직 처치를 거쳐서만 결과에 영향을 줍니다.
\(E[T_{1i}-T_{0i}] \neq 0\). 1단계가 존재한다는 가정입니다. 1단계의 잠재적 결과, 즉 잠재적 처치가 서로 같지 않다는 뜻입니다. 달리 말하면 도구가 실제로 처치에 영향을 준다는 것입니다.
\(T_{i1} \geq T_{i0}\). 단조성(monotonicity) 가정입니다. 모든 사람의 도구를 켰을 때의 처치 수준이 모든 사람의 도구를 껐을 때보다 같거나 높다는 뜻입니다.
이제 왈드 추정량(Wald estimator)을 다시 살펴보면서 도구변수에 대한 직관을 더 쌓아 보겠습니다.
\[
ATE = \dfrac{E[Y|Z=1]-E[Y|Z=0]}{E[T|Z=1]-E[T|Z=0]}
\]
먼저 첫 부분인 \(E[Y|Z=1]\)부터 보겠습니다. 배제 제약을 이용하면 Y를 잠재적 결과로 다음과 같이 다시 쓸 수 있습니다.
\[
ATE = \dfrac{E[(Y_{i1}-Y_{i0})|T_{i1}>T_{i0}]P(T_{i1}>T_{i0})}{P(T_{i1}>T_{i0})}=E[(Y_{i1}-Y_{i0})|T_{i1}>T_{i0}]
\]
즉, 도구변수로 추정한 ATE는 \(T_{i1}>T_{i0}\)인 부분 모집단에서의 ATE입니다. 순응 관점에서 생각해 보면 이 모집단은 누구일까요? 도구를 켰을 때의 처치 수준이 도구를 껐을 때보다 높은 사람들입니다. 다시 말해 순응자 모집단입니다. 정리하면 다음과 같습니다.
순응자: \(T_{i1}>T_{i0}\)
항시 불참자: \(T_{i1}=T_{i0}=0\)
항시 참여자: \(T_{i1}=T_{i0}=1\)
결론적으로 도구변수는 항시 불참자, 항시 참여자, 반항자에 대한 효과는 아무것도 알려 주지 않습니다. 이들에게는 처치가 바뀌지 않기 때문입니다! 도구변수는 순응자에 대한 처치효과만 찾아냅니다.
사용자 참여에 미치는 효과
이 모든 내용이 푸시가 인앱 구매에 미치는 효과를 추정하는 사례에서 어떻게 작동하는지 보겠습니다. 인과 그래프는 위에서 그린 것과 같으니 다시 그리지 않겠습니다. 데이터에는 무작위로 배정된 도구인 푸시 배정과 처치변수인 푸시 전달 정보가 모두 있습니다.
코드
data = pd.read_csv("./data/app_engagement_push.csv")data.head()
OLS에 따르면 처치효과는 27.60헤알(BRL)입니다. 즉, 푸시가 인앱 구매를 27.6헤알 늘린다는 뜻입니다. 하지만 이 값이 편향된 추정값이라고 볼 근거가 있습니다. 오래된 휴대전화는 푸시를 잘 받지 못한다는 것을 알고 있으니, 아마 새 휴대전화를 가진 부유한 고객들이 순응자일 것입니다. 처치를 받는 사람들이 돈도 더 많으므로, 이 편향은 양의 방향이고 푸시의 실제 효과는 이보다 작을 것으로 생각합니다. 다시 말해 아마도 \(E[Y_0|T=0] < E[Y_0|T=1]\)일 것입니다.
1단계가 강해 보입니다. 푸시를 받도록 배정된 사람들은 71.8%의 확률로 푸시를 받습니다. 항시 불참자가 28% 정도 있다는 뜻입니다. 또한 절편 매개변수 추정값이 0이므로 항시 참여자는 없다고 볼 근거가 충분합니다. 배정받지 않으면 아무도 푸시를 받지 못한다는 뜻입니다. 실험 설계를 생각하면 예상할 수 있는 결과입니다.
축약형을 보면 처치 배정의 인과효과는 2.36입니다. 누군가를 푸시 수신 대상으로 배정하면 인앱 구매가 2.36헤알 늘어난다는 뜻입니다.
축약형을 1단계로 나누어 도구의 효과를 처치 단위로 환산하면 \(2.3636/0.7176=3.29\)를 얻습니다. 2단계 최소제곱법(2SLS)을 돌리면 같은 추정값을 얻을 뿐 아니라, 올바른 표준오차까지 덤으로 얻습니다.
코드
iv = IV2SLS.from_formula("in_app_purchase ~ 1 + [push_delivered ~ push_assigned]", data).fit()iv.summary.tables[1]
Parameter Estimates
Parameter
Std. Err.
T-stat
P-value
Lower CI
Upper CI
Intercept
69.292
0.3624
191.22
0.0000
68.581
70.002
push_delivered
3.2938
0.7165
4.5974
0.0000
1.8896
4.6981
2SLS 결과는 OLS 결과보다 훨씬 작습니다. 3.29 대 27.60입니다. OLS로 추정한 인과효과가 양의 방향으로 편향되어 있으니 이치에 맞습니다. LATE도 잊지 말아야 합니다. 3.29는 순응자에 대한 평균 인과효과입니다. 안타깝게도 항시 불참자에 대해서는 아무것도 말할 수 없습니다. 즉, 모집단 가운데 새 휴대전화를 가진 더 부유한 층의 효과를 추정하고 있는 셈입니다.
핵심 요약
이 장에서는 도구변수를 좀 더 현대적인 관점에서 살펴보았습니다. 도구가 처치를 일으키고 처치가 결과를 일으키는 인과 사슬로 도구변수를 볼 수 있다는 것을 배웠습니다. 이 관점에서 도구변수 추정의 ATE를 이해하기 위해 순응을 살펴보았고, 그 ATE가 순응자에 대한 LATE라는 것을 알아냈습니다.
참고 자료
저는 이 책 전체를 Joshua Angrist, Alberto Abadie, Christopher Walters의 훌륭한 계량경제학 강의에 바치는 헌사라고 생각합니다. 이 책에 담긴 아이디어 대부분은 이들이 미국경제학회(American Economic Association)에서 한 강의에서 가져왔습니다. 힘든 2020년을 버틸 수 있는 것도 이 강의들을 보는 덕분입니다. * Cross-Section Econometrics * Mastering Mostly Harmless Econometrics
Angrist의 멋진 책들도 참고 자료로 소개하고 싶습니다. 이 책들 덕분에 계량경제학, 이들 표현으로는 ’Metrics가 아주 유용할 뿐 아니라 무척 재미있다는 것을 알게 되었습니다.
Causal Inference for the Brave and True는 과학의 통계학이라 할 수 있는 인과추론을 다루는 오픈소스 자료입니다. 파이썬 기반의 무료 소프트웨어만 사용하며, 돈이 없어도, 배경지식이 많지 않아도 누구나 볼 수 있는 자료를 목표로 합니다. 이 책이 도움이 되었고 후원하고 싶다면 Patreon을 방문해 주세요. 금전적으로 기여하기 어렵다면 오타를 고치거나, 수정할 부분을 제안하거나, 이해하기 어려웠던 부분에 의견을 주는 것으로도 도울 수 있습니다. 책의 저장소에서 이슈를 열어 주세요. 마지막으로 이 내용이 마음에 들었다면 도움이 될 만한 사람들과 공유하고 GitHub에서 스타를 눌러 주세요.
의견 나누기
번역이 어색한 곳, 더 쉬운 설명, 궁금한 점을 남겨 주세요. GitHub 계정으로 로그인하면 댓글을 달 수 있고, 남긴 의견은 GitHub Discussions에 장별로 모입니다.