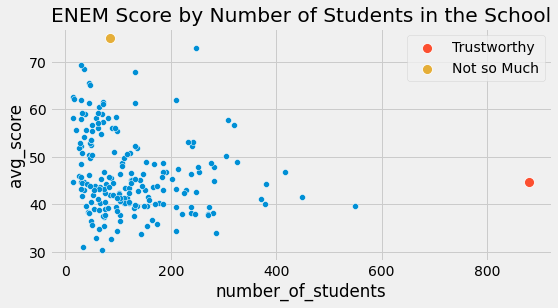
모든 데이터 포인트가 똑같은 무게를 갖지는 않습니다. ENEM 데이터셋을 다시 보면, 작은 학교의 점수보다 큰 학교의 점수를 훨씬 더 믿게 됩니다. 큰 학교가 더 낫다거나 하는 이야기가 아닙니다. 단지 규모가 크면 분산이 작기 때문입니다.
코드
import warningswarnings.filterwarnings('ignore')import pandas as pdimport numpy as npfrom scipy import statsfrom matplotlib import styleimport seaborn as snsfrom matplotlib import pyplot as pltimport statsmodels.formula.api as smfstyle.use("fivethirtyeight")
코드
np.random.seed(876)enem = pd.read_csv("./data/enem_scores.csv").sample(200)plt.figure(figsize=(8,4))sns.scatterplot(y="avg_score", x="number_of_students", data=enem)sns.scatterplot(y="avg_score", x="number_of_students", s=100, label="Trustworthy", data=enem.query(f"number_of_students=={enem.number_of_students.max()}"))sns.scatterplot(y="avg_score", x="number_of_students", s=100, label="Not so Much", data=enem.query(f"avg_score=={enem.avg_score.max()}"))plt.title("ENEM Score by Number of Students in the School");
위 데이터에서 직관적으로 생각하면, 왼쪽 점들은 오른쪽 점들보다 모델에 미치는 영향이 작아야 합니다. 사실 오른쪽 점 하나하나는 수많은 데이터 포인트를 하나로 묶어 놓은 것입니다. 이 묶음을 풀어서 그룹화하지 않은 데이터로 선형회귀를 돌릴 수 있다면, 오른쪽 점들은 왼쪽의 낱개 점 하나보다 모델 추정에 훨씬 크게 기여할 것입니다.
이처럼 분산이 낮은 영역과 높은 영역이 함께 있는 현상을 이분산성(heteroskedasticity)이라고 합니다. 쉽게 말해 이분산성은 특성 값에 따라 분산이 일정하지 않은 상태를 말합니다. 위 예에서는 특성인 표본 크기가 커질수록 분산이 줄어드는 것을 볼 수 있습니다. 다른 예를 들면, 나이에 따른 임금을 그려 보면 젊은 사람보다 나이 든 사람의 임금 분산이 더 큽니다. 하지만 분산이 달라지는 가장 흔한 이유는 단연 그룹화된 데이터입니다.
위와 같은 그룹화된 데이터는 데이터 분석에서 아주 흔합니다. 한 가지 이유는 기밀 유지입니다. 정부와 기업은 지켜야 할 개인정보 보호 규정이 있어서 개인 단위 데이터를 넘겨줄 수 없습니다. 외부 연구자에게 데이터를 내보내야 한다면 데이터를 그룹화하는 방법밖에 없습니다. 이렇게 하면 개인들이 한데 묶여서 더는 누구인지 특정할 수 없게 됩니다.
다행히 회귀분석은 이런 데이터도 꽤 잘 다룹니다. 어떻게 다루는지 이해하기 위해, 먼저 앞에서 본 임금과 교육 데이터처럼 그룹화되지 않은 데이터를 가져오겠습니다. 이 데이터는 근로자 한 명당 한 행으로 되어 있어서, 개인마다 임금과 교육 연수를 알 수 있습니다.
이제 잠시 이 데이터에 기밀 유지 제약이 걸려 있다고 해 봅시다. 데이터 제공자가 개인 단위 데이터를 줄 수 없는 상황입니다. 그래서 대신 모든 사람을 교육 연수별로 묶고, 그룹마다 평균 로그 시간당 임금과 인원수만 달라고 요청합니다. 그러면 데이터 포인트가 10개만 남습니다.
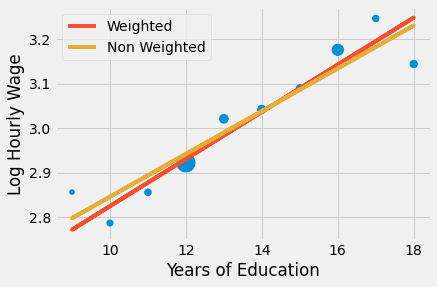
걱정하지 마세요! 회귀분석은 빅데이터가 있어야만 작동하는 게 아닙니다! 선형회귀모델에 가중치를 주면 됩니다. 이렇게 하면 모델이 작은 그룹보다 표본 크기가 큰 그룹을 더 많이 고려합니다. smf.ols를 가중 최소제곱법(weighted least squares)을 뜻하는 smf.wls로 바꾼 것을 눈여겨보세요. 알아채기 어려울 만큼 작은 차이지만, 결과는 완전히 달라집니다.
그룹화한 모델의 educ 매개변수 추정값이 그룹화하지 않은 데이터의 추정값과 아주 가깝다는 점에 주목하세요(사실 이번 경우에는 똑같습니다). 또한 데이터 포인트가 10개뿐인데도 통계적으로 유의한 계수를 얻었습니다. 점의 개수는 줄었지만 그룹화하면서 분산도 크게 줄었기 때문입니다. 표준오차가 조금 작아지고 t 통계량이 조금 커진 점도 보세요. 분산에 대한 정보 일부를 잃었으니 더 보수적으로 접근해야 하기 때문입니다. 데이터를 그룹화하고 나면 각 그룹 안의 분산이 얼마나 큰지 알 수 없습니다. 위 결과를 아래의 가중치 없는 모델 결과와 비교해 보세요.
힌트옮긴이
원문 설명과 달리, 정보를 잃어 더 보수적이어야 한다면 표준오차는 작아지는 것이 아니라 커져야 합니다. 실제 출력에서는 그룹화한 가중 회귀의 표준오차(0.006)가 그룹화하지 않은 회귀(0.007)보다 조금 작으니, 원문의 설명과 출력이 맞지 않습니다. 본문은 원문 그대로 옮겼습니다.
요점은 이렇습니다. 회귀분석은 개인 단위 데이터든 집계된 데이터든 모두 다룰 수 있는 놀라운 도구이지만, 집계된 데이터라면 가중치를 써야 합니다. 가중 회귀분석을 하려면 평균 통계량이 필요합니다. 합계도, 표준편차도, 중앙값도 아닌 평균입니다! 공변량과 종속변수 모두 평균이어야 합니다. 그룹화된 데이터에 가중 회귀분석을 한 결과가 그룹화하지 않은 데이터의 회귀분석 결과와 정확히 일치하지는 않는다는 점만 기억하세요. 그래도 꽤 비슷하게 나옵니다.
이 예에서는 앞서 넣은 교육 연수 외에 IQ를 특성으로 추가했습니다. 방법은 거의 같습니다. 그룹별 평균과 인원수를 구하고, 평균값으로 회귀하되 인원수를 가중치로 씁니다.
더미를 위한 회귀분석
더미변수(dummy variable)는 범주형 변수를 이진 열로 인코딩한 것입니다. 예를 들어 모델에 넣고 싶은 성별 변수가 있다고 합시다. 이 변수는 남성(male), 여성(female), 기타 성별(other)의 세 범주로 되어 있습니다.
gender
male
female
female
other
male
모델은 숫자만 받으므로 이 범주를 숫자로 바꿔야 합니다. 선형회귀에서는 이때 더미를 씁니다. 각 범주에 해당하는지를 0/1 열로 인코딩하는 방식입니다. 그리고 범주 하나는 기준 범주로 남겨 두고 열을 만들지 않습니다. 마지막 범주는 나머지 범주들의 선형결합이므로 이렇게 해야 합니다. 바꿔 말하면, 나머지 범주에 대한 정보를 알면 마지막 범주는 저절로 알 수 있습니다. 이 예에서 어떤 사람이 여성도 아니고 기타 성별도 아니라면 그 사람은 남성이라고 추론할 수 있습니다.
gender
female
other
male
0
0
female
1
0
female
1
0
other
0
1
male
0
0
사실 A/B 테스트를 다룰 때 이미 간단한 형태의 더미 회귀분석을 했습니다. 좀 더 일반적으로 말하면, 이진 처치를 다룰 때는 처치를 더미변수로 나타냅니다. 이 경우 더미의 회귀계수는 회귀선 절편의 증가분, 즉 실험군과 대조군의 평균 차이입니다.
좀 더 구체적으로, 12학년 졸업이 시간당 임금에 미치는 효과를 추정하는 문제를 생각해 봅시다(교란은 일단 무시하겠습니다). 아래 코드에서는 교육 연수가 12년보다 긴지를 나타내는 처치 더미변수 T를 만들었습니다.
힌트옮긴이
제목 ’Regression for Dummies’는 ’왕초보를 위한 ○○’에 해당하는 입문서 시리즈 ’For Dummies’와 더미변수를 엮은 말장난입니다.
힌트옮긴이
미국 학제에서 12학년은 고등학교 마지막 학년이므로, 12학년 졸업은 고등학교 졸업을 뜻합니다.
이 경우 12학년을 마치지 않은 사람(더미 꺼짐)의 평균 소득은 19.9입니다. 12학년을 마친 사람(더미 켜짐)의 예측값, 곧 평균 소득은 24.8449(19.9405 + 4.9044)입니다. 따라서 더미 계수는 평균의 차이를 포착하며, 이 예에서는 4.9044입니다.
좀 더 형식적으로 말하면, 처치 지표처럼 독립변수가 이진일 때 회귀분석은 평균 처치효과(ATE)를 완벽하게 포착합니다. 회귀분석은 조건부 기댓값 함수(conditional expectation function, CEF) \(E[Y|X]\)의 선형 근사인데, 이 특수한 경우에는 CEF 자체가 선형이기 때문입니다. 즉, \(E[Y_i|T_i=0]=\alpha\), \(E[Y_i|T_i=1] = \alpha + \beta\)로 정의할 수 있고, 그러면 CEF는 다음과 같습니다.
위 식은 원문 그대로이며, 각 항 앞에 기댓값 기호 E가 빠져 있습니다. 즉 β는 T=1일 때 Y의 기댓값에서 T=0일 때 Y의 기댓값을 뺀 값입니다.
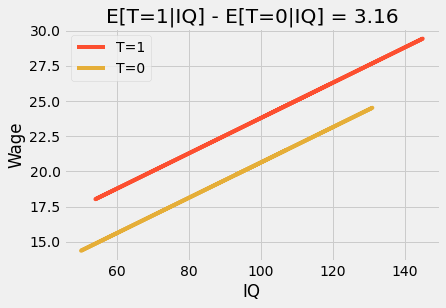
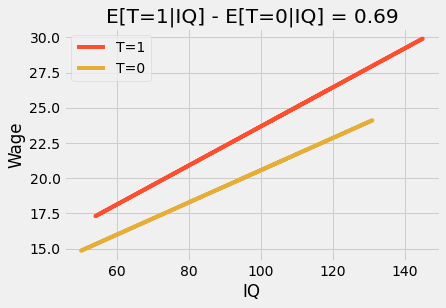
변수를 더 넣으면 더미 계수는 조건부 평균 차이가 됩니다. 예를 들어 앞의 모델에 IQ를 추가한다고 해 봅시다. 이제 더미 계수는 IQ를 고정했을 때 12학년을 졸업하면 임금이 얼마나 오를지를 알려 줍니다. 예측값을 그려 보면 평행한 직선 두 개가 보입니다. 한 직선에서 다른 직선으로 뛰어오르는 폭이 12학년을 마쳤을 때 기대할 수 있는 증가분입니다. 두 직선은 효과가 일정하다는 것도 보여 줍니다. IQ가 얼마든 12학년 졸업으로 얻는 이득은 누구에게나 같습니다.
조금 복잡해졌으니 이 모델에서 각 매개변수가 무엇을 뜻하는지 하나씩 살펴보겠습니다. 먼저 절편 \(\beta_0\)입니다. 이 녀석은 딱히 흥미로운 해석이 없습니다. 처치가 0(12학년을 졸업하지 않음)이고 IQ도 0일 때의 기대 임금입니다. IQ가 0인 사람은 없을 테니 이 매개변수는 별 의미가 없습니다. \(\beta_1\)도 사정이 비슷합니다. 이 매개변수는 IQ가 0일 때 12학년을 마치면 기대할 수 있는 임금 증가분입니다. 역시 IQ가 0일 리는 없으니 특별히 흥미로운 의미는 없습니다. 이제 \(\beta_2\)는 조금 더 흥미롭습니다. 처치받지 않은 사람에게서 IQ가 임금을 얼마나 올리는지 알려 줍니다. 이 예에서는 0.11 정도입니다. 12학년을 마치지 않은 사람은 IQ가 1점 오를 때마다 시간당 11센트를 더 벌 것으로 기대할 수 있다는 뜻입니다. 마지막으로 가장 흥미로운 매개변수는 \(\beta_3\)입니다. IQ가 12학년 졸업의 효과를 얼마나 키우는지 알려 줍니다. 이 예에서는 0.024인데, IQ가 1점 오를 때마다 12학년 졸업으로 얻는 이득이 2센트씩 늘어난다는 뜻입니다. 대단치 않아 보일 수 있지만, IQ가 60인 사람과 140인 사람을 비교해 보세요. 12학년을 졸업하면 앞사람은 임금이 1.44달러(60 * 0.024) 오르지만, IQ가 140인 사람은 3.36달러(140 * 0.024)를 더 벌게 됩니다.
간단히 모델링 용어로 말하면, 이 상호작용 항 덕분에 처치효과가 특성 수준(이 예에서는 IQ뿐)에 따라 달라질 수 있습니다. 그 결과 예측선을 그려 보면 두 직선이 더는 평행하지 않고, 12학년을 졸업한 사람들(T=1)의 직선이 IQ에 따른 기울기가 더 가파릅니다. IQ가 높은 사람일수록 졸업으로 얻는 이득이 더 크다는 뜻입니다. 이를 효과 수정(effect modification) 또는 이질적 처치효과(heterogeneous treatment effect)라고 부르기도 합니다.
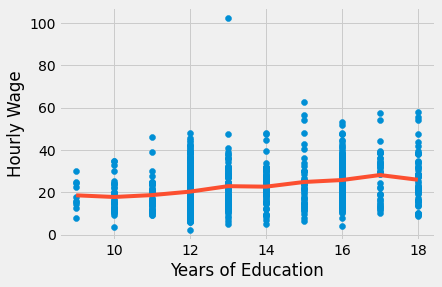
plt.scatter(wage["educ"], wage["hwage"])plt.plot(wage["educ"].sort_values(), model_dummy.predict(wage["educ"].sort_values()), c="C1")plt.xlabel("Years of Education")plt.ylabel("Hourly Wage");
먼저 이 모델은 교육이 임금에 영향을 미치는 함수 형태에 대한 가정을 모두 없앤다는 점에 주목하세요. 더는 로그를 쓸지 고민할 필요가 없습니다. 본질적으로 이 모델은 완전히 비모수적입니다. 하는 일이라고는 교육 연수별 임금의 표본평균을 구하는 것뿐입니다. 위 그래프에서도 이를 확인할 수 있는데, 적합된 선은 특정한 형태가 없습니다. 그 대신 교육 연수별 표본평균을 이은 내삽(interpolation)선입니다. 매개변수 하나를 직접 재구성해 봐도 알 수 있습니다. 예를 들어 교육 연수 17년의 매개변수는 이 모델에서 9.5905입니다. 아래에서 보듯이 이 값은 기준 교육 연수(9년)인 사람들과 교육 연수가 17년인 사람들의 차이일 뿐입니다.
\[
\beta_{17} = E[Y|T=17]-E[Y|T=9]
\]
대신 이렇게 유연성을 허용하면 통계적 유의성을 잃는다는 대가가 따릅니다. 몇몇 교육 연수에서 p 값이 얼마나 큰지 보세요.
\(w(Group_i)\)는 그룹 내 처치의 분산 \(Var(T_i|Group_i)\)와 정확히 같지는 않지만 비례합니다. 여기서 자연스럽게 떠오르는 질문이 있습니다. 그룹 가중치로 표본 크기를 쓰는 완전한 비모수 추정량을 쓰면 되지 않을까요? 그것도 타당한 추정량이지만, 회귀분석이 하는 방식은 아닙니다. 회귀분석은 처치의 분산을 가중치로 쓰기 때문에 처치가 많이 변하는 그룹에 더 큰 가중치를 둡니다. 직관적으로도 말이 됩니다. 처치가 거의 일정하다면(예를 들어 한 명만 처치받고 나머지는 모두 처치받지 않았다면) 표본 크기가 아무리 커도 소용없습니다. 처치효과를 알려 주는 정보가 별로 없기 때문입니다.
이 장은 어떤 데이터 포인트가 다른 데이터 포인트보다 더 중요하다는 이야기로 시작했습니다. 선형모델을 추정할 때는 표본 크기가 크고 분산이 작은 데이터 포인트에 더 큰 가중치를 줘야 합니다. 이어서 모델에 표본 가중치를 쓰기만 하면 선형회귀가 그룹화되고 익명화된 데이터도 우아하게 다룰 수 있다는 것을 보았습니다.
다음으로 더미 회귀분석으로 넘어갔습니다. 더미 회귀분석을 쓰면 처치가 결과에 영향을 미치는 함수 형태를 전혀 가정하지 않는 비모수 모델을 만들 수 있다는 것을 보았습니다. 그리고 더미 회귀분석에 담긴 직관을 살펴보았습니다.
참고 자료
저는 이 책 전체를 Joshua Angrist, Alberto Abadie, Christopher Walters의 훌륭한 계량경제학 강의에 바치는 헌사라고 생각합니다. 이 책에 담긴 아이디어 대부분은 이들이 미국경제학회(American Economic Association)에서 한 강의에서 가져왔습니다. 힘든 2020년을 버틸 수 있는 것도 이 강의들을 보는 덕분입니다. * Cross-Section Econometrics * Mastering Mostly Harmless Econometrics
Angrist의 멋진 책들도 참고 자료로 소개하고 싶습니다. 이 책들 덕분에 계량경제학, 이들 표현으로는 ’Metrics가 아주 유용할 뿐 아니라 무척 재미있다는 것을 알게 되었습니다.
Causal Inference for the Brave and True는 과학의 통계학이라 할 수 있는 인과추론을 다루는 오픈소스 자료입니다. 파이썬 기반의 무료 소프트웨어만 사용하며, 돈이 없어도, 배경지식이 많지 않아도 누구나 볼 수 있는 자료를 목표로 합니다. 이 책이 도움이 되었고 후원하고 싶다면 Patreon을 방문해 주세요. 금전적으로 기여하기 어렵다면 오타를 고치거나, 수정할 부분을 제안하거나, 이해하기 어려웠던 부분에 의견을 주는 것으로도 도울 수 있습니다. 책의 저장소에서 이슈를 열어 주세요. 마지막으로 이 내용이 마음에 들었다면 도움이 될 만한 사람들과 공유하고 GitHub에서 스타를 눌러 주세요.
의견 나누기
번역이 어색한 곳, 더 쉬운 설명, 궁금한 점을 남겨 주세요. GitHub 계정으로 로그인하면 댓글을 달 수 있고, 남긴 의견은 GitHub Discussions에 장별로 모입니다.