회귀 모델에 통제변수(control)를 추가하면 인과효과를 식별하는 데 도움이 된다는 것을 앞에서 살펴봤습니다. 통제변수가 교란 요인(confounder)이라면 모델에 넣는 것은 있으면 좋은 정도가 아니라 반드시 필요한 일입니다. 이 말만 듣고 섣불리 움직이는 사람은 측정할 수 있는 것이라면 무엇이든 모델에 집어넣으려 하기 쉽습니다. 빅데이터 시대인 요즘에는 그런 변수가 1000개를 훌쩍 넘기도 합니다. 그런데 알고 보면 이는 불필요할 뿐 아니라 인과효과 식별(identification)을 오히려 해칠 수 있습니다. 이제 교란 요인이 아닌 통제변수로 눈을 돌려 보겠습니다. 먼저 좋은 통제변수를 살펴본 다음, 해로운 통제변수를 자세히 알아보겠습니다.
문제를 실감 나게 이해하기 위해 예를 하나 들어 보겠습니다. 여러분이 한 핀테크 회사의 채권 추심팀에서 일하는 데이터 과학자라고 해 봅시다. 이번 과제는 연체 고객에게 채무 조정 협상을 제안하는 이메일을 보내면 어떤 효과가 있는지 알아내는 것입니다. 결과변수는 연체 고객의 상환액입니다.
이 질문에 답하기 위해 팀은 연체 고객 중 5000명을 무작위로 골라 무작위 실험을 진행합니다. 고객마다 동전을 던져 앞면이 나오면 이메일을 보내고, 뒷면이 나오면 이메일을 보내지 않고 대조군으로 남겨 둡니다. 이 실험으로 이메일 덕분에 돈이 얼마나 더 들어오는지 알아내고자 합니다.
코드
import warningswarnings.filterwarnings('ignore')import pandas as pdimport numpy as npfrom scipy import statsfrom matplotlib import styleimport seaborn as snsfrom matplotlib import pyplot as pltimport statsmodels.formula.api as smfimport graphviz as grstyle.use("fivethirtyeight")
코드
data = pd.read_csv("./data/collections_email.csv")data.head()
payments
email
opened
agreement
credit_limit
risk_score
0
740
1
1.0
0.0
2348.495260
0.666752
1
580
1
1.0
1.0
334.111969
0.207395
2
600
1
1.0
1.0
1360.660722
0.550479
3
770
0
0.0
0.0
1531.828576
0.560488
4
660
0
0.0
0.0
979.855647
0.455140
데이터가 무작위로 배정되었으므로 단순한 평균 차이로 평균 처치효과(ATE)를 추정할 수 있다는 것을 알고 있습니다. 다시 말해 무작위 배정 말고는 처치(treatment)를 일으킨 원인이 없으므로, 잠재적 결과(potential outcome)는 처치와 독립입니다. 즉, \((Y_0, Y_1)\perp T\)입니다.
안타깝게도 추정한 ATE는 -0.62로, 꽤 이상한 값이 나왔습니다. 이메일을 보냈는데 어떻게 연체 고객이 평균보다 덜 갚을 수 있을까요? 그래도 p 값이 워낙 높아서 이 결과에는 별 의미가 없을 가능성이 큽니다. 이제 어떻게 해야 할까요? 꼬리를 내리고 팀에 돌아가서, 실험으로는 결론을 내릴 수 없으니 데이터가 더 필요하다고 말해야 할까요? 아직 이릅니다.
데이터를 보면 흥미로운 열이 몇 개 더 있습니다. 예를 들어 credit_limit은 고객이 연체하기 전의 신용 한도입니다. risk_score는 이메일을 보내기 전에 추정한 고객의 위험 점수입니다. 신용 한도와 위험 점수는 상환액을 아주 잘 예측하리라고 생각할 만합니다. 그런데 이 변수들이 어떻게 도움이 될까요?
먼저 처치효과가 실제로 있는데도 통계적 유의성을 찾지 못하는 이유부터 이해해 봅시다. 이번 경우처럼 처치가 결과에 미치는 영향이 아주 작을 수 있습니다. 생각해 보면 사람들이 빚을 갚게 만드는 요인은 대부분 추심 부서가 통제할 수 없는 것들입니다. 사람들은 새 직장을 구하거나, 재정과 소득을 잘 관리하는 등의 이유로 빚을 갚습니다. 통계 용어로 말하면 상환액의 변동성은 이메일보다 다른 요인으로 훨씬 더 많이 설명된다고 할 수 있습니다.
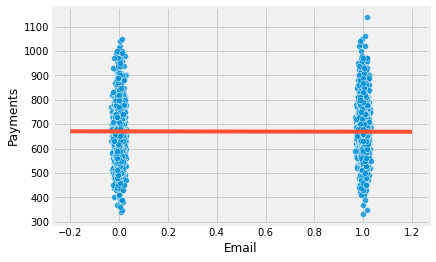
이를 눈으로 확인하려고 처치변수인 이메일을 가로축에, 상환액을 세로축에 놓고 그려 보겠습니다. 위 모델의 적합선도 빨간색으로 함께 그렸습니다. 보기 편하도록 이메일 변수에 약간의 잡음을 더해 점들이 0이나 1에 몰려 겹치지 않게 했습니다.
같은 처치 조건 안에서도 상환액이 얼마나 크게 흩어져 있는지 볼 수 있습니다. 눈으로 보기에 두 그룹 모두 400보다 조금 낮은 값부터 1000까지 퍼져 있습니다. 이메일의 효과가 5.00헤알(BRL)이나 10.00헤알 정도라면, 이렇게 큰 변동성 속에서 효과를 찾기 어려운 것도 당연합니다.
다행히 회귀분석으로 이 변동성을 줄일 수 있습니다. 비결은 통제변수를 추가하는 것입니다. 어떤 변수가 결과를 잘 예측한다면, 그 변수가 결과의 분산 중 상당 부분을 설명해 줍니다. 위험 점수와 신용 한도가 상환액을 잘 예측한다면, 이 둘을 통제해서 이메일이 상환액에 미치는 영향을 더 쉽게 찾을 수 있습니다. 회귀분석이 어떻게 작동하는지 떠올려 보면 직관적으로 이해할 수 있습니다. 회귀 모델에 변수를 추가한다는 것은 처치의 효과를 보는 동안 그 변수들을 일정하게 고정한다는 뜻입니다. 그러니 위험 점수와 신용 한도가 비슷한 수준인 고객끼리 보면 결과변수 payments의 분산이 더 작아질 것입니다. 다시 말해 위험 점수와 신용 한도가 상환액을 잘 예측한다면, 위험 점수와 신용 한도가 비슷한 고객은 상환액도 비슷할 것이므로 분산이 작아집니다.
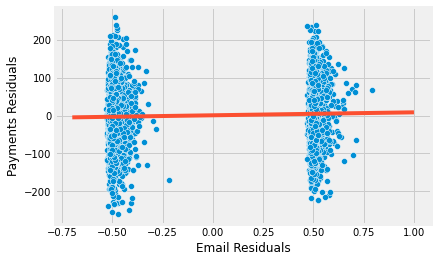
이를 확인하기 위해 회귀를 두 단계로 나누는 부분 제거(partialling out) 방법을 써 보겠습니다. 먼저 처치인 이메일과 결과인 상환액을 각각 추가 통제변수인 신용 한도와 위험 점수에 회귀합니다. 그다음, 1단계에서 얻은 두 잔차를 가지고 상환액의 잔차를 이메일의 잔차에 회귀합니다(순전히 설명을 위한 과정이며, 실무에서는 이렇게 번거롭게 할 필요가 없습니다).
힌트옮긴이
원문은 ’처치의 잔차를 상환액의 잔차에 회귀한다’고 썼지만, 아래 코드(res_payments ~ res_email)처럼 상환액의 잔차를 이메일의 잔차에 회귀하는 것이 맞으므로 그렇게 옮겼습니다.
상환액의 분산이 10807에서 5652로 줄어든 것을 확인할 수 있습니다. 위험 점수와 신용 한도를 통제했더니 분산이 거의 절반으로 줄었습니다. 반면 처치인 이메일의 변동성은 줄지 않았습니다. 위험 점수와 신용 한도로는 이메일을 예측할 수 없으니 당연한 결과입니다(무작위의 정의상 어떤 것으로도 예측할 수 없습니다).
이제 훨씬 그럴듯한 결과가 나왔습니다. 새 추정값에 따르면 이메일을 받은 고객은 대조군 고객보다 평균 4.4헤알을 더 갚을 것으로 기대할 수 있습니다. 이번에는 추정값이 0과 통계적으로 유의하게 다릅니다. 각 그룹 안에서 분산이 줄어든 모습도 그림으로 확인할 수 있습니다.
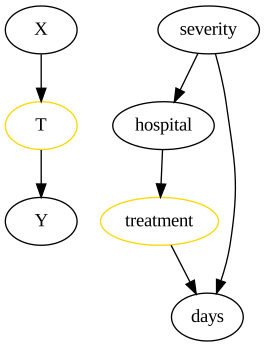
두 번째 예로 병원 두 곳에서 신약을 시험하는 상황을 생각해 봅시다. 두 병원 모두 특정 질병을 치료하는 신약으로 무작위 실험을 진행하고 있습니다. 관심 있는 결과는 입원 일수입니다. 처치가 효과적이라면 환자의 입원 일수가 줄어들 것입니다. 한 병원은 환자의 90%에게 무작위로 신약을 투여하고 나머지 10%에게는 위약을 주는 방침을 따릅니다. 다른 병원의 방침은 다릅니다. 무작위로 고른 환자 10%에게만 신약을 투여하고 90%에게는 위약을 줍니다. 또한 진짜 약을 90%, 위약을 10% 투여하는 병원에는 대개 중증 환자가 더 많이 온다고 합니다.
힌트옮긴이
절 제목은 이 장의 참고 자료에도 나오는 Angrist의 책 『Mostly Harmless Econometrics』(대체로 무해한 계량경제학)를 비튼 말장난입니다.
그런데 직관에 어긋나는 결과가 나왔습니다. 어떻게 처치가 입원 일수를 늘릴 수 있을까요? 답은 서로 다른 실험 두 개를 한데 묶어 분석하고 있다는 데 있습니다. 중증도가 높을수록 입원 일수가 길어지는데, 중증 환자가 많은 병원이 신약도 더 많이 투여하므로 신약과 입원 일수 사이에 양의 상관관계가 생깁니다. 두 병원을 함께 보면 \(E[Y_0|T=0]<E[Y_0|T=1]\)이 됩니다. 즉, 대조군 환자는 중증도가 낮은 병원에 더 많이 몰려 있으므로 대조군의 잠재적 결과가 실험군보다 평균적으로 낮습니다. 다시 말해 중증도는 환자가 어느 병원에 갈지를, 따라서 신약을 받을 확률을 결정하는 교란 요인 역할을 합니다.
이 문제를 해결하는 방법은 두 가지입니다. 첫 번째는 각 병원의 ATE를 따로 보는 것인데, 이렇게 하면 두 병원의 데이터를 함께 쓰는 의미가 없어집니다.
그렇다면 병원도 모델에 넣어야 할까요? 어쨌든 병원이 처치의 원인이라는 것은 알고 있기 때문입니다. 맞는 말입니다. 하지만 중증도를 통제하고 나면 병원은 더 이상 결과인 입원 일수와 상관관계가 없습니다. 그리고 교란 요인이 되려면 처치와 결과 모두의 원인이어야 합니다. 지금 병원은 처치의 원인일 뿐입니다.
그래도 병원을 통제하면 분산이 줄어들지 않을까요? 이번에도 아닙니다. 통제변수가 분산을 줄이려면 처치가 아니라 결과를 잘 예측해야 하는데, 병원은 처치를 잘 예측하는 변수입니다.
그래도 통제하고 싶은 마음이 들 수 있습니다. 넣는다고 해가 될 리는 없지 않을까요… 정말 그럴까요?
이 공식을 보면 표준오차는 변수 \(X\)의 분산에 반비례합니다. 즉, \(X\)가 별로 변하지 않으면 그 변수가 결과에 미치는 효과를 추정하기 어렵습니다. 직관적으로도 말이 됩니다. 극단적인 경우를 상상해 봅시다. 어떤 약의 효과를 추정하려고 10000명을 대상으로 실험했는데, 그중 단 1명만 처치를 받았다고 합시다. 이러면 ATE를 찾기가 매우 어렵습니다. 한 사람을 나머지 모든 사람과 비교하는 수밖에 없기 때문입니다. 달리 말하면, 처치효과를 쉽게 찾으려면 처치에 변동성이 충분히 있어야 합니다.
병원을 모델에 넣으면 추정값의 오차가 커지는 이유는, (중증도를 통제하고 나면) 병원이 결과가 아니라 처치를 잘 예측하는 변수이기 때문입니다. 처치를 예측하므로 사실상 처치의 분산을 줄여 버리는 것입니다! 이번에도 위 회귀를 두 단계로 나누어 확인해 보겠습니다.
sigma_hat =sum(model_treatment.resid**2)/(len(model_treatment.resid)-2)var = sigma_hat/sum((residuals["res_treatment"] - residuals["res_treatment"].mean())**2)print("SE of the Coeficient:", np.sqrt(var))
SE of the Coeficient: 3.446973767486901
결론은 이렇습니다. 위 모델의 중증도처럼 처치와 결과 모두와 상관관계가 있는 통제변수(교란 요인)는 추가해야 합니다. 교란 요인이 아니더라도 결과를 잘 예측하는 통제변수는 추정값의 분산을 줄여 주므로 역시 추가해야 합니다. 하지만 처치만 잘 예측하는 통제변수는 추정값의 분산을 키우므로 추가해서는 안 됩니다.
다시 추심 이메일 예제로 돌아가 보겠습니다. 이메일은 고객에게 무작위로 배정되었다는 것을 기억하세요. credit_limit과 risk_score가 무엇인지는 이미 설명했습니다. 이제 나머지 변수를 살펴보겠습니다. opened는 고객이 이메일을 열어 봤는지를 나타내는 더미변수입니다. agreement는 이메일을 받은 뒤 고객이 채무를 조정하려고 추심 부서에 연락했는지를 나타내는 또 다른 더미변수입니다. 다음 두 모델 중 어느 쪽이 더 적절하다고 생각하나요? 첫 번째는 처치변수에 credit_limit과 risk_score를 더한 모델이고, 두 번째는 여기에 opened와 agreement 더미변수를 추가한 모델입니다.
첫 번째 모델에서는 이메일 효과가 통계적으로 유의하게 나오지만, 두 번째 모델에서는 그렇지 않습니다. 하지만 어쩌면 두 번째 모델이 옳고 이메일에는 효과가 없는지도 모릅니다. 어쨌든 두 번째 모델이 더 많은 요인을 통제하니 더 강건해야 하지 않을까요? 이쯤 되면 그렇지 않다는 것을 눈치챘을 겁니다. 남은 일은 실제로 무슨 일이 일어나고 있는지 밝히는 것입니다.
교란 요인, 즉 처치와 결과 모두의 원인이 되는 변수는 반드시 추가해야 한다는 것을 알고 있습니다. 결과를 아주 잘 예측하는 통제변수를 추가하는 것도 좋은 생각이라는 것을 압니다. 필수는 아니지만 있으면 좋습니다. 처치만 예측하는 통제변수를 추가하는 것은 좋지 않다는 것도 압니다. 이것도 용서받지 못할 죄는 아니지만 피하는 편이 좋습니다. 그렇다면 opened와 agreement는 어떤 통제변수일까요? 알고 보면 둘 다 위의 어느 경우에도 해당하지 않습니다.
생각해 보면 opened와 agreement는 이메일과 분명히 상관관계가 있습니다. 이메일을 받지 않았다면 열어 볼 수도 없고, 합의(agreement) 역시 이메일을 보낸 뒤에 이루어진 채무 재조정만 따진다고 했습니다. 하지만 이 변수들은 이메일의 원인이 아닙니다! 오히려 이메일 때문에 생긴 결과입니다!
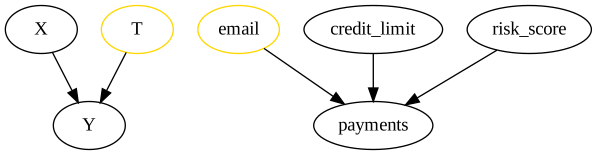
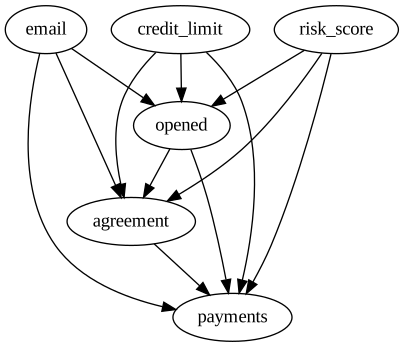
어떤 종류의 변수를 다루고 있는지 파악해야 할 때 저는 늘 인과 그래프를 그려 봅니다. 여기서도 그려 보겠습니다.
이메일은 설계상 무작위이므로 이메일의 원인은 없습니다. 그리고 신용 한도와 위험 점수가 상환액의 원인이라는 것도 알고 있습니다(적어도 그렇게 믿을 만한 강한 근거가 있습니다). 이메일도 상환액의 원인이라고 생각합니다. opened 역시 상환액의 원인이라고 봅니다. 직관적으로 추심 이메일을 열어 본 사람은 채무 조정에 응하고 빚을 갚을 의향이 더 클 것입니다. 같은 이유로 opened는 합의의 원인이기도 합니다. 또한 opened의 원인은 이메일입니다. 위험 점수와 신용 한도에 따라 이메일 열람률이 다를 것이라고 볼 근거도 있으므로, 신용 한도와 위험 점수도 opened의 원인입니다. 합의 역시 opened의 영향을 받는다고 봅니다. 결과변수인 상환액은 다음과 같은 퍼널의 결과로 볼 수 있습니다.
\[
email -> opened -> agreement -> payment
\]
위험 점수와 신용 한도에 따라 합의할 성향도 다를 것이므로, 둘 다 합의의 원인으로 표시하겠습니다. 이메일과 합의의 관계를 보면, 이메일 제목만 읽고도 합의할 가능성이 커지는 사람이 있다고 주장할 수도 있습니다. 요점은 이메일이 열람을 거치지 않고도 합의를 일으킬 수 있다는 것입니다.
이 그래프에서 눈에 띄는 점은 열람과 합의가 모두 이메일에서 상환액으로 가는 인과 경로 위에 있다는 것입니다. 따라서 회귀분석으로 이 변수들을 통제하면 “opened와 agreement를 고정했을 때의 이메일 효과”를 구하는 셈이 됩니다. 그런데 두 변수 모두 이메일 인과효과의 일부이므로 고정해서는 안 됩니다. 오히려 이메일이 상환액을 늘리는 이유가 바로 합의율을 높이기 때문이라고 볼 수도 있습니다. 이 변수들을 고정하면 이메일 변수에서 진짜 효과의 일부를 지워 버리게 됩니다.
잠재적 결과 표기법으로 쓰면, 무작위 배정 덕분에 \(E[Y_0|T=0] = E[Y_0|T=1]\)이 성립합니다. 하지만 무작위 배정을 했더라도 합의를 통제하면 실험군과 대조군은 더 이상 비교 가능하지 않습니다. 사실 조금만 직관적으로 생각해 보면 두 그룹이 어떻게 다른지도 짐작할 수 있습니다.
첫 번째 식은 이메일을 받지 않았고 합의도 하지 않은 사람이, 이메일을 받았지만 합의하지 않은 사람보다 낫다고 본다는 점을 분명히 보여 줍니다. 처치에 긍정적인 효과가 있다면, 이메일을 받고도 합의하지 않은 사람은 이메일이라는 추가 유인 없이 합의하지 않은 사람보다 상환 측면에서 더 나쁜 고객일 가능성이 크기 때문입니다. 두 번째 식을 보면, 처치를 받지 않고도 합의한 사람은 이메일이라는 추가 유인을 받고 합의한 사람보다 더 좋은 고객일 가능성이 큽니다.
처음 읽을 때는 무척 헷갈릴 수 있습니다(저도 그랬습니다). 그래도 꼭 이해하고 넘어가세요. 필요하면 다시 읽어 보세요. 그런 다음 열람 변수에도 비슷한 추론을 적용해 볼 수 있습니다. 직접 해 보세요.
이런 편향은 워낙 흔해서 이름까지 붙어 있습니다. 교란이 공통 원인을 통제하지 않아서 생기는 편향이라면, 선택편향(selection bias)은 공통 효과를 통제하거나, 원인에서 결과로 가는 경로 위에 있는 변수를 통제할 때 생깁니다. 경험칙으로 말하자면, 교란 요인과 \(Y\)를 잘 예측하는 변수는 항상 모델에 넣으세요. \(T\)만 잘 예측하는 변수, 처치와 결과 사이의 매개자(mediator), 처치와 결과의 공통 효과는 항상 빼세요.
선택편향은 너무 흔해서 무작위 배정으로도 막을 수 없습니다. 더 기가 막힌 점은, 무작위 데이터에서도 섣부른 판단 때문에 선택편향이 끼어드는 일이 많다는 것입니다! 선택편향을 알아보고 피하는 데는 재능보다 연습이 더 필요합니다. 선택편향은 그럴듯하게 영리해 보이는 아이디어 밑에 숨어 있는 경우가 많아서 찾아내기가 더 어렵습니다. 제가 실제로 마주친 선택편향 사례를 몇 가지 소개합니다.
추심 전략이 상환액에 미치는 효과를 추정하면서, 빚을 전액 상환했는지를 나타내는 더미변수를 추가하는 경우
교육이 소득에 미치는 효과를 추정하면서 사무직인지 생산직인지를 통제하는 경우
금리가 대출 기간에 미치는 영향을 추정하면서 전환 여부를 통제하는 경우
자녀가 혼외 관계에 미치는 영향을 추정하면서 결혼 생활의 행복도를 통제하는 경우
상환액 \(E[Payments]\)를 모델링할 때, 상환이 일어날지 예측하는 이진 모델과 상환이 일어난다는 조건에서 얼마를 상환할지 예측하는 모델로 나누는 경우: \(E[Payments|Payments>0]*P(Payments>0)\)
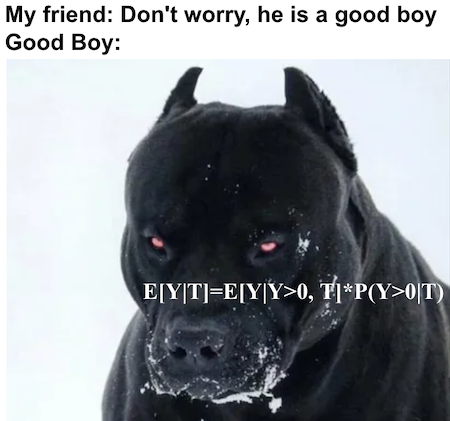
이 아이디어들에서 눈여겨볼 점은 모두 꽤 합리적으로 들린다는 것입니다. 선택편향은 대개 그렇습니다. 경고로 받아들이세요. 사실 저도 이것들이 얼마나 나쁜지 깨닫기 전까지 위의 함정에 수도 없이 빠졌습니다. 그중에서도 마지막 사례는 좀 더 설명할 가치가 있습니다. 무척 영리해 보여서 많은 데이터 과학자가 허를 찔리기 때문입니다. 워낙 흔해서 별명까지 있을 정도입니다. 바로 나쁜 COP(The Bad COP)입니다!
나쁜 COP
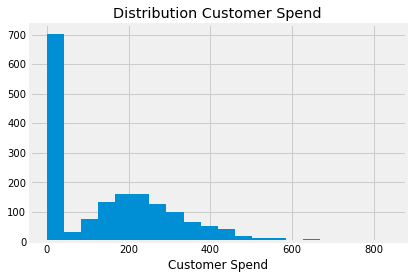
상황은 이렇습니다. 예측하고 싶은 연속형 변수가 있는데 분포가 0에 지나치게 몰려 있습니다. 예를 들어 고객 지출을 모델링한다면 감마 분포와 비슷하지만 0이 아주 많은 분포를 보게 될 것입니다.
힌트옮긴이
COP는 다음 셀에 나오는 Conditional-on-Positives(양수 조건부)의 약자로, ‘good cop, bad cop’(착한 경찰, 나쁜 경찰)의 나쁜 경찰에 빗댄 말장난입니다.
데이터 과학자가 이런 분포를 보면 가장 먼저 떠올리는 생각은 모델링을 두 단계로 나누는 것입니다. 첫 번째 단계는 참여(participation), 즉 \(Y > 0\)일 확률입니다. 지출 예시에서는 고객이 지출을 할지 말지를 모델링하는 셈입니다. 두 번째 단계는 참여하기로 한 사람들의 \(Y\)를 모델링합니다. 이것이 양수 조건부(Conditional-on-Positives, COP) 효과입니다. 이 예시에서는 고객이 조금이라도 쓰기로 한 뒤에 얼마나 쓰는지에 해당합니다. 처치 \(T\)가 지출에 미치는 효과를 추정하고 싶다면 다음과 같이 쓸 수 있습니다.
\[
E[Y|T] = E[Y|Y>0, T]P(Y>0|T)
\]
참여 모델 \(P(Y_i>0|T_i)\)에는 아무 문제가 없습니다. 오히려 \(T\)가 무작위로 배정되었다면 처치로 인해 지출 확률이 얼마나 늘어나는지 잘 포착합니다. 위 분해에도 문제가 없습니다. 전체 확률의 법칙에 따라 수학적으로 참입니다.
문제는 COP 부분을 추정할 때 생깁니다. 무작위로 배정하더라도 편향이 생깁니다. 직관적으로 생각해 보면, 어떤 대상은 처치를 받지 않았기 때문에 0이라고 보는 것도 무리가 아닙니다. 처치를 받으면 이들은 0이 아니게 됩니다. 반면 어떤 대상은 절대 0이 되지 않습니다. 처치가 이들의 결과를 높일 수는 있지만, 처치가 없어도 0이 되지는 않습니다. 핵심은 이 두 유형의 대상이 서로 비교 가능하지 않다는 점을 이해하는 것입니다. 절대 0이 되지 않는 대상은 처치를 받지 않으면 0이 되는 대상보다 \(Y_0\)가 높습니다. 사실 후자는 \(Y_0=0\)입니다.
이를 염두에 두고 0을 제거하면, 실험군과 대조군 모두에 ‘절대 0이 아닌’ 대상은 그대로 남습니다. 하지만 처치를 받으면 0에서 0이 아닌 값으로 바뀌는 대상은 대조군에서 빠집니다. 그러면 실험군과 대조군은 더 이상 비교 가능하지 않습니다. 대조군에는 \(Y_0\)가 높은 ‘절대 0이 아닌’ 대상만 남는 반면, 실험군에는 두 유형이 모두 들어 있기 때문입니다.
이제 문제를 직관적으로 이해했으니 수학적으로도 확인해 보겠습니다. 처치효과를 분해해 봅시다. 무작위 배정에서 처치효과는 평균 차이와 같습니다.
마지막 등식은 \(E[Y_i|Y_i>0, T_i=1]P(Y_i>0|T_i=0)\)를 더하고 빼서 항을 다시 정리하면 얻을 수 있습니다. 즉, 평균 차이는 두 부분으로 이루어집니다. 첫째는 결과 \(y\)가 양수일 확률의 차이입니다. 고객이 지출에 참여할 확률이 얼마나 늘었는지를 측정하므로 참여 효과라고 부릅니다. 둘째는 참여를 조건으로 한 결과의 차이, 즉 COP 효과입니다. 여기까지는 괜찮습니다. 아무 문제도 없습니다. 수학적으로 참이기 때문입니다. 문제는 각 부분을 따로 추정하려 할 때 생깁니다.
두 번째 등식은 \(E[Y_{i0}|Y_{i1}>0]\)를 더하고 빼서 얻습니다. COP 효과를 분해하면 먼저 참여자 하위 집단에 대한 인과효과가 나옵니다. 이 예시에서는 조금이라도 지출하기로 한 사람들에 대한 인과효과입니다. 다음으로 편향 항이 나오는데, 처치에 배정되었을 때 참여하는 사람들(\(E[Y_{i0}|Y_{i1}>0]\))과 처치 없이도 참여하는 사람들(\(E[Y_{i0}|Y_{i0}>0]\))의 \(Y_0\) 차이입니다. 이 예시에서는 이 편향이 음수일 가능성이 큽니다. 처치에 배정되었을 때 지출하는 사람들은, 처치를 받지 않았다면 처치 없이도 지출하는 사람들보다 덜 썼을 가능성이 크기 때문입니다. 즉, \(E[Y_{i0}|Y_{i1}>0] < E[Y_{i0}|Y_{i0}>0]\)입니다.
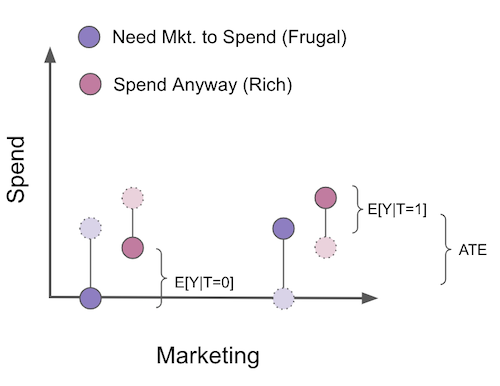
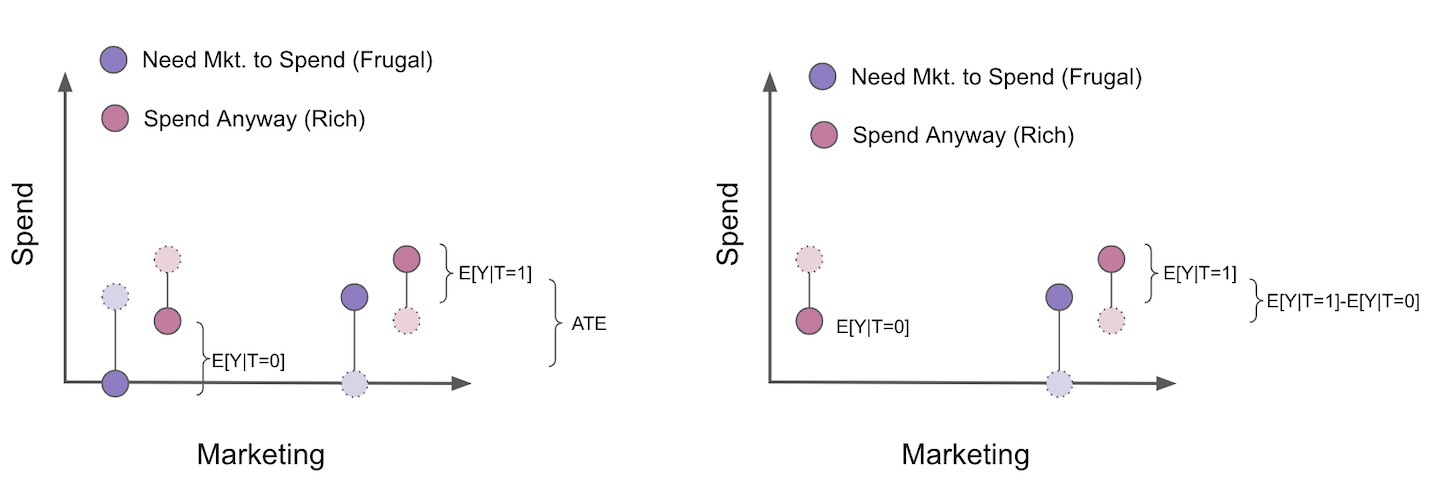
COP 편향은 처음 접하면 굉장히 직관에 어긋나 보이므로, 그림으로 예를 하나 살펴보는 게 좋겠습니다. 마케팅 캠페인이 우리 제품에 대한 고객 지출을 얼마나 늘리는지 추정하고 싶다고 해 봅시다. 캠페인은 무작위로 배정되었으므로 교란은 걱정하지 않아도 됩니다. 이 예시에서는 고객을 두 세그먼트로 나눌 수 있습니다. 첫째, 마케팅 캠페인을 봐야만 우리 제품을 사는 고객이 있습니다. 이들을 알뜰 고객(frugal)이라고 부르겠습니다. 누군가 등을 한 번 더 떠밀어 주지 않으면 지갑을 열지 않는 사람들입니다. 다음으로 캠페인이 없어도 지출하는 고객이 있습니다. 캠페인을 보면 더 많이 쓰지만, 캠페인을 보지 않았더라도 어차피 지출했을 사람들입니다. 이들을 부자 고객(rich)이라고 부르겠습니다. 그림에서 반사실(counterfactual)은 연한 색과 점선으로 표시했습니다.
무작위 배정을 했으므로 캠페인의 ATE를 추정하려면 실험군과 대조군을 비교하기만 하면 됩니다. 그런데 COP 방식을 써서 추정을 두 모델로 나눈다고 해 봅시다. \(P(Y_i>0|T_i)\)를 추정하는 참여 모델과 \(E[Y_i|Y_i>0]\)를 추정하는 COP 모델입니다. 이렇게 하면 지출하지 않은 사람은 모두 분석에서 빠집니다.
그러면 실험군과 대조군은 더 이상 비교 가능하지 않습니다. 그림에서 보듯 이제 대조군에는 캠페인이 없어도 지출하는 고객 세그먼트만 남아 있습니다. 여기서는 편향의 방향까지 알 수 있다는 점도 눈여겨보세요. 편향은 \(E[Y_{i0}|Y_{i1}>0] - E[Y_{i0}|Y_{i0}>0]\), 즉 \(E[Y_{i0}|\text{Frugal and Rich}] - E[Y_{i0}|Rich]\)가 됩니다. 부자 고객이 알뜰 고객보다 더 많이 쓰므로 이 값은 당연히 음수입니다. 결국 참여한 집단만 걸러 내면, 처음에는 무작위 배정 덕분에 편향이 없었더라도 ATE 추정값이 편향됩니다. 이 정도면 COP를 전염병 피하듯 피해야겠다는 생각이 드셨기를 진심으로 바랍니다. 이렇게 따로 추정하는 방식이 어떤 문제를 일으키는지 모른 채 쓰고 있는 데이터 과학자를 너무 많이 봤습니다.
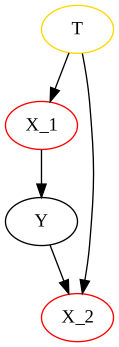
선택편향 이야기를 마무리하며 늘 되새겨야 할 점은, 처치와 결과 사이에 있는 변수나 처치와 결과의 공통 효과인 변수는 절대 통제하면 안 된다는 것입니다. 그래프로 나타내면 나쁜 통제변수는 다음과 같은 모습입니다.
이 장에서는 교란 요인이 아닌 변수를 살펴보고, 인과효과를 식별할 때 이런 변수를 모델에 넣어야 하는지 알아봤습니다. 결과 \(y\)를 잘 예측하는 변수는 \(T\)를 예측하지 않더라도(교란 요인이 아니더라도) 모델에 넣어야 한다는 것을 확인했습니다. 이런 변수는 \(Y\)의 분산을 줄여 주므로 인과효과를 추정할 때 통계적으로 유의한 결과를 얻을 가능성이 커지기 때문입니다. 다음으로 처치는 예측하지만 결과는 예측하지 않는 변수를 넣는 것은 좋지 않다는 것을 알아봤습니다. 이런 변수는 처치의 변동성을 줄여 인과효과를 찾기 어렵게 만듭니다. 마지막으로 선택편향을 살펴봤습니다. 선택편향은 처치에서 결과로 가는 인과 경로 위의 변수나 처치와 결과의 공통 효과인 변수를 통제할 때 생기는 편향입니다.
참고 자료
저는 이 책 전체를 Joshua Angrist, Alberto Abadie, Christopher Walters의 훌륭한 계량경제학 강의에 바치는 헌사라고 생각합니다. 이 책에 담긴 아이디어 대부분은 이들이 미국경제학회(American Economic Association)에서 한 강의에서 가져왔습니다. 힘든 2020년을 버틸 수 있는 것도 이 강의들을 보는 덕분입니다. * Cross-Section Econometrics * Mastering Mostly Harmless Econometrics
Angrist의 멋진 책들도 참고 자료로 소개하고 싶습니다. 이 책들 덕분에 계량경제학, 이들 표현으로는 ’Metrics가 아주 유용할 뿐 아니라 무척 재미있다는 것을 알게 되었습니다.
Causal Inference for the Brave and True는 과학의 통계학이라 할 수 있는 인과추론을 다루는 오픈소스 자료입니다. 파이썬 기반의 무료 소프트웨어만 사용하며, 돈이 없어도, 배경지식이 많지 않아도 누구나 볼 수 있는 자료를 목표로 합니다. 이 책이 도움이 되었고 후원하고 싶다면 Patreon을 방문해 주세요. 금전적으로 기여하기 어렵다면 오타를 고치거나, 수정할 부분을 제안하거나, 이해하기 어려웠던 부분에 의견을 주는 것으로도 도울 수 있습니다. 책의 저장소에서 이슈를 열어 주세요. 마지막으로 이 내용이 마음에 들었다면 도움이 될 만한 사람들과 공유하고 GitHub에서 스타를 눌러 주세요.
의견 나누기
번역이 어색한 곳, 더 쉬운 설명, 궁금한 점을 남겨 주세요. GitHub 계정으로 로그인하면 댓글을 달 수 있고, 남긴 의견은 GitHub Discussions에 장별로 모입니다.