코드
import warnings
warnings.filterwarnings('ignore')

import pandas as pd
import numpy as np
from scipy import stats
import seaborn as sns
from matplotlib import pyplot as plt
from matplotlib import style
style.use("fivethirtyeight")Howard Wainer는 2007년에 발표한 유명한 글에서 아주 위험한 공식들에 관해 이렇게 이야기합니다.
“어떤 공식은 알면 위험하고, 어떤 공식은 모르면 위험합니다. 첫 번째 부류가 위험할 수 있는 까닭은 그 안에 담긴 비밀이 무시무시한 재앙이 도사린 문을 열어 주기 때문입니다. 이 부류에서 단연 으뜸은 아인슈타인의 상징적인 공식 \(E = mc^2\)입니다. 평범한 물질 속에 숨은 엄청난 에너지를 가늠하게 해 주기 때문입니다. […] 하지만 제가 관심을 두는 것은 알 때가 아니라 모를 때 위험을 드러내는 공식입니다. 곁에 두면 세상을 명확하게 이해하게 해 주지만, 없으면 우리를 위험할 만큼 무지하게 만드는 공식들입니다.”
그가 말하는 공식은 바로 드무아브르의 공식(Moivre’s equation)입니다.
\[ SE = \dfrac{\sigma}{\sqrt{n}} \]
여기서 \(SE\)는 평균의 표준오차(standard error), \(\sigma\)는 표준편차(standard deviation), \(n\)은 표본 크기(sample size)입니다. 용감하고 진실한 사람이라면 반드시 익혀야 할 수학 같으니, 바로 들어가 보겠습니다.
이 공식을 모르는 게 왜 그렇게 위험한지 보기 위해 교육 데이터를 살펴보겠습니다. 저는 여러 학교의 3년 치 ENEM 점수(브라질판 수능이라 할 수 있는 고등학생 표준화 시험 점수)를 모았습니다. 그리고 우리에게 필요한 정보만 남도록 데이터를 정리했습니다. 원본 데이터는 Inep 웹사이트에서 내려받을 수 있습니다.
성적이 가장 좋은 학교들을 보면 눈에 띄는 점이 하나 있습니다. 학생 수가 꽤 적다는 것입니다.
import warnings
warnings.filterwarnings('ignore')
import pandas as pd
import numpy as np
from scipy import stats
import seaborn as sns
from matplotlib import pyplot as plt
from matplotlib import style
style.use("fivethirtyeight")df = pd.read_csv("./data/enem_scores.csv")
df.sort_values(by="avg_score", ascending=False).head(10)| year | school_id | number_of_students | avg_score | |
|---|---|---|---|---|
| 16670 | 2007 | 33062633 | 68 | 82.97 |
| 16796 | 2007 | 33065403 | 172 | 82.04 |
| 16668 | 2005 | 33062633 | 59 | 81.89 |
| 16794 | 2005 | 33065403 | 177 | 81.66 |
| 10043 | 2007 | 29342880 | 43 | 80.32 |
| 18121 | 2007 | 33152314 | 14 | 79.82 |
| 16781 | 2007 | 33065250 | 80 | 79.67 |
| 3026 | 2007 | 22025740 | 144 | 79.52 |
| 14636 | 2007 | 31311723 | 222 | 79.41 |
| 17318 | 2007 | 33087679 | 210 | 79.38 |
다른 각도에서, 상위 1% 학교만 따로 떼어 살펴볼 수도 있습니다. 이 학교들은 어떤 모습일까요? 최고의 학교에서 무언가를 배워 다른 곳에도 적용할 수 있을지 모릅니다. 아니나 다를까, 상위 1% 학교를 보면 평균적으로 학생 수가 더 적습니다.
plot_data = (df
             .assign(top_school = df["avg_score"] >= np.quantile(df["avg_score"], .99))
             [["top_school", "number_of_students"]]
             .query(f"number_of_students<{np.quantile(df['number_of_students'], .98)}")) # remove outliers

plt.figure(figsize=(6,6))
sns.boxplot(x="top_school", y="number_of_students", data=plot_data)
plt.title("Number of Students of 1% Top Schools (Right)");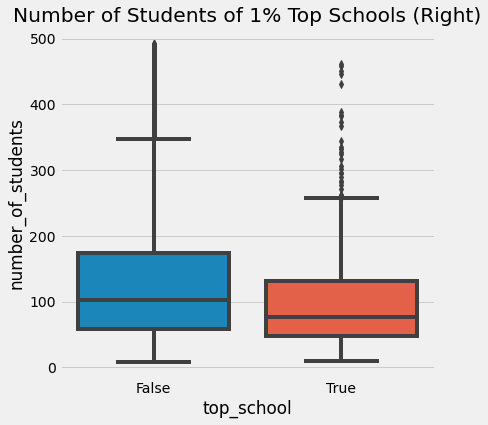
자연스럽게 떠오르는 결론은 작은 학교가 더 높은 학업 성취를 이끈다는 것입니다. 교사 한 명이 맡는 학생 수가 적을수록 학생 한 명 한 명에게 더 집중할 수 있다고 믿으니, 직관적으로도 그럴듯합니다. 그런데 이게 드무아브르의 공식과 무슨 관계가 있을까요? 그리고 왜 위험하다는 걸까요?
사람들이 이 정보를 근거로 중요하고 돈이 많이 드는 결정을 내리기 시작하면 위험해집니다. Howard는 글에서 이렇게 이어 갑니다.
“1990년대에는 학교 규모를 줄이자는 주장이 크게 유행했습니다. 수많은 자선 단체와 정부 기관이 큰 학교를 쪼개는 데 자금을 댔습니다. 시험 점수가 높은 집단에 작은 학교 학생들이 유난히 많았기 때문입니다.”
사람들이 잊은 것은 하위 1% 학교도 함께 살펴보는 일이었습니다. 그렇게 해 보면, 이게 웬일입니까! 이 학교들도 학생 수가 아주 적습니다!
q_99 = np.quantile(df["avg_score"], .99)
q_01 = np.quantile(df["avg_score"], .01)

plot_data = (df
             .sample(10000)
             .assign(Group = lambda d: np.select([d["avg_score"] > q_99, d["avg_score"] < q_01],
                                                 ["Top", "Bottom"], "Middle")))
plt.figure(figsize=(10,5))
sns.scatterplot(y="avg_score", x="number_of_students", hue="Group", data=plot_data)
plt.title("ENEM Score by Number of Students in the School");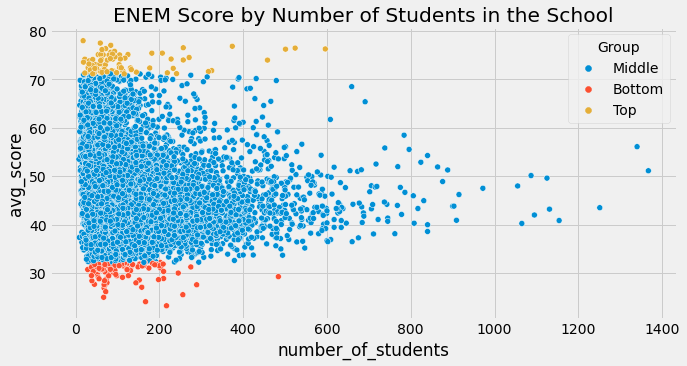
위 그림은 드무아브르의 공식이 예측하는 모습을 그대로 보여 줍니다. 학생 수가 늘어날수록 평균 점수는 점점 더 정밀해집니다. 표본이 아주 적은 학교는 순전히 우연 때문에 점수가 아주 높게도, 아주 낮게도 나올 수 있습니다. 큰 학교에서는 이런 일이 일어날 가능성이 낮습니다. 드무아브르의 공식은 데이터라는 형태로 기록된 정보에 관한 근본적인 사실 하나를 알려 줍니다. 데이터는 언제나 부정확하다는 것입니다. 그렇다면 남는 질문은 얼마나 부정확하냐는 것입니다.
통계학은 이런 부정확성을 다뤄서 우리가 허를 찔리지 않게 해 주는 학문입니다. Taleb은 『행운에 속지 마라(Fooled by Randomness)』에서 이렇게 말합니다.
확률은 단순히 주사위의 승산이나 그보다 복잡한 변형을 계산하는 일이 아니다. 확률이란 우리 지식에 확실성이 없음을 받아들이고, 우리의 무지를 다루는 방법을 개발하는 것이다.
불확실성을 수치로 나타내는 한 가지 방법은 추정값의 분산입니다. 분산은 관측값이 중심값, 즉 가장 그럴듯한 값에서 얼마나 벗어나는지 알려 줍니다. 드무아브르의 공식이 보여 주듯이, 이 불확실성은 관측하는 데이터의 양이 늘어날수록 줄어듭니다. 말이 되죠? 어떤 학교에서 많은 학생이 뛰어난 성적을 낸다면 그 학교가 정말 좋은 학교라고 더 확신할 수 있습니다. 하지만 학생이 10명뿐인 학교에서 8명이 좋은 성적을 냈다면 좀 더 의심해 봐야 합니다. 어쩌다 평균 이상인 학생들이 그 학교에 모였을 수도 있기 때문입니다.
위에서 본 아름다운 삼각형 그래프가 바로 이 이야기를 들려줍니다. 표본 크기가 작을 때는 학교 성적 추정값의 분산이 아주 크고, 표본 크기가 커질수록 분산이 줄어든다는 것을 보여 줍니다. 학교의 평균 점수만 그런 것이 아닙니다. 우리가 자주 추정하려는 평균 처치효과(ATE)를 포함해 모든 요약 통계량이 마찬가지입니다.
통계 복습일 뿐이니 이제부터는 조금 빠르게 진행하겠습니다. 분포, 분산, 표준오차가 익숙하지 않다면 계속 읽되, 다른 자료가 더 필요할 수 있다는 점은 염두에 두세요. MIT의 통계학 입문 강의를 아무거나 검색해 보길 권합니다. 대체로 꽤 좋습니다.
앞 장에서는 평균 처치효과 \(E[Y_1-Y_0]\)를 실험군(treated)과 대조군(untreated)의 평균 차이 \(E[Y|T=1]-E[Y|T=0]\)로 추정했습니다. 그때 예제로 다룬 것이 온라인 수업의 \(ATE\)였습니다. 효과는 부정적이었습니다. 온라인 수업을 들은 학생들이 대면 수업을 들은 학생들보다 점수가 5점가량 낮았습니다. 이제 이 효과가 통계적으로 유의한지 확인해 보겠습니다.
그러려면 \(SE\)를 추정해야 합니다. 표본 크기 \(n\)은 이미 알고 있습니다. 표준편차의 추정값은 다음과 같이 구할 수 있습니다.
\[ \hat{\sigma}=\sqrt{\frac{1}{N-1}\sum_{i=1}^N (x_i-\bar{x})^2} \]
여기서 \(\bar{x}\)는 \(x\)의 평균입니다. 다행히 대부분의 프로그래밍 도구에 이 계산이 이미 구현되어 있습니다. Pandas에서는 std 메서드를 쓰면 됩니다.
data = pd.read_csv("./data/online_classroom.csv")
online = data.query("format_ol==1")["falsexam"]
face_to_face = data.query("format_ol==0 & format_blended==0")["falsexam"]

def se(y: pd.Series):
    return y.std() / np.sqrt(len(y))

print("SE for Online:", se(online))
print("SE for Face to Face:", se(face_to_face))
SE for Online: 1.5371593973041635
SE for Face to Face: 0.8723511456319106추정값의 표준오차는 확신의 정도를 나타내는 척도입니다. 이것이 정확히 무엇을 뜻하는지 이해하려면 거칠고 논쟁이 끊이지 않는 통계학의 바다로 들어가야 합니다. 통계학의 한 관점인 빈도주의(frequentist) 관점에서는 데이터가 정확한 데이터 생성 과정이 겉으로 드러난 것에 지나지 않는다고 봅니다. 이 과정은 추상적이고 이상적입니다. 변하지 않지만 우리는 알 수 없는 참 매개변수가 이 과정을 지배합니다. 학생들의 시험으로 말하자면, 실험을 여러 번 해서 데이터셋을 여러 개 모을 수 있다면 모든 데이터셋이 그 밑에 있는 참 데이터 생성 과정과 닮았겠지만 똑같지는 않을 것입니다. 플라톤이 이데아(Forms)에 관해 쓴 글과 무척 비슷합니다.
[본질적인 형상] 각각은 행위와도, 물체와도, 또 서로와도 온갖 방식으로 결합해 모습을 드러내며, 그래서 각각이 여럿으로 보인다네.
이해를 돕기 위해 학생들 시험 점수의 참 추상 분포가 있다고 가정해 보겠습니다. 참 평균이 74이고 참 표준편차가 2인 정규분포입니다. 이 분포에서 실험을 10000번 실행하고, 실험마다 표본을 500개씩 모읍니다. 실험 평균들을 히스토그램으로 그려 보면 참 평균 주위에 분포한다는 것을 알 수 있습니다. 어떤 실험 데이터는 평균이 참 평균보다 낮고, 어떤 실험 데이터는 더 높습니다.
true_std = 2
true_mean = 74

n = 500
def run_experiment():
    return np.random.normal(true_mean,true_std, 500)

np.random.seed(42)

plt.figure(figsize=(8,5))
freq, bins, img = plt.hist([run_experiment().mean() for _ in range(10000)], bins=40, label="Experiment Means")
plt.vlines(true_mean, ymin=0, ymax=freq.max(), linestyles="dashed", label="True Mean", color="orange")
plt.legend();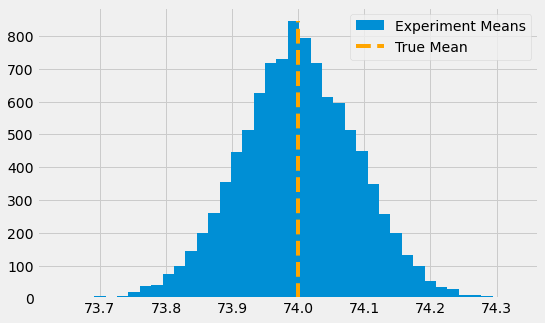
여기서 이야기하는 것이 평균들의 평균이라는 점에 주목하세요. 우연히 평균이 참 평균보다 조금 낮거나 높은 실험이 나올 수 있습니다. 다시 말해 우리 실험의 평균이 플라톤적이고 이상적인 참 평균과 일치한다고는 결코 확신할 수 없습니다. 하지만 표준오차를 이용하면 95%의 경우에 참 평균을 포함하는 구간을 만들 수 있습니다.
현실에서는 같은 실험을 여러 데이터셋으로 시뮬레이션하는 호사를 누릴 수 없습니다. 대개 데이터셋은 하나뿐입니다. 하지만 위의 직관을 바탕으로 신뢰구간(confidence interval)이라는 것을 만들 수 있습니다. 신뢰구간에는 확률이 하나 따라붙는데, 가장 흔한 것은 95%입니다. 이 확률은 서로 다른 연구에서 만든 가상의 신뢰구간들 가운데 얼마나 많은 구간이 참 평균을 포함하는지를 알려 줍니다. 예를 들어 비슷한 연구들에서 계산한 95% 신뢰구간은 95%의 경우에 참 평균을 포함합니다.
신뢰구간을 계산할 때는 중심극한정리(central limit theorem)를 이용합니다. 이 정리에 따르면 실험의 평균들은 정규분포를 따릅니다. 통계 이론에서 알 수 있듯이 정규분포 질량의 95%는 평균 위아래로 표준편차 2배 이내에 있습니다. 엄밀히는 1.96이지만 2로도 충분합니다.
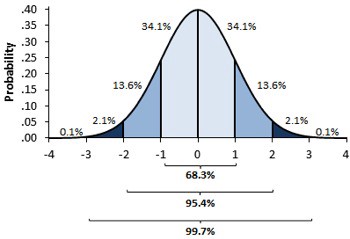
평균의 표준오차는 실험 평균들이 이루는 분포에 대한 추정값 역할을 합니다. 따라서 표준오차에 2를 곱한 값을 한 실험의 평균에 더하고 빼면 참 평균에 대한 95% 신뢰구간을 만들 수 있습니다.
np.random.seed(321)
exp_data = run_experiment()
exp_se = exp_data.std() / np.sqrt(len(exp_data))
exp_mu = exp_data.mean()
ci = (exp_mu - 2 * exp_se, exp_mu + 2 * exp_se)
print(ci)
(73.82718114045632, 74.17341543460314)x = np.linspace(exp_mu - 4*exp_se, exp_mu + 4*exp_se, 100)
y = stats.norm.pdf(x, exp_mu, exp_se)
plt.plot(x, y)
plt.vlines(ci[1], ymin=0, ymax=1)
plt.vlines(ci[0], ymin=0, ymax=1, label="95% CI")
plt.legend()
plt.show()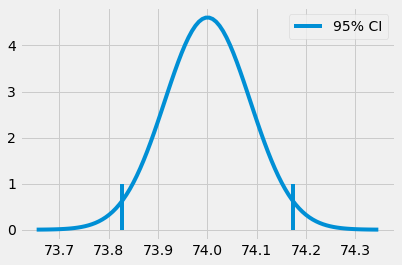
물론 95% 신뢰구간에만 머물 필요는 없습니다. 정규분포 질량의 99%를 담으려면 표준편차에 얼마를 곱해야 하는지 찾으면 99% 구간도 만들 수 있습니다.
파이썬의 ppf 함수는 누적분포함수(CDF)의 역함수를 돌려줍니다. 95% 신뢰구간을 구할 때처럼 표준오차에 2를 곱하는 대신 z를 곱하면 99% 신뢰구간이 나옵니다. 예를 들어 ppf(0.5)는 0.0을 반환하는데, 표준정규분포(평균 0, 표준편차 1)의 질량 중 50%가 0.0 아래에 있다는 뜻입니다. 같은 원리로 99.5%를 넣으면 분포 질량의 99.5%가 그 아래에 놓이는 값 z를 얻습니다. 바꿔 말하면 질량의 0.5%가 이 값보다 위에 있습니다.
from scipy import stats
z = stats.norm.ppf(.995)
print(z)
ci = (exp_mu - z * exp_se, exp_mu + z * exp_se)
ci2.5758293035489004(73.7773381773405, 74.22325839771896)x = np.linspace(exp_mu - 4*exp_se, exp_mu + 4*exp_se, 100)
y = stats.norm.pdf(x, exp_mu, exp_se)
plt.plot(x, y)
plt.vlines(ci[1], ymin=0, ymax=1)
plt.vlines(ci[0], ymin=0, ymax=1, label="99% CI")
plt.legend()
plt.show()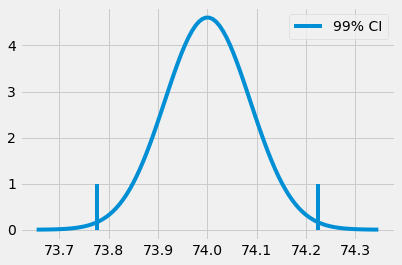
교실 실험으로 돌아가서, 온라인 수업 학생 집단과 대면 수업 학생 집단 각각의 평균 시험 점수에 대한 신뢰구간을 만들어 보겠습니다.
def ci(y: pd.Series):
    return (y.mean() - 2 * se(y), y.mean() + 2 * se(y))

print("95% CI for Online:", ci(online))
print("95% for Face to Face:", ci(face_to_face))
95% CI for Online: (70.56094429049804, 76.7095818797147)
95% for Face to Face: (76.80278229206951, 80.29218687459715)두 집단의 95% 신뢰구간이 겹치지 않습니다. 대면 수업 신뢰구간의 하한이 온라인 수업 신뢰구간의 상한보다 위에 있습니다. 이 결과가 우연이 아니며, 대면 수업 학생들의 참 평균이 온라인 수업 학생들의 참 평균보다 높다는 증거입니다. 다시 말해 대면 수업에서 온라인 수업으로 바꾸면 학업 성취도가 인과적으로, 그리고 유의하게 떨어집니다.
정리하면, 신뢰구간은 추정값에 불확실성을 덧붙이는 방법입니다. 표본 크기가 작을수록 표준오차가 커지고 신뢰구간도 넓어집니다. 신뢰구간은 아주 쉽게 계산할 수 있습니다. 그러니 신뢰구간이 빠져 있다면 나쁜 의도가 있거나 그저 지식이 부족하다는 신호이고, 어느 쪽이든 똑같이 걱정스럽습니다. 그리고 불확실성 지표가 하나도 없는 측정값은 늘 의심해야 합니다.
마지막으로 한 가지 주의할 점이 있습니다. 신뢰구간은 언뜻 보기보다 해석하기 까다롭습니다. 예를 들어 이 특정 95% 신뢰구간이 95% 확률로 참 모평균을 포함한다고 말해서는 안 됩니다. 신뢰구간을 쓰는 빈도주의 통계학에서는 모평균을 참된 모집단 상수로 봅니다. 그러니 모평균은 우리가 구한 특정 신뢰구간 안에 있거나 없거나 둘 중 하나입니다. 즉, 특정 신뢰구간은 참 평균을 포함하거나 포함하지 않습니다. 포함한다면 포함할 확률은 95%가 아니라 100%이고, 포함하지 않는다면 0%입니다. 신뢰구간에서 95%는 여러 연구에서 계산한 그런 신뢰구간들이 참 평균을 포함하는 빈도를 가리킵니다. 95%는 95% 신뢰구간을 계산하는 알고리즘에 대한 신뢰이지, 특정 구간 자체에 대한 신뢰가 아닙니다.
그렇긴 하지만, 경제학자로서(통계학자 여러분은 잠시 눈을 돌려 주세요) 저는 이런 순수주의가 그다지 쓸모 있다고 생각하지 않습니다. 실무에서는 특정 신뢰구간이 95%의 확률로 참 평균을 포함한다고 말하는 사람을 자주 봅니다. 틀린 말이긴 해도 크게 해롭지는 않습니다. 여전히 추정값에 정확한 수준의 불확실성을 부여하기 때문입니다. 게다가 베이지안 통계학으로 넘어가 신뢰구간 대신 확률 구간을 쓰면, 그 구간이 95%의 확률로 분포의 평균을 포함한다고 말할 수 있습니다. 또 제가 실무에서 본 바로는, 표본 크기가 적당히 크면 베이지안 확률 구간은 베이지안도 빈도주의자도 인정하고 싶어 하는 것보다 신뢰구간과 더 비슷합니다. 그러니 제 말에 조금이라도 무게가 있다면, 신뢰구간을 두고 마음대로 말해도 좋습니다. 신뢰구간이 95%의 확률로 참 평균을 포함한다고 말해도 저는 상관하지 않습니다. 다만 추정값에 신뢰구간을 붙이는 일만은 절대 잊지 마세요. 그러지 않으면 우스워 보일 테니 말입니다.
위 문단에 나오는 베이지안의 ’확률 구간’은 보통 신용구간(credible interval)이라고 부릅니다.
불확실성을 반영하는 또 다른 방법은 가설검정(hypothesis test)을 하는 것입니다. 평균의 차이가 0(또는 다른 어떤 값)과 통계적으로 다른지를 묻는 것입니다. 서로 독립인 정규분포 2개의 합이나 차도 정규분포라는 사실을 떠올려 봅시다. 그 결과로 나오는 분포의 평균은 두 분포 평균의 합이나 차가 되고, 분산은 언제나 두 분산의 합이 됩니다.
\[ N(\mu_1, \sigma_1^2) - N(\mu_2, \sigma_2^2) = N(\mu_1 - \mu_2, \sigma_1^2 + \sigma_2^2) \]
\[ N(\mu_1, \sigma_1^2) + N(\mu_2, \sigma_2^2) = N(\mu_1 + \mu_2, \sigma_1^2 + \sigma_2^2) \]
기억나지 않아도 괜찮습니다. 언제든 코드와 시뮬레이션 데이터로 확인해 볼 수 있기 때문입니다.
np.random.seed(123)
n1 = np.random.normal(4, 3, 30000)
n2 = np.random.normal(1, 4, 30000)
n_diff = n2 - n1
sns.distplot(n1, hist=False, label="$N(4,3^2)$")
sns.distplot(n2, hist=False, label="$N(1,4^2)$")
sns.distplot(n_diff, hist=False, label=f"$N(1,4^2) - (4,3^2) = N(-3, 5^2)$")
plt.legend()
plt.show()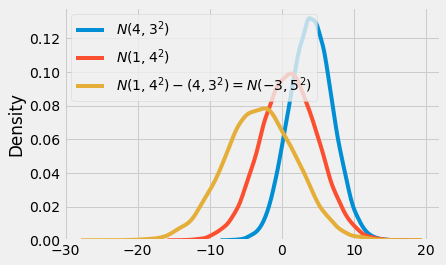
두 집단의 평균이 이루는 분포를 가져와 하나에서 다른 하나를 빼면 세 번째 분포가 생깁니다. 이 마지막 분포의 평균은 평균의 차이이고, 표준편차는 표준편차들의 합의 제곱근입니다.
\[ \mu_{diff} = \mu_1 - \mu_2 \]
\[ SE_{diff} = \sqrt{SE^2_1 + SE^2_2} = \sqrt{\sigma_1^2/n_1 + \sigma_2^2/n_2} \]
교실 예제로 돌아가 이 차이의 분포를 만들어 보겠습니다. 분포를 구하고 나면 95% 신뢰구간을 만드는 것은 간단합니다.
정확히는 표준편차들의 합이 아니라 분산(표준오차의 제곱)들의 합의 제곱근입니다. 위 두 번째 식이 바로 그 계산입니다.
diff_mu = online.mean() - face_to_face.mean()
diff_se = np.sqrt(face_to_face.var()/len(face_to_face) + online.var()/len(online))
ci = (diff_mu - 1.96*diff_se, diff_mu + 1.96*diff_se)
print(ci)
(-8.376410208363385, -1.4480327880905248)x = np.linspace(diff_mu - 4*diff_se, diff_mu + 4*diff_se, 100)
y = stats.norm.pdf(x, diff_mu, diff_se)
plt.plot(x, y)
plt.vlines(ci[1], ymin=0, ymax=.05)
plt.vlines(ci[0], ymin=0, ymax=.05, label="95% CI")
plt.legend()
plt.show()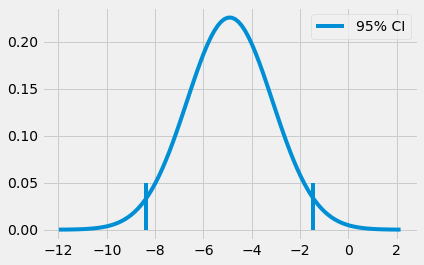
이제 온라인 집단과 대면 집단의 참 차이가 -8.37에서 -1.44 사이에 있다고 95% 신뢰할 수 있습니다. 평균의 차이를 차이의 \(SE\)로 나누어 z 통계량(z statistic)을 만들 수도 있습니다.
\[ z = \dfrac{\mu_{diff} - H_{0}}{SE_{diff}} = \dfrac{(\mu_1 - \mu_2) - H_{0}}{\sqrt{\sigma_1^2/n_1 + \sigma_2^2/n_2}} \]
여기서 \(H_0\)는 차이와 비교해 검정하려는 값입니다.
z 통계량은 관측된 차이가 얼마나 극단적인지를 나타내는 척도입니다. 평균의 차이가 0과 통계적으로 다르다는 가설은 귀류법으로 검정합니다. 반대가 참이라고, 즉 차이가 0이라고 가정하는 것입니다. 이를 귀무가설(null hypothesis), 또는 \(H_0\)라고 합니다. 그런 다음 “참 차이가 0이라면 이 정도 차이를 관측할 가능성이 있을까?”라고 스스로 묻습니다. 통계학의 수학 언어로 바꾸면, 이 질문은 z 통계량이 0에서 얼마나 멀리 떨어져 있는지 확인하는 문제가 됩니다.
\(H_0\) 아래에서 z 통계량은 표준정규분포를 따릅니다. 따라서 차이가 정말 0이라면 95%의 경우에 z 통계량은 평균에서 표준편차 2배 이내에 있을 것입니다. 곧바로 따라 나오는 결론은, z가 표준편차 2배를 넘어 위나 아래로 벗어나면 95% 신뢰도로 귀무가설을 기각할 수 있다는 것입니다.
교실 예제에서는 어떻게 되는지 보겠습니다.
z = diff_mu / diff_se
print(z)-2.7792810791031224x = np.linspace(-4,4,100)
y = stats.norm.pdf(x, 0, 1)
plt.plot(x, y, label="Standard Normal")
plt.vlines(z, ymin=0, ymax=.05, label="Z statistic", color="C1")
plt.legend()
plt.show()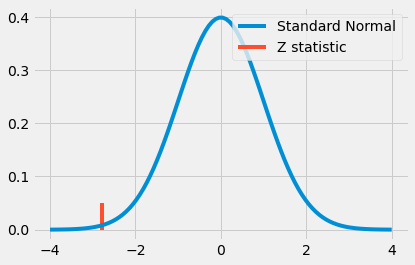
꽤 극단적인 값으로 보입니다. 실제로 2보다 크니, 두 집단 사이에 차이가 없다면 이렇게 극단적인 값을 볼 확률은 5%도 안 된다는 뜻입니다. 이번에도 대면 수업에서 온라인 수업으로 바꾸면 학업 성취도가 통계적으로 유의하게 떨어진다는 결론에 이릅니다.
가설검정에 관해 마지막으로 흥미로운 점은, 실험군과 대조군의 95% 신뢰구간이 겹치는지 확인하는 방법보다 덜 보수적이라는 것입니다. 다시 말해 두 집단의 신뢰구간이 겹치더라도 결과가 통계적으로 유의할 수 있습니다. 예를 들어 대면 집단의 평균 점수가 80이고 표준오차가 4이며, 온라인 집단의 평균 점수가 71이고 표준오차가 2라고 해 보겠습니다.
cont_mu, cont_se =  (71, 2)
test_mu, test_se = (80, 4)

diff_mu = test_mu - cont_mu
diff_se = np.sqrt(cont_se**2 + test_se**2)

print("Control 95% CI:", (cont_mu-1.96*cont_se, cont_mu+1.96*cont_se))
print("Test 95% CI:", (test_mu-1.96*test_se, test_mu+1.96*test_se))
print("Diff 95% CI:", (diff_mu-1.96*diff_se, diff_mu+1.96*diff_se))
Control 95% CI: (67.08, 74.92)
Test 95% CI: (72.16, 87.84)
Diff 95% CI: (0.23461352820082482, 17.765386471799175)이 두 집단의 신뢰구간을 만들면 서로 겹칩니다. 온라인 집단 95% 신뢰구간의 상한은 74.92이고, 대면 집단의 하한은 72.16입니다. 하지만 두 집단 간 차이에 대한 95% 신뢰구간을 계산해 보면 0을 포함하지 않습니다. 개별 신뢰구간이 겹치더라도 차이는 여전히 0과 통계적으로 다를 수 있습니다.
앞에서 저는 온라인 집단과 대면 집단의 차이가 실제로 0이라면 이렇게 극단적인 값을 관측할 확률이 5% 미만이라고 했습니다. 그런데 그 확률이 정확히 얼마인지 추정할 수 있을까요? 이렇게 극단적인 값을 관측할 가능성은 얼마나 될까요? 이제 p 값(p-value)이 나설 차례입니다!
신뢰구간과 마찬가지로(사실 대부분의 빈도주의 통계학이 그렇듯이) p 값의 정확한 정의는 무척 헷갈릴 수 있습니다. 그래서 괜한 위험을 지지 않으려고 위키피디아의 정의를 그대로 옮겨 오겠습니다. “p 값은 귀무가설이 옳다고 가정할 때, 검정에서 실제로 관측된 결과만큼 또는 그보다 더 극단적인 검정 결과를 얻을 확률이다.”
좀 더 간단히 말하면, p 값은 귀무가설이 참이라는 조건에서 이런 데이터를 볼 확률입니다. 귀무가설이 참이라면 지금 보고 있는 측정값이 나오기가 얼마나 어려운지를 나타냅니다. 당연히 이 값은 귀무가설이 참일 확률과 자주 혼동됩니다. 둘의 차이에 주의하세요. p 값은 \(P(H_0|data)\)가 아니라 \(P(data|H_0)\)입니다.
하지만 이런 복잡함에 속지 마세요. 실제로 쓰기에는 꽤 간단합니다.
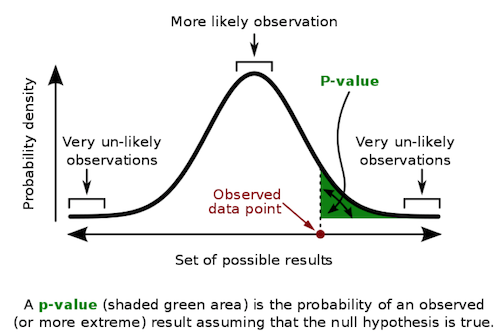
p 값을 구하려면 표준정규분포에서 z 통계량의 왼쪽이나 오른쪽 넓이를 계산해야 합니다. 다행히 이 계산은 컴퓨터가 대신해 줍니다. z 통계량을 표준정규분포의 누적분포함수에 넣기만 하면 됩니다.
print("P-value:", stats.norm.cdf(z))P-value: 0.0027239680835563383p 값이 흥미로운 점은 95%나 99% 같은 신뢰수준을 미리 정하지 않아도 된다는 것입니다. 그래도 신뢰수준을 보고하고 싶다면, p 값으로 검정이 정확히 어느 신뢰수준에서 통과하고 어디서부터 실패하는지 알 수 있습니다. 예를 들어 p 값이 0.0027이면 0.2% 수준까지 유의하다는 것을 알 수 있습니다. 그러니 차이에 대한 95% 신뢰구간과 99% 신뢰구간은 둘 다 0을 포함하지 않지만, 99.9% 신뢰구간은 0을 포함합니다. 차이가 0이라면 이렇게 극단적인 z 통계량을 관측할 확률이 0.2%밖에 되지 않는다는 뜻입니다.
p 값 0.0027은 약 0.27%이므로, 엄밀히 말하면 0.2% 수준이 아니라 0.3% 수준까지 유의하고, 이런 z 통계량을 관측할 확률도 약 0.27%입니다. 본문의 0.2%는 원문 그대로 옮겼습니다.
diff_mu = online.mean() - face_to_face.mean()
diff_se = np.sqrt(face_to_face.var()/len(face_to_face) + online.var()/len(online))
print("95% CI:", (diff_mu - stats.norm.ppf(.975)*diff_se, diff_mu + stats.norm.ppf(.975)*diff_se))
print("99% CI:", (diff_mu - stats.norm.ppf(.995)*diff_se, diff_mu + stats.norm.ppf(.995)*diff_se))
print("99.9% CI:", (diff_mu - stats.norm.ppf(.9995)*diff_se, diff_mu + stats.norm.ppf(.9995)*diff_se))
95% CI: (-8.376346553082909, -1.4480964433710017)
99% CI: (-9.46485353526404, -0.3595894611898709)
99.9% CI: (-10.728040658245558, 0.9035976617916459)드무아브르의 공식을 아는 것이 얼마나 중요한지 살펴보았고, 이 공식을 이용해 추정값이 얼마나 확실한지 나타냈습니다. 구체적으로는 온라인 수업이 대면 수업보다 학업 성취도를 떨어뜨린다는 것을 알아냈고, 이 결과가 통계적으로 유의하다는 것도 확인했습니다. 이를 위해 두 집단 평균의 신뢰구간을 비교하고, 차이에 대한 신뢰구간을 살펴보고, 가설검정을 하고, p 값을 확인했습니다. 끝으로 위에서 한 것과 같은 A/B 테스트 비교를 해 주는 함수 하나로 모든 과정을 정리해 보겠습니다.
def AB_test(test: pd.Series, control: pd.Series, confidence=0.95, h0=0):
    mu1, mu2 = test.mean(), control.mean()
    se1, se2 = test.std() / np.sqrt(len(test)), control.std() / np.sqrt(len(control))

    diff = mu1 - mu2
    se_diff = np.sqrt(test.var()/len(test) + control.var()/len(control))

    z_stats = (diff-h0)/se_diff
    p_value = stats.norm.cdf(z_stats)

    def critical(se): return -se*stats.norm.ppf((1 - confidence)/2)

    print(f"Test {confidence*100}% CI: {mu1} +- {critical(se1)}")
    print(f"Control {confidence*100}% CI: {mu2} +- {critical(se2)}")
    print(f"Test-Control {confidence*100}% CI: {diff} +- {critical(se_diff)}")
    print(f"Z Statistic {z_stats}")
    print(f"P-Value {p_value}")

AB_test(online, face_to_face)
Test 95.0% CI: 73.63526308510637 +- 3.0127770572134565
Control 95.0% CI: 78.54748458333333 +- 1.7097768273108005
Test-Control 95.0% CI: -4.912221498226955 +- 3.4641250548559537
Z Statistic -2.7792810791031224
P-Value 0.0027239680835563383함수를 충분히 일반적으로 만들었기 때문에 다른 귀무가설도 검정할 수 있습니다. 예를 들어 온라인 수업과 대면 수업의 성적 차이가 -1이라는 가설을 기각할 수 있을까요? 결과를 보면 95% 신뢰도로는 차이가 -1과 유의하게 다르다고 말할 수 있습니다. 하지만 99% 신뢰도로는 그렇게 말할 수 없습니다.
AB_test(online, face_to_face, h0=-1)Test 95.0% CI: 73.63526308510637 +- 3.0127770572134565
Control 95.0% CI: 78.54748458333333 +- 1.7097768273108005
Test-Control 95.0% CI: -4.912221498226955 +- 3.4641250548559537
Z Statistic -2.2134920404560883
P-Value 0.013431870694630114저는 이 책 전체를 Joshua Angrist, Alberto Abadie, Christopher Walters의 훌륭한 계량경제학 강의에 바치는 헌사라고 생각합니다. 이 책에 담긴 아이디어 대부분은 이들이 미국경제학회(American Economic Association)에서 한 강의에서 가져왔습니다. 힘든 2020년을 버틸 수 있는 것도 이 강의들을 보는 덕분입니다. * Cross-Section Econometrics * Mastering Mostly Harmless Econometrics
Angrist의 멋진 책들도 참고 자료로 소개하고 싶습니다. 이 책들 덕분에 계량경제학, 이들 표현으로는 ’Metrics가 아주 유용할 뿐 아니라 무척 재미있다는 것을 알게 되었습니다.
마지막 참고 자료는 Miguel Hernan과 Jamie Robins의 책입니다. 까다로운 인과적 질문에 답해야 할 때마다 믿음직한 동반자가 되어 주었습니다.
이 장에서 사용한 데이터는 다음 연구에서 가져왔습니다. Alpert, William T., Kenneth A. Couch, and Oskar R. Harmon. 2016. “A Randomized Assessment of Online Learning”. American Economic Review, 106 (5): 378-82.
Causal Inference for the Brave and True는 과학의 통계학이라 할 수 있는 인과추론을 다루는 오픈소스 자료입니다. 파이썬 기반의 무료 소프트웨어만 사용하며, 돈이 없어도, 배경지식이 많지 않아도 누구나 볼 수 있는 자료를 목표로 합니다. 이 책이 도움이 되었고 후원하고 싶다면 Patreon을 방문해 주세요. 금전적으로 기여하기 어렵다면 오타를 고치거나, 수정할 부분을 제안하거나, 이해하기 어려웠던 부분에 의견을 주는 것으로도 도울 수 있습니다. 책의 저장소에서 이슈를 열어 주세요. 마지막으로 이 내용이 마음에 들었다면 도움이 될 만한 사람들과 공유하고 GitHub에서 스타를 눌러 주세요.
한국어판의 오역이나 오탈자는 한국어판 이슈 페이지에 알려 주세요. 한국어판이 도움이 되었다면 한국어판 저장소에도 스타를 부탁드립니다.
의견 나누기
번역이 어색한 곳, 더 쉬운 설명, 궁금한 점을 남겨 주세요. GitHub 계정으로 로그인하면 댓글을 달 수 있고, 남긴 의견은 GitHub Discussions에 장별로 모입니다.