지금까지 보았듯이 회귀분석은 실험군과 대조군을 비교할 때 추가 변수를 통제하는 일을 놀라울 만큼 잘 해냅니다. 독립성 \((Y_0, Y_1)\perp T | X\)가 성립하면, 회귀분석은 X를 통제해서 평균 처치효과(ATE)를 식별할 수 있습니다. 회귀분석이 이 일을 해내는 방식은 마법처럼 보이기도 합니다. 감을 잡기 위해 모든 변수 X가 더미변수인 경우를 다시 떠올려 봅시다. 이때 회귀분석은 데이터를 더미 셀로 나누고 셀마다 실험군과 대조군의 평균 차이를 계산합니다. X 더미가 고정된 셀 안에서 계산하므로 이 평균 차이는 X를 일정하게 유지한 값입니다. 마치 \(E[Y|T=1] - E[Y|T=0] | X=x\)를 계산하는 것과 같습니다. 여기서 \(x\)는 하나의 더미 셀(예를 들어 모든 더미가 1인 셀)입니다. 그다음 회귀분석은 각 셀의 추정값을 합쳐 최종 ATE를 만듭니다. 이때 각 셀에는 그 그룹 안에서 처치가 갖는 분산에 비례하는 가중치를 줍니다.
코드
import warningswarnings.filterwarnings('ignore')import pandas as pdimport numpy as npfrom matplotlib import stylefrom matplotlib import pyplot as pltimport statsmodels.formula.api as smfimport graphviz as gr%matplotlib inlinestyle.use("fivethirtyeight")
예를 들어 어떤 약물의 효과를 추정하려는데 남성 6명과 여성 4명이 있다고 합시다. 결과변수는 입원 일수이고, 약물이 입원 일수를 줄여 주기를 기대합니다. 남성에게 약물의 실제 인과효과는 -3입니다. 즉, 약물이 입원 기간을 3일 줄입니다. 여성에게는 -2입니다. 상황을 좀 더 흥미롭게 만들어 보겠습니다. 남성은 이 질병의 영향을 훨씬 크게 받아 병원에 더 오래 머뭅니다. 약물을 투여받는 비율도 훨씬 높습니다. 남성 6명 중 약물을 투여받지 않은 사람은 1명뿐입니다. 반면 여성은 이 질병에 더 강해서 병원에 덜 머뭅니다. 여성은 50%가 약물을 투여받습니다.
실험군과 대조군을 단순 비교하면 약물에 불리한 쪽으로 편향된 효과가 나온다는 점에 주목하세요. 즉, 약물이 실제보다 덜 효과적으로 보입니다. 성별이라는 교란 요인(confounder)을 빠뜨렸으니 예상할 수 있는 결과입니다. 이 경우 남성이 약물을 더 많이 투여받고 질병의 영향도 더 크게 받기 때문에, 추정된 ATE의 크기가 실제보다 작습니다.
이 추정값은 1) 데이터를 교란 요인 셀(여기서는 남성과 여성)로 나누고, 2) 셀마다 효과를 추정한 뒤, 3) 셀, 즉 공변량 그룹의 표본 크기를 가중치로 삼아 추정값을 가중 평균해서 구합니다. 데이터에 남성과 여성이 정확히 같은 수만큼 있었다면 ATE 추정값은 두 그룹 ATE의 한가운데인 -2.5가 됐을 것입니다. 이 데이터셋에는 남성이 여성보다 많으므로 ATE 추정값이 남성의 ATE 쪽에 조금 더 가깝습니다. 데이터 생성 과정에 아무런 가정도 두지 않으므로 이를 비모수 추정값(non-parametric estimate)이라고 합니다.
회귀분석으로 성별을 통제하면 선형성 가정이 더해집니다. 회귀분석도 데이터를 남성과 여성으로 나누고 두 그룹 각각에서 효과를 추정합니다. 여기까지는 좋습니다. 하지만 그룹별 효과를 합칠 때는 표본 크기만으로 가중치를 주지 않습니다. 대신 그룹 안에서 처치가 갖는 분산에도 비례하는 가중치를 씁니다. 이 예에서는 대조군에 속한 남성이 한 명뿐이므로 남성의 처치 분산이 여성보다 작습니다. 정확히는 남성의 T 분산이 \(0.139=1/6*(1 - 1/6)\)이고 여성은 \(0.25=2/4*(1 - 2/4)\)입니다. 따라서 이 예에서 회귀분석은 여성에게 더 큰 가중치를 주고, ATE는 여성의 ATE인 -2에 조금 더 가까워집니다.
코드
smf.ols('days ~ drug + C(sex)', data=drug_example).fit().summary().tables[1]
coef
std err
t
P>|t|
[0.025
0.975]
Intercept
7.5455
0.188
40.093
0.000
7.100
7.990
C(sex)[T.W]
-3.3182
0.176
-18.849
0.000
-3.734
-2.902
drug
-2.4545
0.188
-13.042
0.000
-2.900
-2.010
이 결과는 더미변수일 때 더 직관적이지만, 회귀분석은 나름의 기묘한 방식으로 연속 변수도 일정하게 유지하면서 효과를 추정합니다. 연속 변수에서도 ATE는 공변량의 분산이 더 큰 쪽으로 기웁니다.
이처럼 회귀분석에는 고유한 특성이 있습니다. 선형적이고, 모수적이며, 분산이 큰 특성을 좋아합니다… 이는 맥락에 따라 장점이 될 수도, 단점이 될 수도 있습니다. 그래서 교란 요인을 통제하는 다른 기법도 알아 두는 것이 중요합니다. 인과추론 공구 벨트에 연장이 하나 더 생길 뿐 아니라, 교란을 다루는 여러 방법을 이해하면 문제 자체를 더 깊이 이해하게 됩니다. 그런 의미에서 이제 층화 추정량(Subclassification Estimator)을 소개합니다!
층화 추정량
직업 훈련이 소득에 미치는 효과처럼 추정하고 싶은 인과효과가 있고, 게다가 처치가 무작위로 배정되지 않았다면 교란 요인을 조심해야 합니다. 동기가 강한 사람들만 훈련을 받았고, 이들은 훈련과 상관없이 소득이 더 높았을 수도 있습니다. 따라서 동기 수준과 그 밖의 교란 요인이 대략 같은 사람들로 이루어진 작은 그룹 안에서 훈련 프로그램의 효과를 추정해야 합니다.
더 일반적으로 말하면, 추정하고 싶은 인과효과가 있는데 변수 X의 교란 때문에 추정이 어렵다면, X가 같은 작은 그룹 안에서 실험군과 대조군을 비교해야 합니다. 조건부 독립성 \((Y_0, Y_1)\perp T | X\)가 성립하면 ATE를 다음과 같이 쓸 수 있습니다.
\[
ATE = \int(E[Y|X, T=1] - E[Y|X, T=0])dP(x)
\]
이 적분은 특성 X의 분포 공간 전체를 훑으면서 아주 작은 공간마다 평균 차이를 계산하고, 이를 모두 합쳐 ATE를 만듭니다. 이산적인 특성 집합을 떠올리면 다른 방식으로도 볼 수 있습니다. 이 경우 특성 X가 K개의 서로 다른 셀 \(\{X_1, X_2, ..., X_k\}\) 중 하나의 값을 가진다고 할 수 있습니다. 그러면 할 일은 셀마다 처치효과를 계산해 ATE로 합치는 것입니다. 이 이산적인 경우에 적분을 합으로 바꾸면 층화 추정량을 유도할 수 있습니다.
여기서 막대는 셀 k에서 실험군 결과 \(Y_{k1}\)과 대조군 결과 \(Y_{k0}\)의 평균을 뜻하고, \(N_{k}\)는 같은 셀의 관측값 수입니다. 보다시피 셀마다 국지적인 ATE를 계산하고, 셀의 표본 크기를 가중치로 하는 가중 평균으로 이를 합칩니다. 앞의 약물 예에서는 이것이 첫 번째 추정 방식이었고, 그 결과는 −2.6이었습니다.
매칭 추정량
층화 추정량은 실무에서 잘 쓰이지 않습니다(이유는 곧 보겠지만 차원의 저주 때문입니다). 그래도 인과추론 추정량이 무엇을 해야 하고 교란 요인을 어떻게 통제해야 하는지 직관을 얻기에는 좋습니다. 덕분에 매칭 추정량(Matching Estimator) 같은 다른 추정량도 살펴볼 수 있습니다.
아이디어는 아주 비슷합니다. 어떤 교란 요인 X 때문에 실험군과 대조군을 처음부터 비교할 수 없다면, 각 실험군 대상을 비슷한 대조군 대상과 짝지어 비교할 수 있게 만들면 됩니다. 실험군 대상마다 처치받지 않은 쌍둥이를 찾아 주는 셈입니다. 이렇게 짝을 지어 놓으면 실험군과 대조군을 다시 견줄 수 있게 됩니다.
예를 들어 연수 프로그램이 소득에 미치는 효과를 추정한다고 합시다. 연수생 데이터는 다음과 같습니다.
하지만 위 표를 보면 연수생이 비연수생보다 훨씬 젊습니다. 나이가 교란 요인일 가능성이 크다는 뜻입니다. 나이로 매칭해서 이를 바로잡아 봅시다. 실험군의 1번 대상(unit 1)은 27번 대상과 짝짓습니다. 둘 다 28세이기 때문입니다. 2번은 34번과, 3번은 37번과, 4번은 35번과 짝짓습니다… 5번 차례가 되면 대조군에서 29세인 사람을 찾아야 하는데, 그 사람은 이미 짝이 정해진 37번입니다. 같은 대상을 여러 번 써도 되므로 문제가 되지 않습니다. 짝이 될 수 있는 대상이 둘 이상이면 그중에서 무작위로 고르면 됩니다.
처음 7개 대상을 매칭한 데이터셋은 다음과 같습니다.
코드
# make dataset where no one has the same ageunique_on_age = (trainee .query("trainees==0") .drop_duplicates("age"))matches = (trainee .query("trainees==1") .merge(unique_on_age, on="age", how="left", suffixes=("_t_1", "_t_0")) .assign(t1_minuts_t0 =lambda d: d["earnings_t_1"] - d["earnings_t_0"]))matches.head(7)
unit_t_1
trainees_t_1
age
earnings_t_1
unit_t_0
trainees_t_0
earnings_t_0
t1_minuts_t0
0
1
1
28
17700
27
0
8800
8900
1
2
1
34
10200
34
0
24200
-14000
2
3
1
29
14400
37
0
6200
8200
3
4
1
25
20800
35
0
23300
-2500
4
5
1
29
6100
37
0
6200
-100
5
6
1
23
28600
40
0
9500
19100
6
7
1
33
21900
29
0
15500
6400
마지막 열에는 실험군 대상과 그 짝인 대조군 대상의 소득 차이가 들어 있습니다. 이 열의 평균을 구하면 나이를 통제한 실험군에 대한 평균 처치효과(ATET) 추정값을 얻습니다. 단순 평균 차이를 썼던 앞의 추정값과 달리 이번 추정값은 크게 양수라는 점에 주목하세요.
힌트옮긴이
ATET는 『실무로 통하는 인과추론 with 파이썬』과 이 책의 다른 장에서 ATT로 표기하는 실험군에 대한 평균 처치효과와 같습니다.
코드
matches["t1_minuts_t0"].mean()
2457.8947368421054
하지만 이는 매칭을 소개하려고 만든 아주 인위적인 예입니다. 현실에서는 보통 특성이 여러 개이고, 대상끼리 완벽하게 일치하지도 않습니다. 이럴 때는 대상끼리 얼마나 가까운지 비교할 근접성 척도를 정해야 합니다. 흔히 쓰는 척도는 유클리드 노름(euclidean norm) \(||X_i - X_j||\)입니다. 그런데 이 거리는 특성의 스케일에 따라 값이 달라집니다. 즉, 노름을 계산할 때 수십 단위의 값을 갖는 나이 같은 특성은 수천 단위의 값을 갖는 소득 같은 특성보다 훨씬 덜 중요해집니다. 그래서 노름을 적용하기 전에 특성들의 스케일을 대략 비슷하게 맞춰야 합니다.
거리 척도를 정했으니 이제 매칭하려는 표본의 최근접 이웃(nearest neighbour)을 짝으로 정할 수 있습니다. 수식으로는 매칭 추정량을 다음과 같이 쓸 수 있습니다.
이 편향을 바로잡기 위해 매칭으로 X를 통제하겠습니다. 먼저 특성의 스케일을 맞춰야 한다는 점을 잊지 마세요. 그렇지 않으면 관측값 사이의 거리를 계산할 때 나이 같은 특성이 중증도 같은 특성보다 더 큰 비중을 갖게 됩니다. 이를 위해 특성을 표준화하겠습니다.
코드
# scale featuresX = ["severity", "age", "sex"]y ="recovery"med = med.assign(**{f: (med[f] - med[f].mean())/med[f].std() for f in X})med.head()
sex
age
severity
medication
recovery
0
-0.996980
0.280787
1.459800
1
31
1
1.002979
0.865375
1.502164
1
49
2
1.002979
-0.338749
0.057796
0
38
3
1.002979
0.399465
-0.512557
0
35
4
-0.996980
-0.610473
-0.911125
0
15
이제 매칭 자체로 넘어가 봅시다. 매칭 함수를 직접 짜는 대신 Sklearn의 K 최근접 이웃 알고리즘을 쓰겠습니다. 이 알고리즘은 추정용 데이터, 즉 훈련 셋에서 가장 가까운 데이터 포인트를 찾아 예측합니다.
매칭에는 이런 모델이 2개 필요합니다. 하나인 mt0는 대조군 데이터를 저장해 두었다가 요청하면 대조군에서 짝을 찾습니다. 다른 하나인 mt1은 실험군 데이터를 저장해 두었다가 요청하면 실험군에서 짝을 찾습니다. 이렇게 적합한 뒤 KNN 모델로 예측하면, 그 예측값이 바로 짝이 됩니다.
코드
from sklearn.neighbors import KNeighborsRegressortreated = med.query("medication==1")untreated = med.query("medication==0")mt0 = KNeighborsRegressor(n_neighbors=1).fit(untreated[X], untreated[y])mt1 = KNeighborsRegressor(n_neighbors=1).fit(treated[X], treated[y])predicted = pd.concat([# find matches for the treated looking at the untreated knn model treated.assign(match=mt0.predict(treated[X])),# find matches for the untreated looking at the treated knn model untreated.assign(match=mt1.predict(untreated[X]))])predicted.head()
그런데 \(\mu_0(X_i) - \mu_0(X_j(i))\)는 한눈에 이해하기 쉽지 않으니 자세히 들여다보겠습니다. \(\mu_0(X_i)\)는 실험군 대상 \(i\)가 처치받지 않았다면 얻었을 결과 Y 값입니다. 즉, 대상 i의 반사실적 결과 \(Y_0\)입니다. \(\mu_0(X_j(i))\)는 대상 \(i\)와 짝지은 대조군 대상 \(j\)의 결과입니다. 따라서 이것도 \(Y_0\)이지만, 이번에는 대상 \(j\)의 값입니다. 다만 \(j\)는 대조군에 속하므로 이 값은 사실적 결과입니다. 그런데 \(j\)와 \(i\)는 비슷할 뿐 같지는 않으므로 이 차이는 0이 아닐 가능성이 큽니다. 다시 말해 \(X_i \approx X_j\)일 뿐이고, 따라서 \(Y_{0i} \approx Y_{0j}\)일 뿐입니다.
표본 크기가 커지면 짝지을 대상이 많아지므로 대상 \(i\)와 그 짝 \(j\)의 차이도 줄어듭니다. 하지만 이 차이는 천천히 0으로 수렴합니다. 그 결과 \(\sqrt{N_1}\)이 커지는 속도가 \((\mu_0(X_i) - \mu_0(X_j(i)))\)가 줄어드는 속도보다 빨라서, \(E[\sqrt{N_1}(\mu_0(X_i) - \mu_0(X_j(i)))]\)가 0으로 수렴하지 않을 수 있습니다.
편향은 매칭 불일치(matching discrepancy)가 클 때 생깁니다. 다행히 이를 바로잡는 방법이 있습니다. 관측값마다 편향에 \((\mu_0(X_i) - \mu_0(X_j(i)))\)만큼 기여하므로, 추정량의 매칭 비교마다 이 양을 빼 주기만 하면 됩니다. 이를 위해 \(\mu_0(X_j(i))\)를 선형회귀 같은 모델로 구한 추정값 \(\hat{\mu_0}(X_j(i))\)로 바꿀 수 있습니다. 그러면 ATET 추정량은 다음과 같이 바뀝니다.
여기서 \(\hat{\mu_0}(x)\)는 대조군 표본만으로 적합한 선형회귀처럼 \(E[Y|X, T=0]\)를 추정한 값입니다.
코드
from sklearn.linear_model import LinearRegression# fit the linear regression model to estimate mu_0(x)ols0 = LinearRegression().fit(untreated[X], untreated[y])ols1 = LinearRegression().fit(treated[X], treated[y])# find the units that match to the treatedtreated_match_index = mt0.kneighbors(treated[X], n_neighbors=1)[1].ravel()# find the units that match to the untreatduntreated_match_index = mt1.kneighbors(untreated[X], n_neighbors=1)[1].ravel()predicted = pd.concat([ (treated# find the Y match on the other group .assign(match=mt0.predict(treated[X])) # build the bias correction term .assign(bias_correct=ols0.predict(treated[X]) - ols0.predict(untreated.iloc[treated_match_index][X]))), (untreated .assign(match=mt1.predict(untreated[X])) .assign(bias_correct=ols1.predict(untreated[X]) - ols1.predict(treated.iloc[untreated_match_index][X])))])predicted.head()
sex
age
severity
medication
recovery
match
bias_correct
0
-0.996980
0.280787
1.459800
1
31
39.0
4.404034
1
1.002979
0.865375
1.502164
1
49
52.0
12.915348
7
-0.996980
1.495134
1.268540
1
38
46.0
1.871428
10
1.002979
-0.106534
0.545911
1
34
45.0
-0.496970
16
-0.996980
0.043034
1.428732
1
30
39.0
2.610159
곧바로 떠오르는 질문이 하나 있습니다. 이러면 매칭을 하는 의미가 없지 않을까요? 어차피 선형회귀를 돌려야 한다면, 이렇게 복잡한 모델 대신 선형회귀만 쓰면 되지 않을까요? 타당한 지적이니 시간을 들여 답해 보겠습니다.
첫째, 여기서 적합하는 선형회귀는 처치효과를 구하려고 처치 차원으로 외삽하지 않습니다. 이 회귀의 목적은 편향을 바로잡는 것뿐입니다. 실험군이 대조군처럼 생겼다면 어땠을지 알아내려 하지 않는다는 의미에서, 이 선형회귀는 국지적입니다. 그런 외삽은 전혀 하지 않고 매칭에 맡깁니다. 추정량의 핵심은 여전히 매칭 부분입니다. 여기서 말하고 싶은 요점은, 이 추정량에서 OLS는 부차적이라는 것입니다.
둘째, 매칭은 비모수 추정량입니다. 선형성이나 어떤 모수적 모델도 가정하지 않습니다. 그래서 선형회귀보다 유연하고, 선형회귀가 통하지 않는 상황, 즉 비선형성이 아주 강한 상황에서도 쓸 수 있습니다.
그렇다면 매칭만 써야 할까요? 음, 어려운 질문입니다. 알베르토 아바디(Alberto Abadie)는 그래야 한다고 주장합니다. 더 유연하고, 코드만 갖춰 두면 실행하기도 똑같이 쉽다는 것입니다. 저는 완전히 동의하지는 않습니다. 우선 아바디는 이 추정량을 연구하고 발전시키는 데 많은 시간을 쏟았으니(그렇습니다, 매칭을 지금의 모습으로 만든 학자 중 한 명이 바로 그입니다) 이 방법에 개인적인 이해관계가 있을 수밖에 없습니다. 다음으로, 선형회귀에는 매칭에서 찾아볼 수 없는 단순함이 있습니다. “다른 모든 것을 일정하게 유지한다”는 편미분의 수학은 매칭보다 선형회귀로 훨씬 쉽게 이해할 수 있습니다. 하지만 이건 제 취향일 뿐입니다. 솔직히 이 질문에 명확한 답은 없습니다. 아무튼 예제로 돌아갑시다.
Treatment Effect Estimates: Matching

                     Est.       S.e.          z      P>|z|      [95% Conf. int.]
--------------------------------------------------------------------------------
           ATE     -7.709      0.609    -12.649      0.000     -8.903     -6.514
           ATC     -6.665      0.246    -27.047      0.000     -7.148     -6.182
           ATT     -9.679      1.693     -5.717      0.000    -12.997     -6.361
마침내 이 약이 실제로 입원 기간을 줄인다고 자신 있게 말할 수 있습니다. ATE 추정값이 제가 직접 구한 값보다 조금 낮은데, 이는 sklearn의 KNN 구현과 causalinference 파이썬 패키지가 거리가 같은 후보가 여럿일 때 짝을 고르는 방식이 서로 다르기 때문입니다.
이 주제를 마무리하기 전에 매칭에서 편향이 생기는 원인을 조금 더 짚고 넘어가겠습니다. 앞에서 대상과 그 짝이 별로 비슷하지 않으면 매칭에 편향이 생긴다는 것을 보았습니다. 그렇다면 무엇 때문에 둘이 그렇게 달라질까요?
차원의 저주
알고 보면 답은 아주 간단하고 직관적입니다. 성별처럼 특성이 몇 개뿐이면 그 특성이 일치하는 사람을 쉽게 찾을 수 있습니다. 하지만 나이, 소득, 출생 도시 같은 특성을 더할수록 짝을 찾기가 점점 어려워집니다. 일반화하면, 특성이 많을수록 대상과 그 짝 사이의 거리가 멀어집니다.
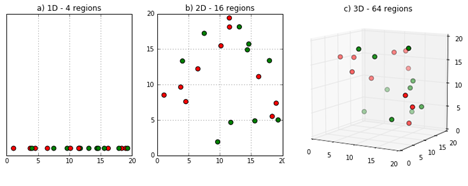
이 문제는 매칭 추정량에만 해당하지 않습니다. 앞에서 본 층화 추정량과도 이어집니다. 앞서 남성과 여성으로 나눈 인위적인 약물 예에서는 층화 추정량을 만들기가 아주 쉬웠습니다. 셀이 남성과 여성 2개뿐이었기 때문입니다. 셀이 더 많다면 어떻게 될까요? 나이와 소득 같은 연속형 특성이 2개 있고, 각각을 5개 구간으로 이산화했다고 합시다. 그러면 셀은 25개, 즉 \(5^2\)개가 됩니다. 구간이 3개씩인 공변량이 10개라면 어떨까요? 별로 많아 보이지 않죠? 그런데 셀이 59049개, 즉 \(3^{10}\)개가 됩니다. 셀 수가 얼마나 빨리 걷잡을 수 없이 불어나는지 쉽게 알 수 있습니다. 데이터 과학 전반에서 나타나는 이 현상을 차원의 저주(The Curse of Dimensionality)라고 합니다!!!
이미지 출처: https://deepai.org/machine-learning-glossary-and-terms/curse-of-dimensionality
이름은 무섭고 거창하지만 뜻은 단순합니다. 특성 공간을 채우는 데 필요한 데이터 포인트 수가 특성, 즉 차원의 수에 따라 기하급수적으로 늘어난다는 것입니다. 예를 들어 특성 3개로 이루어진 공간을 채우는 데 데이터 포인트 X개가 필요하다면, 특성 4개로 이루어진 공간을 채우려면 기하급수적으로 더 많은 포인트가 필요합니다.
층화 추정량의 맥락에서 차원의 저주는 특성이 많으면 추정량이 제 역할을 못 한다는 뜻입니다. 특성이 많으면 X의 셀도 많아집니다. 셀이 많으면 그중 일부에는 데이터가 아주 적습니다. 실험군만 있거나 대조군만 있는 셀도 생길 수 있는데, 그런 셀에서는 ATE를 추정할 수 없으니 추정량이 망가집니다. 매칭의 맥락에서는 특성 공간이 매우 희소해져 대상끼리 서로 아주 멀리 떨어진다는 뜻입니다. 그러면 짝 사이의 거리가 멀어지고 편향 문제가 생깁니다.
선형회귀는 오히려 이 문제를 꽤 잘 다룹니다. 모든 특성 X를 하나의 차원, 즉 Y 차원으로 투영한 뒤 그 투영 위에서 실험군과 대조군을 비교합니다. 어떤 의미에서 선형회귀는 ATE를 추정하려고 일종의 차원 축소를 하는 셈입니다. 꽤 우아한 방식입니다.
대부분의 인과 모델에도 차원의 저주에 대처하는 나름의 방법이 있습니다. 매번 반복해서 말하지는 않겠지만, 이런 모델을 볼 때 염두에 두면 좋습니다. 예를 들어 다음 장에서 성향점수를 다룰 때, 성향점수가 이 문제를 어떻게 해결하는지 살펴보세요.
핵심 요약
이 장은 선형회귀가 무엇을 하는지, 그리고 인과관계를 식별하는 데 어떻게 도움이 되는지 이해하는 데서 출발했습니다. 정리하면, 회귀분석은 데이터셋을 셀로 나누고 셀마다 ATE를 계산한 다음, 셀별 ATE를 합쳐 데이터셋 전체의 ATE 하나를 만드는 과정으로 볼 수 있습니다.
여기서 출발해 층화를 이용한 아주 일반적인 인과추론 추정량을 유도했습니다. 이 추정량은 실무에서 그다지 쓸모가 없지만, 인과추론 추정 문제에 어떻게 접근할지 흥미로운 통찰을 주었습니다. 그 덕분에 매칭 추정량을 이야기할 기회도 생겼습니다.
매칭은 실험군 대상마다 아주 비슷한 대조군 짝을 찾고, 대조군 대상에도 같은 방식으로 짝을 찾아 교란 요인을 통제합니다. 이를 KNN 알고리즘으로 구현하는 법과 회귀분석으로 편향을 제거하는 법을 살펴보았습니다. 이어서 매칭과 선형회귀의 차이를 논의했습니다. 매칭은 선형회귀와 달리 선형성에 기대지 않는 비모수 추정량이라는 점을 확인했습니다.
마지막으로 고차원 데이터셋의 문제를 깊이 살펴보고, 인과추론 방법들이 이 문제로 어떤 어려움을 겪는지 보았습니다.
참고 자료
저는 이 책 전체를 Joshua Angrist, Alberto Abadie, Christopher Walters의 훌륭한 계량경제학 강의에 바치는 헌사라고 생각합니다. 이 책에 담긴 아이디어 대부분은 이들이 미국경제학회(American Economic Association)에서 한 강의에서 가져왔습니다. 힘든 2020년을 버틸 수 있는 것도 이 강의들을 보는 덕분입니다. * Cross-Section Econometrics * Mastering Mostly Harmless Econometrics
Angrist의 멋진 책들도 참고 자료로 소개하고 싶습니다. 이 책들 덕분에 계량경제학, 이들 표현으로는 ’Metrics가 아주 유용할 뿐 아니라 무척 재미있다는 것을 알게 되었습니다.
Causal Inference for the Brave and True는 과학의 통계학이라 할 수 있는 인과추론을 다루는 오픈소스 자료입니다. 파이썬 기반의 무료 소프트웨어만 사용하며, 돈이 없어도, 배경지식이 많지 않아도 누구나 볼 수 있는 자료를 목표로 합니다. 이 책이 도움이 되었고 후원하고 싶다면 Patreon을 방문해 주세요. 금전적으로 기여하기 어렵다면 오타를 고치거나, 수정할 부분을 제안하거나, 이해하기 어려웠던 부분에 의견을 주는 것으로도 도울 수 있습니다. 책의 저장소에서 이슈를 열어 주세요. 마지막으로 이 내용이 마음에 들었다면 도움이 될 만한 사람들과 공유하고 GitHub에서 스타를 눌러 주세요.
의견 나누기
번역이 어색한 곳, 더 쉬운 설명, 궁금한 점을 남겨 주세요. GitHub 계정으로 로그인하면 댓글을 달 수 있고, 남긴 의견은 GitHub Discussions에 장별로 모입니다.