무엇보다 먼저 이런 궁금증이 들 겁니다. ‘이걸 배우면 나한테 뭐가 좋은데?’ 답은 이렇습니다.
데이터 과학은 예전과 다릅니다(어쩌면 이제야 제 모습을 찾았습니다)
하버드 비즈니스 리뷰(Harvard Business Review)는 데이터 과학자를 21세기 가장 섹시한 직업이라고 불렀습니다. 빈말이 아니었습니다. 지난 10년 동안 데이터 과학자는 줄곧 스포트라이트를 받았습니다. AI 전문가들은 스포츠 슈퍼스타에 버금가는 연봉을 받았습니다. 명성과 부를 좇아 수많은 젊은 인재가 데이터 과학자라는 직함을 하루라도 빨리 얻으려고 광풍 같은 골드러시에 뛰어들었습니다. 이 열풍을 타고 완전히 새로운 산업들이 생겨났습니다. 수학 공식 하나 보여주지 않고도 데이터 과학자로 만들어 주겠다는 기적의 교수법이 등장했고, 컨설팅 전문가들은 회사가 데이터의 잠재력을 끌어내기만 하면 수백만 달러를 벌 수 있다고 약속했습니다. AI, 즉 머신러닝은 새로운 전기로, 데이터는 새로운 석유로 불렸습니다.
그동안 경제학자들은 교육이 소득에 미치는 진짜 영향이 무엇인지 답하려 했고, 생물통계학자들은 포화지방이 심장마비 위험을 높이는지 알아내려 했으며, 심리학자들은 다정한 말 한마디가 정말로 결혼 생활을 더 행복하게 만드는지 밝히려 했습니다. 그런데 정작 우리는 처음부터 줄곧 데이터로 ‘구식’ 과학을 해 온 이들을 잊고 있었습니다. 솔직히 말하면 데이터 과학은 새로 생긴 분야가 아닙니다. 언론이 엄청난 공짜 홍보를 쏟아부은 덕분에 이제야 사람들이 알아보게 되었을 뿐입니다.
Jim Collins의 비유를 빌려 보겠습니다. 가장 좋아하는 맥주를 얼음처럼 차갑게 한 잔 따른다고 상상해 보세요. 제대로 따르면 잔은 대부분 맥주로 채워지고, 맨 위에는 손가락 하나 두께의 거품이 덮입니다. 이 잔이 바로 데이터 과학입니다.
맥주. 통계적 기초, 과학적 호기심, 복잡한 문제를 향한 열정입니다. 모두 수백 년에 걸쳐 가치를 증명해 온 것들입니다.
거품. 이 폭신한 부분은 결국 사라질 비현실적인 기대 위에 쌓여 있습니다.
이 거품은 생각보다 훨씬 빨리 꺼질지도 모릅니다. 『이코노미스트(The Economist)』는 이렇게 말합니다.
AI가 세상을 뒤바꿀 것이라고 예측하는 바로 그 컨설턴트들조차, 실제 기업의 실제 관리자들은 AI를 도입하기 어려워하고 있으며 AI를 향한 열기도 식어 가고 있다고 보고합니다. 리서치 회사 가트너(Gartner)의 Svetlana Sicular는 2020년이 가트너의 그 유명한 ’하이프 사이클’에서 AI가 내리막길로 접어드는 해가 될 수 있다고 말합니다. 투자자들도 너도나도 유행에 올라타는 현상에 눈뜨기 시작했습니다. 벤처캐피털 펀드 MMC가 유럽의 AI 스타트업을 조사해 보니, 40%는 AI를 전혀 쓰지 않는 것으로 보였습니다.
이 모든 광풍 속에서 데이터 과학자로서, 아니 더 나아가 ‘그냥’ 과학자로서 무엇을 해야 할까요? 현명하다면 우선 거품을 무시하는 법부터 배울 겁니다. 우리가 원하는 건 맥주입니다. 수학과 통계학은 언제나 쓸모가 있었고, 이제 와서 그 쓸모가 사라질 리도 없습니다. 둘째, 아무도 제대로 쓸 줄 모르는 반짝이는 최신 도구 말고, 여러분의 일을 가치 있게 만드는 것이 무엇인지 배우세요.
마지막으로 꼭 기억할 점은 지름길이 없다는 사실입니다. 수학과 통계학 지식이 가치 있는 이유는 바로 익히기 어렵기 때문입니다. 누구나 할 수 있다면 공급이 넘쳐서 그 값어치가 떨어질 테니까요. 그러니 독하게 마음먹으세요! 할 수 있는 한 제대로 배우세요. 그리고 기왕 하는 거, 즐기지 못할 이유도 없지 않을까요? 오직 용감하고 진실한 자들을 위한 이 모험에 함께 나서며 재미도 놓치지 맙시다.
다른 종류의 질문에 답하기
머신러닝은 지금 예측 유형의 질문에 답하는 데 아주 뛰어납니다. Ajay Agrawal, Joshua Gans, Avi Goldfarb는 『예측 기계(Prediction Machines)』에서 “새로운 인공지능의 물결이 실제로 가져다주는 것은 지능이 아니라 지능의 핵심 요소인 예측입니다”라고 말합니다. 머신러닝으로 온갖 멋진 일을 할 수 있습니다. 조건은 단 하나, 문제를 예측 문제로 정의하는 것입니다. 영어를 포르투갈어로 번역하고 싶나요? 그렇다면 영어 문장이 주어졌을 때 포르투갈어 문장을 예측하는 ML 모델을 만들면 됩니다. 얼굴을 인식하고 싶나요? 그렇다면 사진의 일부 영역에 얼굴이 있는지 예측하는 ML 모델을 만들면 됩니다. 자율주행차를 만들고 싶나요? 그렇다면 차 주변의 이미지와 센서 데이터가 주어졌을 때 핸들 방향과 브레이크, 가속 페달을 밟는 세기를 예측하는 ML 모델을 만들면 됩니다.
하지만 ML은 만병통치약이 아닙니다. 엄격한 경계 안에서는 놀라운 성능을 내다가도, 데이터가 모델이 익숙한 범위에서 조금만 벗어나면 처참하게 실패할 수 있습니다. 『예측 기계』에 나오는 다른 예를 들어 보겠습니다. “많은 산업에서 낮은 가격은 낮은 판매량과 연관되어 있습니다. 예를 들어 호텔 업계에서는 관광 비수기에는 가격이 낮고, 수요가 가장 많아 호텔이 꽉 차는 시기에는 가격이 높습니다. 이런 데이터만 주어지면 순진한 예측은 가격을 올릴수록 객실이 더 많이 팔린다고 말할지도 모릅니다.”
ML은 이처럼 인과의 방향을 거꾸로 읽게 되는 문제에 약하기로 악명이 높습니다. 이런 문제를 풀려면 경제학자들이 반사실(counterfactual)이라고 부르는 ‘만약에’ 질문에 답해야 합니다. 지금 내 상품에 매긴 가격 대신 다른 가격을 매기면 어떻게 될까요? 지금 하고 있는 저지방 식단 대신 저당 식단을 하면 어떻게 될까요? 은행에서 대출 업무를 한다면, 고객의 신용 한도를 바꿨을 때 수익이 어떻게 달라지는지 알아내야 합니다. 지방자치단체에서 일한다면 학교 교육을 개선할 방법을 찾아 달라는 요청을 받을 수도 있습니다. 디지털 지식의 시대라고들 하니 모든 아이에게 태블릿을 나눠 줘야 할까요? 아니면 옛날식 도서관을 지어야 할까요?
이런 질문의 핵심에는 우리가 답을 알고 싶은 인과적 물음이 있습니다. 인과적 질문은 매출을 올리는 방법을 찾는 것처럼 일상적인 문제 곳곳에 스며 있습니다. 그리고 아주 개인적이고 소중한 고민에서도 중요한 역할을 합니다. 인생에서 성공하려면 비싼 학교에 가야 할까요(교육이 소득을 높일까요)? 이민자가 늘면 내가 일자리를 구할 가능성이 낮아질까요(이민이 실업률을 높일까요)? 가난한 사람들에게 현금을 지원하면 범죄율이 낮아질까요? 어떤 분야에 있든 상관없습니다. 어떤 형태로든 인과적 질문에 답해야 했거나 앞으로 답해야 할 가능성이 매우 큽니다. ML에게는 안타까운 일이지만, 이런 질문을 풀 때는 상관관계에 기반한 예측에 기댈 수 없습니다.
이런 질문에 답하기는 대부분의 사람이 생각하는 것보다 어렵습니다. 아마 부모님께 “연관관계(association)는 인과관계(causation)가 아니다”, “연관관계는 인과관계가 아니다”라는 말을 귀에 못이 박히도록 들었을 겁니다. 하지만 왜 그런지 설명하는 일은 생각보다 조금 더 복잡합니다. 인과추론(causal inference)을 소개하는 이 장에서 다룰 내용이 바로 그것입니다. 그리고 이 책의 나머지 부분은 모두 연관관계를 인과관계로 만드는 방법을 알아내는 데 할애합니다.
연관관계가 곧 인과관계일 때
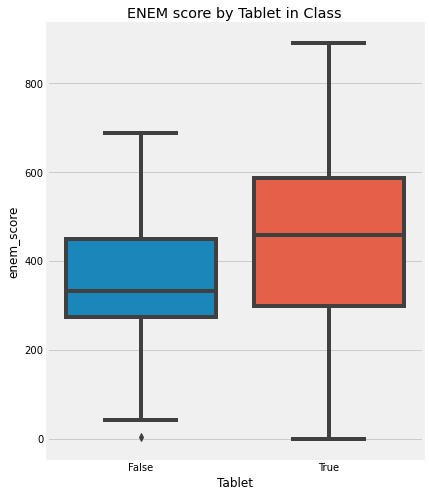
연관관계가 왜 인과관계가 아닌지는 직관적으로 어느 정도 알고 있습니다. 누군가 학생들에게 태블릿을 나눠 주는 학교가 그렇지 않은 학교보다 성적이 좋다고 말한다면, 태블릿이 있는 학교가 아마 더 부유할 것이라고 바로 지적할 수 있습니다. 그런 학교라면 태블릿이 없어도 평균보다 성적이 좋았을 겁니다. 그러니 수업 시간에 아이들에게 태블릿을 주면 학업 성취도가 올라간다고 결론 내릴 수 없습니다. 말할 수 있는 것은 학교의 태블릿이 높은 학업 성취도와 연관되어 있다는 것뿐입니다. 여기서 학업 성취도는 ENEM(브라질판 수능이라 할 수 있는 국가 고등학교 시험, National High School Exam의 약자)으로 측정했습니다.
plt.figure(figsize=(6,8))sns.boxplot(y="enem_score", x="Tablet", data=data).set_title('ENEM score by Tablet in Class')plt.show()
단순한 직관을 넘어서기 위해 먼저 표기법을 정해 두겠습니다. 이 표기법은 앞으로 인과관계를 이야기할 때 쓰는 일상 언어가 될 것입니다. 다른 용감하고 진실한 인과 전사들을 알아보는 공용어이자, 앞으로 이어질 수많은 전투에서 함께 외칠 함성이라고 생각하세요.
대상(unit) i의 처치(treatment) 여부를 \(T_i\)라고 하겠습니다.
\[
T_i=\begin{cases}
1 \ \text{if unit i received the treatment}\\
0 \ \text{otherwise}\\
\end{cases}
\]
여기서 처치는 약이나 의료 분야의 무언가일 필요가 없습니다. 효과를 알고 싶은 어떤 개입(intervention)을 가리키는 용어일 뿐입니다. 이 예시에서 처치는 학생들에게 태블릿을 주는 것입니다. 참고로 처치를 \(T\) 대신 \(D\)로 표기하는 자료도 있습니다.
이제 대상 i에서 관측한 결과변수(outcome variable)를 \(Y_i\)라고 하겠습니다.
결과는 우리가 관심을 두는 변수입니다. 처치가 결과에 조금이라도 영향을 미치는지 알고 싶은 것입니다. 태블릿 예시에서는 학업 성취도가 결과입니다.
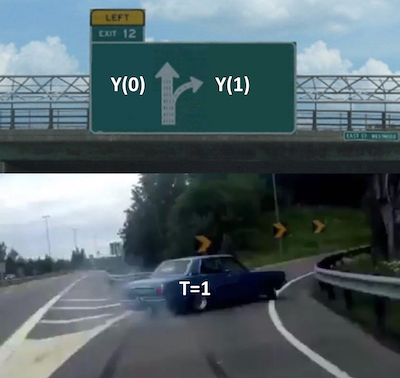
여기서부터 흥미로워집니다. 인과추론의 근본적인 문제(fundamental problem of causal inference)는 같은 대상을 처치를 받은 상태와 받지 않은 상태로 동시에 관측할 수 없다는 점입니다. 마치 두 갈래 길 앞에서 한 길을 고르면 그 길 앞에 무엇이 있는지만 알 수 있는 것과 같습니다. 로버트 프로스트(Robert Frost)의 시처럼 말입니다.
노랗게 물든 숲속에 두 갈래 길이 있었습니다.
안타깝게도 나는 한 사람의 나그네라
두 길을 다 가 볼 수는 없었기에, 오랫동안 서서
한 길이 덤불 속으로 굽어 사라지는 곳까지
멀리멀리 바라보았습니다.
이 문제를 이해하기 위해 앞으로 잠재적 결과(potential outcome)라는 관점으로 자주 이야기하겠습니다. ’잠재적’이라고 부르는 이유는 실제로 일어나지 않았기 때문입니다. 잠재적 결과는 어떤 처치를 받았다면 일어났을 일을 나타냅니다. 잠재적 결과 가운데 실제로 일어난 것을 사실적 결과(factual outcome), 일어나지 않은 것을 반사실적 결과라고 부르기도 합니다.
표기법으로는 아래첨자를 하나 더 붙입니다.
\(Y_{0i}\)는 처치를 받지 않았을 때 대상 i의 잠재적 결과입니다.
\(Y_{1i}\)는 처치를 받았을 때 같은 대상 i의 잠재적 결과입니다.
잠재적 결과를 함수 \(Y_i(t)\)로 나타내는 경우도 있으니 주의하세요. \(Y_{0i}\)는 \(Y_i(0)\)로, \(Y_{1i}\)는 \(Y_i(1)\)로 쓸 수 있습니다. 이 책에서는 대부분 아래첨자 표기를 사용합니다.
예시로 돌아가면, \(Y_{1i}\)는 학생 i가 태블릿이 있는 교실에 있을 때의 학업 성취도입니다. 학생이 실제로 그런 교실에 있는지 없는지는 \(Y_{1i}\)와 상관이 없습니다. 어느 쪽이든 그 값은 같습니다. 학생 i가 태블릿을 받으면 \(Y_{1i}\)를 관측할 수 있고, 받지 않으면 \(Y_{0i}\)를 관측할 수 있습니다. 뒤의 경우에도 \(Y_{1i}\)는 여전히 정의되어 있고, 다만 볼 수 없을 뿐이라는 점에 주목하세요. 이때 그 값은 반사실적 잠재적 결과입니다.
잠재적 결과를 이용하면 개별 처치효과(individual treatment effect)를 정의할 수 있습니다.
\(Y_{1i} - Y_{0i}\)
물론 인과추론의 근본적인 문제 때문에 잠재적 결과 중 하나만 관측할 수 있으므로, 개별 처치효과는 결코 알 수 없습니다. 당분간은 개별 처치효과를 추정하는 것보다 쉬운 문제에 집중하겠습니다. 바로 다음과 같이 정의하는 평균 처치효과(average treatment effect)입니다.
\(ATE = E[Y_1 - Y_0]\)
여기서 E[...]는 기댓값입니다. 비교적 쉽게 추정할 수 있는 또 다른 값으로 실험군에 대한 평균 처치효과(average treatment effect on the treated)가 있습니다.
\(ATT = E[Y_1 - Y_0 | T=1]\)
두 잠재적 결과를 모두 볼 수 없다는 건 알지만, 논의를 위해 볼 수 있다고 가정해 봅시다. 우리가 치른 수많은 통계 전투에 흡족해한 인과추론의 신이, 일어나지 않은 다른 잠재적 결과까지 볼 수 있는 신과 같은 능력을 상으로 내렸다고 상상해 보세요. 그 능력으로 학교 4곳의 데이터를 모았다고 하겠습니다. 각 학교가 학생들에게 태블릿을 주었는지, 그리고 매년 치르는 학력 평가에서 몇 점을 받았는지 알고 있습니다. 여기서는 태블릿이 처치이므로, 학교가 아이들에게 태블릿을 제공하면 \(T=1\)입니다. \(Y\)는 시험 점수입니다.
분명 이상적이지는 않다고 하실 수도 있습니다. 그래도 실험군(treated)의 평균을 구해서 대조군(untreated)의 평균과 비교하면 되지 않을까요? 다시 말해 그냥 \(ATE=(600+750)/2 - (500 + 600)/2 = 125\)로 계산하면 안 될까요? 안 됩니다! 결과가 얼마나 다른지 보세요. 방금 연관관계를 인과관계로 착각하는, 가장 무거운 죄를 저질렀습니다. 왜 그런지 이해하기 위해 인과추론의 가장 큰 적을 살펴보겠습니다.
편향
편향(bias)은 연관관계와 인과관계를 다르게 만드는 요소입니다. 다행히 편향은 직관으로 쉽게 이해할 수 있습니다. 교실의 태블릿 예시를 다시 떠올려 봅시다. 학생들에게 태블릿을 주는 학교의 시험 점수가 더 높다는 주장을 들으면, 그런 학교는 태블릿이 없어도 어차피 점수가 높았을 것이라고 반박할 수 있습니다. 그런 학교는 다른 학교보다 돈이 많을 가능성이 크고, 그래서 더 좋은 교사를 채용하고 더 좋은 교실을 갖출 수 있기 때문입니다. 결국 처치를 받은 학교(태블릿이 있는 학교)와 처치를 받지 않은 학교는 비교할 수 없습니다.
잠재적 결과 표기법으로 말하면, 실험군의 \(Y_0\)가 대조군의 \(Y_0\)와 다르다는 뜻입니다. 실험군의 \(Y_0\)는 반사실이라는 점을 기억하세요. 관측할 수는 없지만 추론할 수는 있습니다. 이 경우에는 세상이 돌아가는 방식을 알고 있으니 한 걸음 더 나아갈 수도 있습니다. 아마도 실험군의 \(Y_0\)가 대조군 학교의 \(Y_0\)보다 클 것이라고 말할 수 있습니다. 아이들에게 태블릿을 줄 여유가 있는 학교라면 시험 점수를 높이는 다른 요소에도 돈을 쓸 여유가 있을 테니까요. 잠시 이 내용을 곱씹어 보세요. 잠재적 결과로 이야기하는 데 익숙해지려면 시간이 좀 걸립니다. 이 문단을 다시 읽고 확실히 이해했는지 확인하세요.
이를 염두에 두면 연관관계가 인과관계가 아닌 이유를 간단한 수학으로 보일 수 있습니다. 연관관계는 \(E[Y|T=1] - E[Y|T=0]\)로 측정합니다. 이 예시에서는 태블릿이 있는 학교의 평균 시험 점수에서 태블릿이 없는 학교의 평균 시험 점수를 뺀 값입니다. 반면 인과관계는 \(E[Y_1 - Y_0]\)로 측정합니다.
연관관계 측정값에서 관측된 결과를 잠재적 결과로 바꿔서 둘이 어떤 관계인지 살펴봅시다. 실험군에서 관측된 결과는 \(Y_1\)이고, 대조군에서 관측된 결과는 \(Y_0\)입니다.
이 간단한 수식에 인과적 질문에서 마주칠 모든 문제가 담겨 있습니다. 이 식을 구석구석 이해하는 것이 얼마나 중요한지는 아무리 강조해도 지나치지 않습니다. 언젠가 팔에 문신을 새겨야 하는 상황이 온다면 이 식이 좋은 후보가 될 겁니다. 백 가지 방식으로 해석할 수 있는 경전처럼 소중히 붙들고, 이 식이 무엇을 말하는지 이해해야 합니다. 그럼 좀 더 깊이 들여다봅시다. 이 식이 함의하는 바를 몇 가지로 나눠 보겠습니다. 첫째, 이 식은 연관관계가 왜 인과관계가 아닌지 알려줍니다. 보다시피 연관관계는 실험군에 대한 처치효과에 편향 항을 더한 값과 같습니다. 편향은 실험군과 대조군이 둘 다 처치를 받지 않았을 때, 처치 이전에 두 그룹이 얼마나 다른지로 결정됩니다. 이제 누군가 교실의 태블릿이 학업 성취도를 높인다고 말할 때 왜 의심이 드는지 정확히 설명할 수 있습니다. 이 예시에서는 \(E[Y_0|T=0] < E[Y_0|T=1]\)이라고 생각합니다. 즉, 아이들에게 태블릿을 줄 여유가 있는 학교는 태블릿이라는 처치와 상관없이 그렇지 못한 학교보다 낫다고 보는 것입니다.
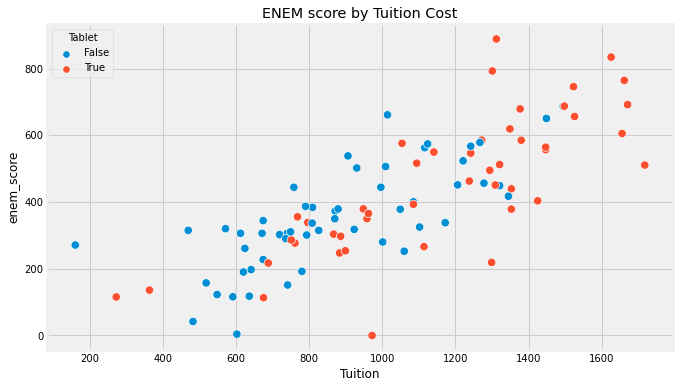
왜 이런 일이 생길까요? 교란(confounding)을 다룰 때 더 자세히 이야기하겠지만, 지금은 우리가 통제할 수 없는 많은 것이 처치와 함께 변하기 때문에 편향이 생긴다고 생각하면 됩니다. 그 결과 실험군 학교와 대조군 학교는 태블릿만 다른 것이 아닙니다. 등록금, 위치, 교사 등도 다릅니다… 교실의 태블릿이 학업 성취도를 높인다고 말하려면, 태블릿이 있는 학교와 없는 학교가 평균적으로 서로 비슷해야 합니다.
코드
plt.figure(figsize=(10,6))sns.scatterplot(x="Tuition", y="enem_score", hue="Tablet", data=data, s=70).set_title('ENEM score by Tuition Cost')plt.show()
문제를 이해했으니 이제 해결책을 살펴봅시다. 연관관계가 인과관계와 같아지려면 무엇이 필요한지도 말할 수 있습니다. \(E[Y_0|T=0] = E[Y_0|T=1]\)이면, 연관관계가 곧 인과관계입니다! 이 식은 외우고 끝낼 대상이 아닙니다. 여기에는 강력한 직관이 담겨 있습니다. \(E[Y_0|T=0] = E[Y_0|T=1]\)이라는 말은 처치 이전에 실험군과 대조군을 비교할 수 있다는 뜻입니다. 달리 말하면, 실험군이 처치를 받지 않았을 때의 \(Y_0\)를 관측할 수 있다면 그 결과는 대조군과 같을 것이라는 뜻입니다. 수학적으로는 편향 항이 사라집니다.
게다가 실험군과 대조군이 처치 자체만 다르다면 \(E[Y_1|T=0] = E[Y_1|T=1]\)도 성립합니다. 즉, 실험군과 대조군이 처치에 비슷하게 반응한다는 것이 보장됩니다. 이제 실험군과 대조군은 처치 이전에 교환 가능(exchangeable)할 뿐 아니라 처치 이후에도 교환 가능합니다. 이 경우 \(E[Y_1 - Y_0|T=1]=E[Y_1 - Y_0|T=0]\)이고
\[
E[Y|T=1] - E[Y|T=0] = ATT = ATE
\]
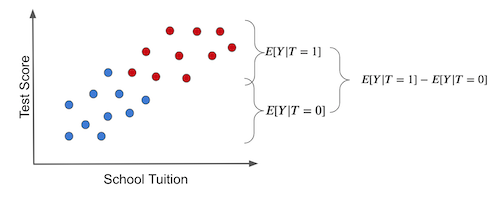
다시 말하지만 이 내용은 정말 중요하니, 이번에는 보기 좋은 그림과 함께 한 번 더 짚어 보겠습니다. 실험군과 대조군의 평균을 단순 비교하면 다음과 같은 결과를 얻습니다(파란 점은 처치, 즉 태블릿을 받지 않은 학교입니다).
두 그룹 간 결과 차이에는 두 가지 원인이 있을 수 있다는 점에 주목하세요.
처치효과. 아이들에게 태블릿을 주어서 시험 점수가 오른 부분입니다.
시험 점수 차이의 일부는 더 나은 교육을 위한 등록금 차이 때문일 수 있습니다. 이 경우 실험군의 등록금이 훨씬 비싸기 때문에 실험군과 대조군이 다릅니다. 실험군과 대조군 사이에는 이처럼 처치 그 자체가 아닌 다른 차이도 있습니다.
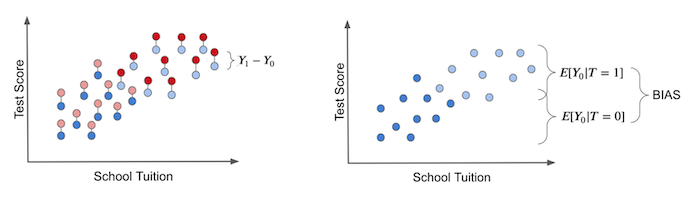
개별 처치효과는 대상의 결과와, 같은 대상이 다른 처치를 받았다면 얻었을 이론적 결과 사이의 차이입니다. 진짜 처치효과는 아래 왼쪽 그림처럼 잠재적 결과를 관측할 수 있는 신과 같은 능력이 있어야만 구할 수 있습니다. 연한 색으로 표시한 점들이 반사실적 결과입니다.
오른쪽 그림에는 앞서 이야기한 편향을 나타냈습니다. 모든 대상이 처치를 받지 않도록 설정하면 편향을 볼 수 있습니다. 이렇게 하면 \(T_0\) 잠재적 결과만 남습니다. 그런 다음 실험군과 대조군이 어떻게 다른지 봅니다. 차이가 있다면 처치가 아닌 다른 무언가가 두 그룹을 다르게 만들고 있는 것입니다. 이 무언가가 바로 편향이며, 진짜 처치효과를 가리는 요인입니다.
힌트옮긴이
위 문단의 T₀는 원문 그대로 옮긴 것으로, 처치를 받지 않았을 때의 잠재적 결과 Y₀를 잘못 적은 것으로 보입니다.
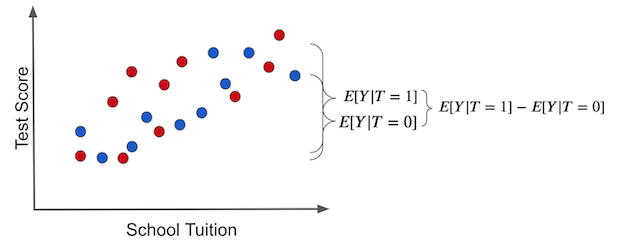
이번에는 편향이 없는 가상의 상황과 비교해 봅시다. 태블릿을 학교에 무작위로 배정한다고 해 보겠습니다. 이때 부유한 학교와 가난한 학교가 처치를 받을 확률은 같습니다. 처치는 등록금 수준 전반에 고르게 퍼질 것입니다.
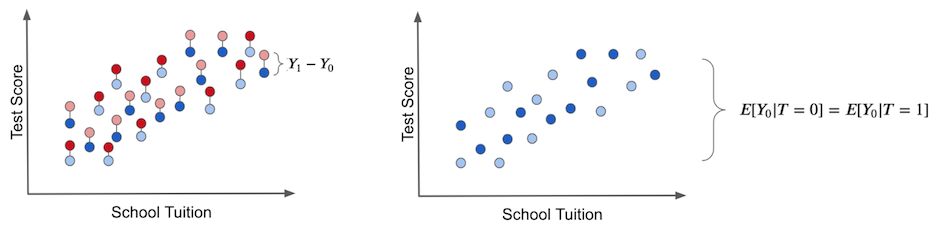
이 경우 실험군과 대조군의 결과 차이가 곧 평균 인과효과입니다. 처치 자체 말고는 실험군과 대조군 사이에 차이를 만드는 다른 원인이 없기 때문입니다. 관측되는 모든 차이는 처치 때문이라고 봐야 합니다. 편향이 없다는 말입니다.
모든 대상이 처치를 받지 않도록 설정해 \(Y_0\)만 관측한다면, 실험군과 대조군 사이에서 아무런 차이도 발견되지 않을 것입니다.
인과추론이 다루는 일이 바로 이 헤라클레스급 과업입니다. 편향을 제거하고 실험군과 대조군을 비교 가능하게 만들어서, 관측되는 차이에 평균 처치효과만 남도록 하는 영리한 방법을 찾는 일입니다. 궁극적으로 인과추론은 모든 착각과 오해를 걷어 내고 세상이 실제로 어떻게 돌아가는지 알아내는 학문입니다. 이 점을 이해했으니, 이제 편향을 제거하고 인과효과를 식별하는 가장 강력한 방법들, 즉 용감하고 진실한 자들의 무기를 익히러 나아가 봅시다.
핵심 요약
지금까지 연관관계가 인과관계가 아니라는 것을 살펴봤습니다. 무엇보다 왜 그런지, 그리고 어떻게 하면 연관관계를 인과관계로 만들 수 있는지를 정확히 알아봤습니다. 또한 인과적 사고를 정리하는 도구로 잠재적 결과 표기법을 소개했습니다. 이 표기법 덕분에 통계를 두 가지 가능한 현실로 바라볼 수 있었습니다. 하나는 처치가 주어진 현실이고, 다른 하나는 처치가 주어지지 않은 현실입니다. 하지만 안타깝게도 그중 하나만 측정할 수 있으며, 바로 여기에 인과추론의 근본적인 문제가 있습니다.
앞으로 인과효과를 추정하는 몇 가지 기본 기법을 살펴볼 텐데, 그 출발점은 황금 표준인 무작위 실험(randomized trial)입니다. 진행하면서 통계 개념도 몇 가지 복습하겠습니다. 끝으로 인과추론 수업에서 자주 인용되는 쿵후 드라마의 한 대목으로 이 장을 마치겠습니다.
‘사람의 인생에 일어나는 일은 이미 쓰여 있습니다. 사람은 운명이 이끄는 대로 살아가야 합니다.’ -케인
‘그렇지. 하지만 사람은 누구나 원하는 대로 살아갈 자유도 있다네. 서로 반대처럼 보여도 둘 다 진실이지.’ -노인
참고 자료
저는 이 책 전체를 Joshua Angrist, Alberto Abadie, Christopher Walters의 훌륭한 계량경제학 강의에 바치는 헌사라고 생각합니다. 이 책에 담긴 아이디어 대부분은 이들이 미국경제학회(American Economic Association)에서 한 강의에서 가져왔습니다. 힘든 2020년을 버틸 수 있는 것도 이 강의들을 보는 덕분입니다. * Cross-Section Econometrics * Mastering Mostly Harmless Econometrics
Angrist의 멋진 책들도 참고 자료로 소개하고 싶습니다. 이 책들 덕분에 계량경제학, 이들 표현으로는 ’Metrics가 아주 유용할 뿐 아니라 무척 재미있다는 것을 알게 되었습니다.
맥주 비유는 JL Colins의 멋진 주식 시리즈에서 가져왔습니다. 돈을 생산적으로 투자하는 법을 배우고 싶은 분이라면 반드시 읽어 보시길 권합니다.
기여하기
Causal Inference for the Brave and True는 과학의 통계학이라 할 수 있는 인과추론을 다루는 오픈소스 자료입니다. 파이썬 기반의 무료 소프트웨어만 사용하며, 돈이 없어도, 배경지식이 많지 않아도 누구나 볼 수 있는 자료를 목표로 합니다. 이 책이 도움이 되었고 후원하고 싶다면 Patreon을 방문해 주세요. 금전적으로 기여하기 어렵다면 오타를 고치거나, 수정할 부분을 제안하거나, 이해하기 어려웠던 부분에 의견을 주는 것으로도 도울 수 있습니다. 책의 저장소에서 이슈를 열어 주세요. 마지막으로 이 내용이 마음에 들었다면 도움이 될 만한 사람들과 공유하고 GitHub에서 스타를 눌러 주세요.
의견 나누기
번역이 어색한 곳, 더 쉬운 설명, 궁금한 점을 남겨 주세요. GitHub 계정으로 로그인하면 댓글을 달 수 있고, 남긴 의견은 GitHub Discussions에 장별로 모입니다.