코드
import warnings
warnings.filterwarnings('ignore')

import pandas as pd
import numpy as np
import statsmodels.formula.api as smf
import graphviz as gr
%matplotlib inline인과추론을 다루면서 각 개인에게는 두 가지 잠재적 결과(potential outcome)가 있다는 것을 보았습니다. \(Y_0\)는 그 사람이 처치(treatment)를 받지 않았을 때의 결과이고, \(Y_1\)은 처치를 받았을 때의 결과입니다. 처치 \(T\)를 0이나 1로 정하는 순간 잠재적 결과 중 하나는 현실이 되고, 나머지 하나는 영영 알 수 없게 됩니다. 그래서 개별 처치효과(ITE) \(\tau_i = Y_{1i} - Y_{0i}\)는 알 수 없습니다.
\[ Y_i = Y_{0i} + T_i(Y_{1i} - Y_{0i}) = Y_{0i}(1-T_i) + T_i Y_{1i} \]
그러니 당분간은 더 쉬운 과제인 평균 인과효과 추정에 집중해 봅시다. 처치에 더 잘 반응하는 사람과 덜 반응하는 사람이 있다는 사실은 받아들이되, 그게 누구인지는 알 수 없다는 사실도 함께 받아들이는 것입니다. 대신 처치가 평균적으로 효과가 있는지만 확인해 보겠습니다.
\[ ATE = E[Y_1 - Y_0] \]
이렇게 하면 처치효과가 일정한 단순한 모델 \(Y_{1i} = Y_{0i} + \kappa\)를 얻습니다. \(\kappa\)가 양수라면 처치가 평균적으로 긍정적인 효과를 낸다고 말합니다. 처치에 나쁘게 반응하는 사람이 일부 있더라도 평균적으로는 긍정적인 영향이 있다는 뜻입니다.
편향(bias) 때문에 \(E[Y_1 - Y_0]\)를 평균의 차이 \(E[Y|T=1] - E[Y|T=0]\)로 그냥 추정할 수는 없다는 점도 다시 떠올려 봅시다. 편향은 대개 실험군과 대조군이 처치 말고 다른 이유로도 서로 다를 때 생깁니다. 이를 확인하는 한 가지 방법은 두 집단의 잠재적 결과 \(Y_0\)가 어떻게 다른지 보는 것입니다.
\[ E[Y|T=1] - E[Y|T=0] = \underbrace{E[Y_1 - Y_0|T=1]}_{ATET} + \underbrace{\{ E[Y_0|T=1] - E[Y_0|T=0]\}}_{BIAS} \]
앞에서 무작위 실험, 다른 말로 무작위 통제 실험(RCT)으로 편향을 없앨 수 있다는 것을 보았습니다. RCT는 실험군과 대조군을 같게 만들기 때문에 편향이 사라집니다. 처치효과 추정값에 불확실성의 범위를 붙이는 방법도 살펴보았습니다. 온라인 수업과 대면 수업을 비교한 사례였는데, \(T=0\)은 대면 수업, \(T=1\)은 온라인 수업을 나타냈습니다. 학생들을 두 수업 방식 중 하나에 무작위로 배정한 뒤 시험 성적을 평가했습니다. 그리고 두 그룹을 비교해 평균 처치효과(ATE)를 구하고 신뢰구간까지 계산해 주는 A/B 테스트 함수를 만들었습니다.
이제 이 모든 일을 인과추론의 든든한 일꾼인 선형회귀(linear regression)로 할 수 있다는 것을 보여 드릴 차례입니다! 이렇게 생각해 보세요. 실험군과 대조군의 평균을 비교하는 것이 디저트로 나온 사과 한 알이라면, 선형회귀는 차갑고 부드러운 티라미수입니다. 실험군과 대조군을 비교하는 것이 오래되어 처량한 원더 브레드 흰 식빵이라면, 선형회귀는 채드 로버트슨이 직접 구운, 껍질은 바삭하고 속은 촉촉한 시골풍 사워도우입니다.
이 멋진 도구가 어떻게 돌아가는지 봅시다. 아래 코드에서는 온라인 수업과 대면 수업을 비교하는 분석을 똑같이 해 보겠습니다. 다만 신뢰구간을 구하는 수식 계산을 일일이 하는 대신 회귀분석만 돌립니다. 구체적으로는 다음 모델을 추정합니다.
\[ exam_i = \beta_0 + \kappa \ Online_i + u_i \]
시험 결과를 기준값 \(\beta_0\)에, 온라인 수업이면 \(\kappa\)를 더한 값으로 모델링한다는 뜻입니다. 물론 시험 결과에는 다른 변수들(시험 당일 학생의 기분, 공부한 시간 등)도 영향을 줍니다. 하지만 그런 관계를 이해하는 데는 별 관심이 없습니다. 그래서 관심 없는 나머지 모든 것을 \(u_i\) 항 하나로 나타냅니다. 이 항을 모델 오차(model error)라고 합니다.
\(Online\)은 처치 여부를 나타내므로 더미변수(dummy variable)입니다. 대면 수업이면 0, 온라인 수업이면 1입니다. 이 점을 생각하면 선형회귀가 \(E[Y|T=0] = \beta_0\)와 \(E[Y|T=1] = \beta_0 + \kappa\)를 찾아낸다는 것을 알 수 있습니다. 즉 \(\kappa\)가 ATE가 됩니다.
원더 브레드(Wonder Bread)는 미국의 대표적인 공장제 흰 식빵 브랜드이고, 채드 로버트슨(Chad Robertson)은 샌프란시스코 타르틴 베이커리(Tartine Bakery)를 세운 제빵사로 사워도우 빵으로 이름난 사람입니다.
import warnings
warnings.filterwarnings('ignore')
import pandas as pd
import numpy as np
import statsmodels.formula.api as smf
import graphviz as gr
%matplotlib inlinedata = pd.read_csv("data/online_classroom.csv").query("format_blended==0")
result = smf.ols('falsexam ~ format_ol', data=data).fit()
result.summary().tables[1]| coef | std err | t | P>|t| | [0.025 | 0.975] | |
|---|---|---|---|---|---|---|
| Intercept | 78.5475 | 1.113 | 70.563 | 0.000 | 76.353 | 80.742 |
| format_ol | -4.9122 | 1.680 | -2.925 | 0.004 | -8.223 | -1.601 |
정말 놀랍지 않나요? ATE를 추정할 수 있을 뿐 아니라 신뢰구간과 p 값까지 덤으로 얻습니다! 게다가 회귀분석이 원래 해야 할 일, 즉 \(E[Y|T=0]\)와 \(E[Y|T=1]\)를 비교하는 일을 정확히 하고 있다는 것도 볼 수 있습니다. 절편(intercept)은 \(T=0\)일 때의 표본평균 \(E[Y|T=0]\)와 정확히 같고, 온라인 수업 변수의 계수는 표본평균의 차이 \(E[Y|T=1] - E[Y|T=0]\)와 정확히 같습니다. 못 믿겠다고요? 괜찮습니다. 직접 확인해 보세요.
(data
 .groupby("format_ol")
 ["falsexam"]
 .mean())
format_ol
0 78.547485
1 73.635263
Name: falsexam, dtype: float64예상대로입니다. 절편에 ATE, 즉 온라인 수업 변수의 매개변수 추정값을 더하면 실험군의 표본평균 \(78.5475 + (-4.9122) = 73.635263\)이 나옵니다.
선형회귀가 어떻게 구성되고 추정되는지 깊이 파고들 생각은 없습니다. 하지만 이론을 조금만 알아도 인과추론에서 회귀분석이 왜 강력한지 설명하는 데 큰 도움이 됩니다. 먼저, 회귀분석은 이론적으로 최적의 선형 예측 문제를 풉니다. \(\beta^*\)를 매개변수 벡터라고 합시다.
\[ \beta^* =\underset{\beta}{argmin} \ E[(Y_i - X_i'\beta)^2] \]
선형회귀는 평균제곱오차(MSE)를 최소화하는 매개변수를 찾습니다.
이 식을 미분해서 0으로 놓으면, 이 문제의 선형 해는 다음과 같습니다.
\[ \beta^* = E[X_i'X_i]^{-1}E[X_i' Y_i] \]
이 베타는 표본에서 대응하는 값으로 추정할 수 있습니다.
\[ \hat{\beta} = (X'X)^{-1}X' Y \]
그렇다고 제 말만 믿지는 마세요. 수식보다 코드가 더 잘 읽히는 분이라면 직접 해 보세요.
X = data[["format_ol"]].assign(intercep=1)
y = data["falsexam"]

def regress(y, X):
    return np.linalg.inv(X.T.dot(X)).dot(X.T.dot(y))

beta = regress(y, X)
beta
array([-4.9122215 , 78.54748458])위 공식은 꽤 일반적입니다. 그래도 설명변수(regressor)가 하나뿐인 경우를 따로 살펴볼 가치가 있습니다. 인과추론에서는 변수 \(T\)가 결과 \(y\)에 미치는 인과적 영향을 추정하고 싶을 때가 많습니다. 그래서 이 변수 하나만 넣은 회귀분석으로 효과를 추정합니다. 모델에 다른 변수를 넣더라도 대개는 보조 역할일 뿐입니다. 다른 변수를 추가하면 처치의 인과효과를 추정하는 데 도움이 되지만, 그 변수들의 매개변수 자체를 추정하는 데는 별 관심이 없습니다.
설명변수가 \(T\) 하나뿐이면, 여기에 해당하는 매개변수는 다음과 같습니다.
\[ \beta_1 = \dfrac{Cov(Y_i, T_i)}{Var(T_i)} \]
\(T\)가 무작위로 배정되었다면 \(\beta_1\)이 곧 ATE입니다.
kappa = data["falsexam"].cov(data["format_ol"]) / data["format_ol"].var()
kappa-4.91222149822695설명변수가 둘 이상이면 이 공식을 확장해서 쓸 수 있습니다. 다른 변수들은 보조 역할일 뿐이고, 정말 관심 있는 것은 \(T\)에 해당하는 매개변수 \(\kappa\)를 추정하는 것이라고 해 봅시다.
\[ y_i = \beta_0 + \kappa T_i + \beta_1 X_{1i} + ... +\beta_k X_{ki} + u_i \]
\(\kappa\)는 다음 공식으로 구할 수 있습니다.
\[ \kappa = \dfrac{Cov(Y_i, \tilde{T_i})}{Var(\tilde{T_i})} \]
여기서 \(\tilde{T_i}\)는 \(T_i\)를 다른 모든 공변량(covariate) \(X_{1i}, ..., X_{ki}\)에 회귀해서 얻은 잔차(residual)입니다. 이게 얼마나 멋진 일인지 잠시 음미해 봅시다. 다중회귀의 계수가 모델에 있는 다른 변수들의 영향을 고려한 뒤 같은 설명변수로 구한 이변량(bivariate) 계수와 같다는 뜻이기 때문입니다. 인과추론의 언어로 말하면, \(\kappa\)는 다른 모든 변수로 처치를 예측하고 난 뒤에 구한 \(T\)의 이변량 계수입니다.
여기에는 좋은 직관이 담겨 있습니다. 다른 변수로 \(T\)를 예측할 수 있다면 처치가 무작위가 아니라는 뜻입니다. 하지만 사용할 수 있는 다른 변수들을 통제하고 나면 \(T\)를 무작위나 다름없게 만들 수 있습니다. 그러려면 선형회귀로 다른 변수들에서 처치를 예측한 다음, 그 회귀의 잔차 \(\tilde{T}\)를 구하면 됩니다. 정의상 \(\tilde{T}\)는 \(T\)를 예측하는 데 이미 쓴 다른 변수 \(X\)로는 예측할 수 없습니다. 아주 깔끔하게도, \(\tilde{T}\)는 \(X\)의 어떤 변수와도 연관되지 않도록 걸러 낸 처치입니다.
덧붙이면 이것 역시 선형회귀의 성질입니다. 잔차는 그 잔차를 만든 모델의 어떤 변수와도 항상 직교합니다. 다시 말해 상관관계가 없습니다.
e = y - X.dot(beta)
print("Orthogonality imply that the dot product is zero:", np.dot(e, X))
X[["format_ol"]].assign(e=e).corr()
Orthogonality imply that the dot product is zero: [7.81597009e-13 4.63984406e-12]| format_ol | e | |
|---|---|---|
| format_ol | 1.000000e+00 | -9.419033e-16 |
| e | -9.419033e-16 | 1.000000e+00 |
더 멋진 점은 이 성질들이 아무 조건에도 기대지 않는다는 것입니다! 데이터가 어떻게 생겼든 성립하는 수학적 사실입니다.
지금까지는 무작위 실험 데이터를 다뤘지만, 알다시피 그런 데이터는 구하기 어렵습니다. 실험은 비용이 아주 많이 들거나 아예 불가능한 경우가 많습니다. 예를 들어 맥킨지(McKinsey & Co.)에 무작위로 고른 회사에 무료로 컨설팅을 해 달라고 설득하기는 무척 어렵습니다. 그렇게만 할 수 있다면 맥킨지 컨설팅이 실제로 가져다주는 가치와, 애초에 맥킨지에 돈을 낼 수 있는 회사는 이미 형편이 아주 좋다는 사실을 단번에 구분할 수 있을 것입니다.
그래서 이제부터는 무작위가 아닌 데이터, 즉 관측 데이터(observational data)를 깊이 다뤄 보겠습니다. 다음 예제에서는 교육을 1년 더 받는 것이 시간당 임금에 미치는 영향을 추정합니다. 짐작하셨겠지만 교육으로 실험을 하기는 극도로 어렵습니다. 사람들을 4년, 8년, 12년 교육에 무작위로 배정할 수는 없기 때문입니다. 이럴 때 손에 쥔 것은 관측 데이터뿐입니다.
먼저 아주 단순한 모델을 추정해 봅시다. 로그 시간당 임금을 교육 연수에 회귀합니다. 로그를 쓰는 이유는 매개변수 추정값을 백분율로 해석할 수 있기 때문입니다(로그의 이 놀라운 성질을 처음 들어 보았고 왜 그런지 궁금하다면 이 링크를 확인해 보세요). 이렇게 하면 교육을 1년 더 받을 때 임금이 x% 오른다고 말할 수 있습니다.
\[ log(hwage)_i = \beta_0 + \beta_1 educ_i + u_i \]
wage = pd.read_csv("./data/wage.csv").dropna()
model_1 = smf.ols('np.log(hwage) ~ educ', data=wage.assign(hwage=wage["wage"]/wage["hours"])).fit()
model_1.summary().tables[1]| coef | std err | t | P>|t| | [0.025 | 0.975] | |
|---|---|---|---|---|---|---|
| Intercept | 2.3071 | 0.104 | 22.089 | 0.000 | 2.102 | 2.512 |
| educ | 0.0536 | 0.008 | 7.114 | 0.000 | 0.039 | 0.068 |
\(\beta_1\)의 추정값은 0.0536이고, 95% 신뢰구간은 (0.039, 0.068)입니다. 이 모델은 교육 연수가 1년 늘 때마다 임금이 약 5.3% 오른다고 예측합니다. 이렇게 비율로 늘어난다는 점은 교육이 임금에 지수적으로 영향을 준다는 믿음과도 맞아떨어집니다. 교육 연수가 11년에서 12년이 될 때(보통 고등학교를 졸업하는 시점)보다 14년에서 16년이 될 때(보통 대학교를 졸업하는 시점) 얻는 보상이 더 크리라고 예상하기 때문입니다.
from matplotlib import pyplot as plt
from matplotlib import style
style.use("fivethirtyeight")

x = np.array(range(5, 20))
plt.plot(x, np.exp(model_1.params["Intercept"] + model_1.params["educ"] * x))
plt.xlabel("Years of Education")
plt.ylabel("Hourly Wage")
plt.title("Impact of Education on Hourly Wage")
plt.show()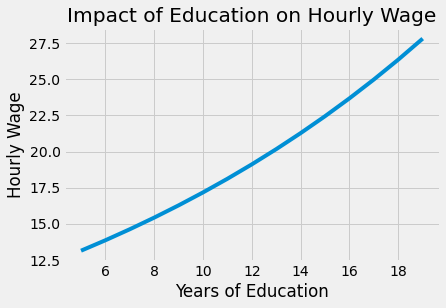
물론 이 단순한 모델을 추정할 수 있다고 해서 그 모델이 옳은 것은 아닙니다. 제가 교육으로 임금을 예측한다고 조심스럽게 표현한 것에 주목하세요. 이 예측이 인과적이라고는 한 번도 말하지 않았습니다. 사실 지금쯤이면 이 모델이 편향되었다고 믿을 만한 아주 중대한 이유가 떠오를 겁니다. 데이터가 무작위 실험에서 나온 것이 아니므로, 교육을 더 받은 사람과 덜 받은 사람을 비교할 수 있는지 알 수 없습니다. 한 걸음 더 나아가, 세상이 돌아가는 방식을 생각해 보면 둘은 비교할 수 없다고 거의 확신할 수 있습니다. 예를 들어 교육을 더 오래 받은 사람은 부모가 더 부유할 가능성이 높습니다. 그렇다면 교육 연수가 늘수록 임금이 오르는 것처럼 보이는 것도 집안의 재산이 교육 연수와 연관되어 있다는 사실이 반영된 것일 뿐이라고 주장할 수 있습니다. 이를 수식으로 쓰면 \(E[Y_0|T=0] < E[Y_0|T=1]\)입니다. 교육을 더 받은 사람은 그만큼 교육을 받지 않았더라도 어차피 소득이 더 높았으리라는 뜻입니다. 교육을 정말 비관적으로 보는 사람이라면, 교육이 사람들을 노동시장 밖에 붙잡아 두어 경력을 쌓지 못하게 하므로 오히려 임금을 낮춘다고 주장할 수도 있습니다.
다행히 데이터에는 다른 변수가 많이 있습니다. 부모의 교육 연수 meduc, feduc, 본인의 IQ 점수, 경력 연수 exper, 현재 회사 근속 연수 tenure를 볼 수 있습니다. 결혼 여부와 흑인 여부를 나타내는 더미변수도 있습니다.
wage.head()| wage | hours | lhwage | IQ | educ | exper | tenure | age | married | black | south | urban | sibs | brthord | meduc | feduc | |
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| 0 | 769 | 40 | 2.956212 | 93 | 12 | 11 | 2 | 31 | 1 | 0 | 0 | 1 | 1 | 2.0 | 8.0 | 8.0 |
| 2 | 825 | 40 | 3.026504 | 108 | 14 | 11 | 9 | 33 | 1 | 0 | 0 | 1 | 1 | 2.0 | 14.0 | 14.0 |
| 3 | 650 | 40 | 2.788093 | 96 | 12 | 13 | 7 | 32 | 1 | 0 | 0 | 1 | 4 | 3.0 | 12.0 | 12.0 |
| 4 | 562 | 40 | 2.642622 | 74 | 11 | 14 | 5 | 34 | 1 | 0 | 0 | 1 | 10 | 6.0 | 6.0 | 11.0 |
| 6 | 600 | 40 | 2.708050 | 91 | 10 | 13 | 0 | 30 | 0 | 0 | 0 | 1 | 1 | 2.0 | 8.0 | 8.0 |
이 추가 변수들을 모두 모델에 넣고 추정할 수 있습니다.
\[ log(hwage)_i = \beta_0 + \kappa \ educ_i + \pmb{\beta}X_i + u_i \]
이것이 편향 문제에 어떻게 도움이 되는지 이해하기 위해, 다중 선형회귀를 이변량 회귀로 분해하는 방법을 다시 떠올려 봅시다.
\[ \kappa = \dfrac{Cov(Y_i, \tilde{T_i})}{Var(\tilde{T_i})} \]
이 공식에 따르면 부모의 교육 연수, IQ, 경력 등으로 educ를 예측할 수 있습니다. 그렇게 하고 나면 앞에서 넣은 모든 변수와 상관관계가 없도록 걸러 낸 educ, 즉 \(\tilde{educ}\)가 남습니다. 덕분에 “교육을 더 오래 받은 사람은 IQ가 높아서 그만큼 교육을 받은 것이다. 교육이 임금을 높이는 것이 아니다. 교육은 IQ와 상관관계가 있을 뿐이고, 임금을 결정하는 것은 IQ다” 같은 주장을 반박할 수 있습니다. 모델에 IQ를 넣으면 \(\kappa\)는 IQ를 고정한 상태에서 교육을 1년 더 받았을 때의 수익이 되기 때문입니다. 잠시 멈추고 이것이 무엇을 뜻하는지 생각해 보세요. 무작위 통제 실험으로 실험군과 대조군의 다른 요인을 똑같이 맞출 수 없더라도, 회귀분석은 그 요인들을 모델에 넣는 것만으로 같은 일을 해냅니다. 데이터가 무작위가 아니어도 말입니다!
controls = ['IQ', 'exper', 'tenure', 'age', 'married', 'black',
            'south', 'urban', 'sibs', 'brthord', 'meduc', 'feduc']

X = wage[controls].assign(intercep=1)
t = wage["educ"]
y = wage["lhwage"]

beta_aux = regress(t, X)
t_tilde = t - X.dot(beta_aux)

kappa = t_tilde.cov(y) / t_tilde.var()
kappa0.041147191010057635방금 추정한 계수에 따르면, IQ, 경력, 근속 연수, 나이 등이 같은 사람들 사이에서는 교육을 1년 더 받는 것이 시간당 임금 4.11% 상승과 연관되어 있다고 기대할 수 있습니다. educ만 넣은 첫 번째 단순 모델이 편향되었을 것이라는 의심이 맞았던 셈입니다. 그 편향이 교육의 영향을 과대평가하고 있었다는 것도 확인됩니다. 다른 요인을 통제하자 추정된 교육의 영향이 줄어들었기 때문입니다.
모든 것을 직접 코딩하는 대신 다른 사람이 만든 소프트웨어를 쓰는 현명함을 발휘하면, 이 추정값에 신뢰구간까지 붙일 수 있습니다.
model_2 = smf.ols('lhwage ~ educ +' + '+'.join(controls), data=wage).fit()
model_2.summary().tables[1]| coef | std err | t | P>|t| | [0.025 | 0.975] | |
|---|---|---|---|---|---|---|
| Intercept | 1.1156 | 0.232 | 4.802 | 0.000 | 0.659 | 1.572 |
| educ | 0.0411 | 0.010 | 4.075 | 0.000 | 0.021 | 0.061 |
| IQ | 0.0038 | 0.001 | 2.794 | 0.005 | 0.001 | 0.006 |
| exper | 0.0153 | 0.005 | 3.032 | 0.003 | 0.005 | 0.025 |
| tenure | 0.0094 | 0.003 | 2.836 | 0.005 | 0.003 | 0.016 |
| age | 0.0086 | 0.006 | 1.364 | 0.173 | -0.004 | 0.021 |
| married | 0.1795 | 0.053 | 3.415 | 0.001 | 0.076 | 0.283 |
| black | -0.0801 | 0.063 | -1.263 | 0.207 | -0.205 | 0.044 |
| south | -0.0397 | 0.035 | -1.129 | 0.259 | -0.109 | 0.029 |
| urban | 0.1926 | 0.036 | 5.418 | 0.000 | 0.123 | 0.262 |
| sibs | 0.0065 | 0.009 | 0.722 | 0.470 | -0.011 | 0.024 |
| brthord | -0.0080 | 0.013 | -0.604 | 0.546 | -0.034 | 0.018 |
| meduc | 0.0089 | 0.007 | 1.265 | 0.206 | -0.005 | 0.023 |
| feduc | 0.0069 | 0.006 | 1.113 | 0.266 | -0.005 | 0.019 |
남은 질문은 이것입니다. 지금 추정한 매개변수는 인과적일까요? 안타깝게도 확실히 말할 수는 없습니다. 임금을 교육에 회귀한 첫 번째 단순 모델은 아마 인과적이지 않다고 주장할 수 있습니다. 교육과 임금 모두와 상관관계가 있는 중요한 변수들이 빠져 있기 때문입니다. 그 변수들을 통제하지 않으면, 추정한 교육의 영향에는 모델에 포함되지 않은 다른 변수들의 영향까지 섞여 들어갑니다.
이 편향이 어떻게 생기는지 더 잘 이해하기 위해, 교육이 임금에 영향을 미치는 실제 모델이 다음과 비슷하다고 가정해 봅시다.
\[ Wage_i = \alpha + \kappa \ Educ_i + \beta' A_i + u_i \]
임금은 교육의 영향을 받는데, 그 크기는 \(\kappa\)로 측정합니다. 그리고 \(A\)로 나타낸 능력이라는 추가 요인의 영향도 받습니다. 모델에서 능력을 빼면 \(\kappa\)의 추정값은 다음과 같아집니다.
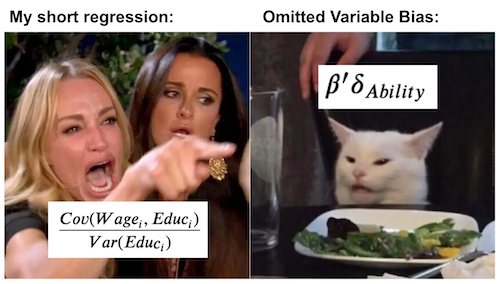
\[ \dfrac{Cov(Wage_i, Educ_i)}{Var(Educ_i)} = \kappa + \beta'\delta_{A} \]
여기서 \(\delta_{A}\)는 \(A\)를 \(Educ\)에 회귀해서 얻은 계수입니다.
핵심은 이 값이 우리가 원하는 \(\kappa\)와 정확히 같지 않다는 점입니다. 대신 \(\beta'\delta_{A}\)라는 성가신 항이 따라붙습니다. 이 항은 누락된 \(A\)가 \(Wage\)에 미치는 영향 \(\beta'\)에, 누락된 변수가 포함된 변수 \(Educ\)에 미치는 영향을 곱한 것입니다. 경제학자들에게는 이 결과가 너무나 중요해서, 조슈아 앵그리스트(Joshua Angrist)는 학생들이 명상하며 암송할 수 있도록 이를 주문으로 만들었습니다.
"Short equals long
plus the effect of omitted
times the regression of omitted on included"
여기서 짧은 회귀(short)는 변수를 누락한 회귀이고, 긴 회귀(long)는 그 변수들을 포함한 회귀입니다. 이 공식, 혹은 주문은 편향의 본질을 한층 깊이 들여다보게 해 줍니다. 첫째, 누락된 변수가 종속변수 \(Y\)에 아무 영향을 주지 않으면 편향 항은 0입니다. 지극히 당연한 이야기입니다. 교육이 임금에 미치는 영향을 알고 싶을 때 임금과 무관한 것(들판의 백합 키가 얼마나 되는지 같은 것)까지 통제할 필요는 없기 때문입니다. 둘째, 누락된 변수가 처치변수에 아무 영향을 주지 않을 때도 편향 항은 0입니다. 이 역시 직관적으로 납득이 갑니다. 교육에 영향을 주는 모든 것을 모델에 넣었다면, 추정한 교육의 영향에 ’임금에도 영향을 주는 다른 무언가와 교육 사이의 상관관계’가 섞여 들 여지가 없습니다.
좀 더 간결하게 말하면, 모든 교란 요인(confounder)을 모델에서 고려했다면 누락 변수 편향(OVB)은 없습니다. 여기서 인과 그래프에 관한 지식도 활용할 수 있습니다. 교란 요인은 처치와 결과 모두의 원인이 되는 변수입니다. 임금 예제에서는 IQ가 교란 요인입니다. IQ가 높은 사람은 공부가 더 쉬워서 교육을 더 오래 받는 경향이 있으니, IQ가 교육의 원인이라고 말할 수 있습니다. 또 IQ가 높은 사람은 타고난 생산성도 높아서 임금이 더 높은 경향이 있으므로, IQ는 임금의 원인이기도 합니다. 교란 요인은 처치와 결과 모두에 영향을 주는 변수이므로 T와 Y로 향하는 화살표로 표시합니다. 여기서는 교란 요인을 \(W\)로 나타냈습니다. 그리고 양의 인과관계는 빨간색, 음의 인과관계는 파란색으로 표시했습니다.
앵그리스트의 주문을 우리말로 옮기면 “짧은 회귀의 계수는 긴 회귀의 계수에, 누락 변수의 효과와 누락 변수를 포함된 변수에 회귀한 계수의 곱을 더한 것과 같다”입니다. 『실무로 통하는 인과추론 with 파이썬』에서는 짧은 회귀를 ’축소모델(short model)’이라고 부릅니다.
g = gr.Digraph()

g.edge("W", "T"), g.edge("W", "Y"), g.edge("T", "Y")

g.edge("IQ", "Educ", color="red"), g.edge("IQ", "Wage", color="red"), g.edge("Educ", "Wage", color="red")

g.edge("Crime", "Police", color="red"), g.edge("Crime", "Violence", color="red"),
g.edge("Police", "Violence", color="blue")

g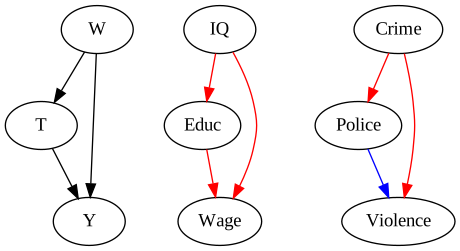
인과 그래프는 세상을 어떻게 이해하고 있는지 표현하고, 교란편향이 어떻게 작동하는지 이해하는 데 아주 좋은 도구입니다. 첫 번째 예시 그래프에서는 교육이 임금의 원인입니다. 교육을 더 받으면 임금이 높아집니다. 그런데 IQ도 임금의 원인이고, 동시에 교육의 원인이기도 합니다. IQ가 높으면 교육도 더 받고 임금도 높아집니다. 모델에서 IQ를 고려하지 않으면, IQ가 임금에 미치는 영향의 일부가 교육과의 상관관계를 타고 흘러듭니다. 그러면 교육의 영향이 실제보다 커 보이게 됩니다. 이것이 양의 편향(positive bias)의 예입니다.
이번에는 음의 편향(negative bias) 예시로, 경찰이 도시 폭력에 미치는 영향을 나타낸 인과 그래프를 생각해 봅시다. 현실에서는 경찰 인력이 많은 도시일수록 폭력 사건도 많은 경우를 흔히 봅니다. 그렇다면 경찰이 폭력을 일으킨다는 뜻일까요? 글쎄요, 그럴 수도 있겠지만 여기서 그 논쟁에 뛰어들 필요는 없을 것 같습니다. 다만 교란 요인 때문에 경찰이 폭력에 미치는 영향을 편향된 모습으로 보고 있을 가능성도 큽니다. 실제로는 경찰 인력을 늘리면 폭력이 줄어들 수도 있습니다. 하지만 세 번째 변수인 범죄가 폭력도 늘리고 경찰 인력도 늘립니다. 범죄를 고려하지 않으면 범죄가 폭력에 미치는 영향이 경찰 인력을 통해 흘러들어서, 경찰이 폭력을 늘리는 것처럼 보이게 됩니다. 이것이 음의 편향의 예입니다.
인과 그래프로 회귀분석과 무작위 통제 실험이 각각 어떻게 교란편향을 바로잡는지도 볼 수 있습니다. RCT는 교란 요인과 처치변수 사이의 연결을 끊어서 이 문제를 해결합니다. \(T\)를 무작위로 정하면, 정의상 그 무엇도 처치의 원인이 될 수 없기 때문입니다.
g = gr.Digraph()

g.edge("W", "Y"), g.edge("T", "Y")

g.edge("IQ", "Wage", color="red"), g.edge("Educ", "Wage", color="red")

g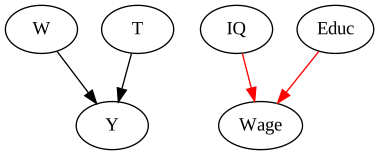
반면 회귀분석은 교란 요인 \(W\)를 일정한 수준에 고정한 채 \(T\)의 효과를 비교하는 방식으로 이 문제를 해결합니다. 회귀분석을 한다고 W가 더 이상 T와 Y의 원인이 아니게 되는 것은 아닙니다. 다만 W가 고정되어 있으니 T와 Y의 변화에 영향을 줄 수 없을 뿐입니다.
g = gr.Digraph()

g.node("W=w"), g.edge("T", "Y")
g.node("IQ=x"), g.edge("Educ", "Wage", color="red")

g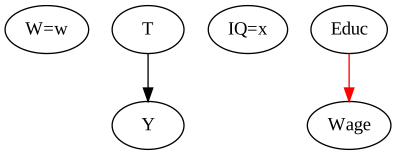
이제 원래 질문으로 돌아갑시다. educ가 임금에 미치는 영향으로 추정한 매개변수는 인과적일까요? 이런 말씀을 드려서 죄송하지만, 답은 모든 교란 요인을 모델에 포함했다는 주장을 얼마나 설득력 있게 펼치거나 반박할 수 있느냐에 달려 있습니다. 개인적으로는 다 포함하지 못했다고 생각합니다. 예를 들어 집안의 재산은 넣지 않았습니다. 부모의 교육 수준을 넣긴 했지만, 재산을 대신 보여 주는 대리변수에 불과합니다. 개인의 야망 같은 요인도 고려하지 않았습니다. 야망이 더 긴 교육 연수와 더 높은 임금을 모두 불러오는 원인일 수 있으니, 야망은 교란 요인입니다. 이 예시가 보여 주려는 것은 무작위가 아닌 데이터, 즉 관측 데이터로 하는 인과추론은 언제나 어느 정도 의심하며 신중하게 받아들여야 한다는 점입니다. 모든 교란 요인을 고려했다고 확신할 수는 결코 없습니다.
회귀분석으로 꽤 많은 내용을 다뤘습니다. 회귀분석으로 A/B 테스트를 하는 방법과, 회귀분석이 신뢰구간까지 편리하게 알려 준다는 것을 보았습니다. 이어서 회귀분석이 예측 문제를 푸는 방법이며 조건부 기댓값 함수(CEF)에 대한 최적의 선형 근사라는 것을 살펴보았습니다. 설명변수가 하나인 이변량의 경우, 회귀분석의 처치 계수는 처치와 결과의 공분산을 처치의 분산으로 나눈 값이라는 것도 이야기했습니다. 이를 다변량으로 확장하면서, 회귀분석이 처치 계수를 ’부분 제거(partialling out)’로 해석할 수 있게 해 준다는 것을 알아냈습니다. 다시 말해 처치 계수는 모델에 포함된 다른 모든 변수를 일정하게 유지할 때 처치에 따라 결과가 어떻게 변하는지로 해석할 수 있습니다. 경제학자들이 즐겨 쓰는 말로는 세테리스 파리부스(ceteris paribus), 곧 ’다른 모든 조건이 같다면’입니다.
마지막으로 편향을 이해하는 쪽으로 방향을 틀었습니다. Short equals long plus the effect of omitted times the regression of omitted on included를 살펴보았고, 덕분에 편향이 어떻게 생기는지 조금 더 분명해졌습니다. 누락 변수 편향의 원인이 교란, 즉 처치와 결과 모두에 영향을 주는 변수라는 것도 알아냈습니다. 끝으로 인과 그래프를 이용해 RCT와 회귀분석이 교란을 어떻게 해결하는지 살펴보았습니다.
저는 이 책 전체를 Joshua Angrist, Alberto Abadie, Christopher Walters의 훌륭한 계량경제학 강의에 바치는 헌사라고 생각합니다. 이 책에 담긴 아이디어 대부분은 이들이 미국경제학회(American Economic Association)에서 한 강의에서 가져왔습니다. 힘든 2020년을 버틸 수 있는 것도 이 강의들을 보는 덕분입니다. * Cross-Section Econometrics * Mastering Mostly Harmless Econometrics
Angrist의 멋진 책들도 참고 자료로 소개하고 싶습니다. 이 책들 덕분에 계량경제학, 이들 표현으로는 ’Metrics가 아주 유용할 뿐 아니라 무척 재미있다는 것을 알게 되었습니다.
마지막 참고 자료는 Miguel Hernan과 Jamie Robins의 책입니다. 까다로운 인과적 질문에 답해야 할 때마다 믿음직한 동반자가 되어 주었습니다.
Causal Inference for the Brave and True는 과학의 통계학이라 할 수 있는 인과추론을 다루는 오픈소스 자료입니다. 파이썬 기반의 무료 소프트웨어만 사용하며, 돈이 없어도, 배경지식이 많지 않아도 누구나 볼 수 있는 자료를 목표로 합니다. 이 책이 도움이 되었고 후원하고 싶다면 Patreon을 방문해 주세요. 금전적으로 기여하기 어렵다면 오타를 고치거나, 수정할 부분을 제안하거나, 이해하기 어려웠던 부분에 의견을 주는 것으로도 도울 수 있습니다. 책의 저장소에서 이슈를 열어 주세요. 마지막으로 이 내용이 마음에 들었다면 도움이 될 만한 사람들과 공유하고 GitHub에서 스타를 눌러 주세요.
한국어판의 오역이나 오탈자는 한국어판 이슈 페이지에 알려 주세요. 한국어판이 도움이 되었다면 한국어판 저장소에도 스타를 부탁드립니다.
의견 나누기
번역이 어색한 곳, 더 쉬운 설명, 궁금한 점을 남겨 주세요. GitHub 계정으로 로그인하면 댓글을 달 수 있고, 남긴 의견은 GitHub Discussions에 장별로 모입니다.