부록 E: 통제집단합성법의 컨포멀 추론

코드
import numpy as np
import pandas as pd
from toolz import curry
import seaborn as sns
from matplotlib import pyplot as plt
import statsmodels.formula.api as smf
import cvxpy as cp

import toolz as f

from sklearn.linear_model import Lasso
import warnings
warnings.filterwarnings('ignore')

from matplotlib import style
style.use("ggplot")

통제집단합성법 복습

통제집단합성법(synthetic control, SC)은 실험군이 하나뿐이고 대조군도 아주 적을 때 특히 유용한 인과추론 기법입니다. 대신 각 대상을 시간에 걸쳐 반복해서 관측한 데이터가 있어야 합니다(빅데이터 환경에 맞춘 확장 기법도 많이 있습니다). 대표적인 사용 사례는 한 지역(예를 들어 한 주)에 가한 처치의 효과를 알고 싶을 때 처치를 받지 않은 다른 주들을 대조군으로 쓰는 경우입니다. 통제집단합성법 장에서는 발의안 99호(1988년 캘리포니아에서 통과된, 담배세를 올린 법안)가 담배 판매량에 미친 효과를 추정하는 문제로 이 기법을 소개했습니다.

이 효과를 추정하려면 캘리포니아가 발의안 99호를 통과시키지 않았다면 어떻게 됐을지 추정해야 합니다. 결국 반사실(counterfactual) \(Y_{t}(0)\)를 추정해서 개입 이후 기간에 관측된 결과와 비교하는 문제로 귀결됩니다.

\[ ATT = Y_{t}(1) - Y_{t}(0) = Y_{t} - Y_{t}(0) \text{ for } t \geq 1988 \]

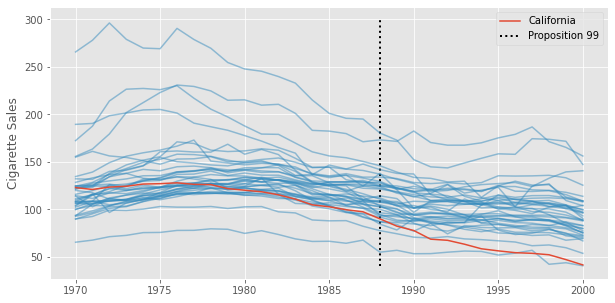
이를 위한 방법은 여러 가지인데, 그중 하나가 통제집단합성법입니다. 통제집단합성법은 여러 대조군 대상을 조합해 실험군 대상의 처치 전 움직임을 흉내 내도록 만들어서 실험군의 \(Y(0)\)를 모델링합니다. 이 예에서는 발의안 99호 이전 캘리포니아의 담배 판매 추세를 함께 근사하는 주들의 조합을 찾는다는 뜻입니다. 이렇게 하는 이유는 실험군과 같은 패턴을 따르는 대조군 대상이 거의 없기 때문입니다. 여러 주의 담배 판매 추세를 그려 보면 바로 알 수 있습니다. 캘리포니아와 추세가 비슷한 주가 하나도 없습니다.

data = pd.read_csv("data/smoking.csv")

data = data.pivot("year", "state", "cigsale")
data = data.rename(columns={c: f"state_{c}" for c in data.columns}).rename(columns={"state_3": "california"})
data.shape
(31, 39)
코드
plt.figure(figsize=(10,5))
plt.plot(data.drop(columns=["california"]), color="C1", alpha=0.5)
plt.plot(data["california"], color="C0", label="California")
plt.vlines(x=1988, ymin=40, ymax=300, linestyle=":", lw=2, label="Proposition 99", color="black")
plt.legend()
plt.ylabel("Cigarette Sales")
Text(0, 0.5, 'Cigarette Sales')

그래서 여러 대조군 대상을 조합합니다. 충분히 좋은 대조군이 없다면, 실험군 대상을 원하는 방식으로 닮은 가상의 대조군(synthetic control)을 직접 만들자는 것이 핵심입니다.

힌트옮긴이

이 셀 첫 문장의 원문은 ’combine multiple treated units’이지만, 문맥상 대조군 대상을 조합한다는 뜻이므로 그렇게 옮겼습니다.

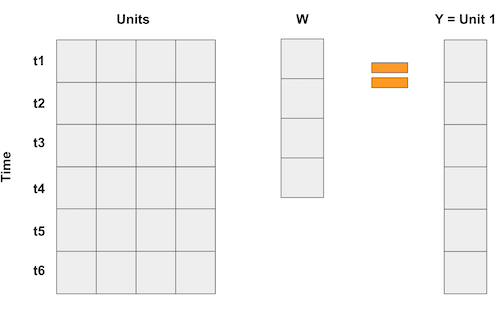
캘리포니아의 처치 전 추세를 가장 잘 근사하는 주의 조합을 찾기 위해, 통제집단합성법은 행이 기간이고 열이 주인 수평 회귀(horizontal regression)를 실행합니다. 대조군 주들에 곱했을 때 실험군 주를 가장 잘 근사하는 가중치를 찾는 것입니다.

기간보다 주의 수(39개, 일부는 분석에서 제외)가 더 많으므로 제약 없는 회귀분석은 과적합되고 맙니다. 그래서 통제집단합성법은 두 가지 제약을 둡니다.

  1. 가중치의 합은 1이어야 합니다.
  2. 가중치는 음수가 아니어야 합니다.

수식으로 쓰면, \(\pmb{y}\)를 처치 전 기간의 실험군 주 결과 벡터라고 하고, \(\pmb{X}\)를 각 열이 주 \(j\), 각 행이 개입 이전 기간 \(t\)인 \(J\)×\(T0\) 행렬이라고 합시다. 개입 시점은 \(T1 = T0 + 1\)입니다.

\[ \underset{w}{\mathrm{argmin}} \ ||\pmb{y} - \pmb{X} \pmb{w}|| \\ \text{s.t } \ \sum w_j = 1 \text{ and } \ w_j > 0 \ \forall \ j \]

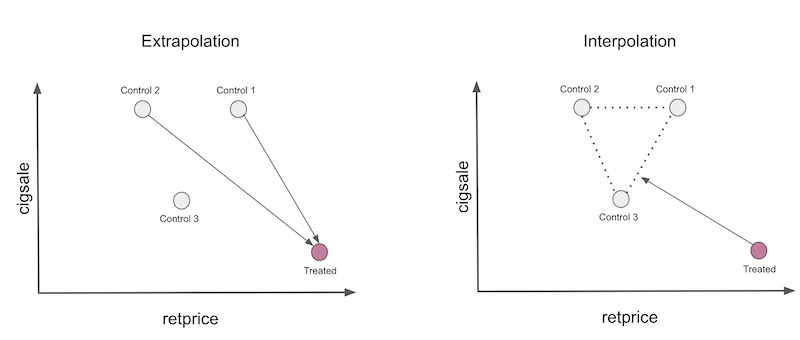
이 두 제약을 합치면 가상의 대조군을 대조군 대상들의 볼록 조합(convex combination)으로 정의하는 셈입니다. 위험한 외삽(extrapolation)을 전혀 하지 않는다는 뜻이자, 가상의 대조군이 소수의 대조군 대상만 쓴다는 뜻이기도 합니다.

이를 Sklearn 추정량 형태의 코드로 나타내면 다음과 같습니다.

from sklearn.base import BaseEstimator, RegressorMixin
from sklearn.utils.validation import check_X_y, check_array, check_is_fitted
import cvxpy as cp

class SyntheticControl(BaseEstimator, RegressorMixin):

    def __init__(self,):
        pass

    def fit(self, X, y):

        X, y = check_X_y(X, y)
    
        w = cp.Variable(X.shape[1])
        objective = cp.Minimize(cp.sum_squares(X@w - y))
        
        constraints = [cp.sum(w) == 1, w >= 0]
        
        problem = cp.Problem(objective, constraints)
        problem.solve(verbose=False)
        
        self.X_ = X
        self.y_ = y
        self.w_ = w.value
        
        self.is_fitted_ = True
        return self
        
        
    def predict(self, X):

        check_is_fitted(self)
        X = check_array(X)
        
        return X @ self.w_

이 방법을 데이터에 적용해 개입 이전 기간(1988년 전)에 적합해 봅시다.

model = SyntheticControl()

train = data[data.index < 1988]

model.fit(train.drop(columns=["california"]), train["california"]);

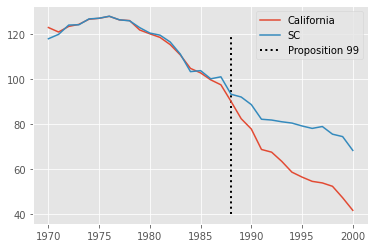
이제 캘리포니아의 추세와 방금 만든 가상의 대조군의 추세를 나란히 그려 볼 수 있습니다. 두 선의 차이가 캘리포니아에서 발의안 99호의 효과 추정값입니다.

코드
plt.plot(data["california"], label="California")
plt.plot(data["california"].index, model.predict(data.drop(columns=["california"])), label="SC")
plt.vlines(x=1988, ymin=40, ymax=120, linestyle=":", lw=2, label="Proposition 99", color="black")

plt.legend();

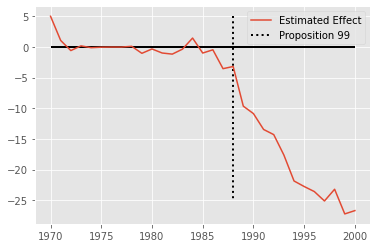
그래프만 보면 발의안 99호가 담배 판매량을 꽤 크게 줄인 것 같습니다.

코드
pred_data = data.assign(**{"residuals": data["california"] - model.predict(data.drop(columns=["california"]))})

plt.plot(pred_data["california"].index, pred_data["residuals"], label="Estimated Effect")
plt.hlines(y=0, xmin=1970, xmax=2000, lw=2, color="Black")
plt.vlines(x=1988, ymin=5, ymax=-25, linestyle=":", lw=2, label="Proposition 99", color="Black")

plt.legend();

어른을 위한 추론

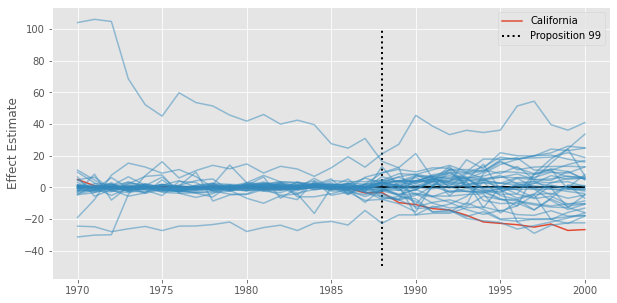
통제집단합성법 장에서는 대조군 대상을 실험군인 것처럼 가정하고 대상을 바꿔 가며 효과를 구하는 추론 절차를 보여 드렸습니다. 처치를 받지 않은 대상의 효과를 확인한다는 점에서 위약 검정(placebo test)이라고도 부릅니다. 실험군 대상의 효과 추정값이 대부분의 위약 효과보다 크면 이 효과 추정값이 유의하다고 말합니다.

코드
plt.figure(figsize=(10,5))
for state in data.columns:
    
    model_ier = SyntheticControl()
    train_iter = data[data.index < 1988]
    model_ier.fit(train_iter.drop(columns=[state]), train_iter[state])
    
    effect = data[state] - model_ier.predict(data.drop(columns=[state]))
    
    is_california = state == "california"
    
    plt.plot(effect,
             color="C0" if is_california else "C1",
             alpha=1 if is_california else 0.5,
             label="California" if is_california else None)

plt.hlines(y=0, xmin=1970, xmax=2000, lw=2, color="Black")
plt.vlines(x=1988, ymin=-50, ymax=100, linestyle=":", lw=2, label="Proposition 99", color="Black")
plt.ylabel("Effect Estimate")
plt.legend();

이 예에서는 캘리포니아의 처치 후 차이가 다른 주들에 비해 꽤 극단적입니다. 하지만 처치 전 적합이 형편없는 주도 몇 개 있고, 이런 주는 개입 이후 기간에 오차가 아주 커집니다. 처치 전 오차가 큰 대상은 빼라는 것이 일반적인 지침이지만, 얼마나 커야 큰 것인지는 조금 복잡한 문제입니다. 게다가 이 절차는 개입이 무작위로 배정됐다고 가정하는데, 이런 종류의 정책 개입에서는 믿기 어려운 가정입니다(Abadie, 2021 참고).

다른 추론 방법으로, 효과 추정 문제를 반사실 예측 문제로 바꿔서 볼 수 있습니다. 생각해 보면 지금 하려는 일은 결국 반사실 \(Y_{i, t}(0)\)를 예측하는 것입니다. 여기서 \(i\)는 실험군 대상이고 \(t \geq T1\), 즉 개입 이후 기간입니다. 이렇게 보면 추론을 위한 컨포멀 예측(conformal prediction) 문헌을 활용할 수 있습니다. 흥미롭게도 이 방법은 꽤 일반적이어서 \(Y_{i, t}(0)\)에 대한 다른 모델에도 적용할 수 있지만, 여기서는 통제집단합성법에만 집중하겠습니다.

이 절차를 이해하기 위해, 먼저 가설검정을 하고 p 값을 구하는 방법부터 살펴봅시다.

가설검정과 p 값

처치 이후 기간의 효과 궤적 \(\theta = (\theta_{T0+1}, ..., \theta_{T})\)에 대한 가설을 검정하고 싶다고 합시다.

\[ H_0 : \theta = \theta^0 \]

예를 들어 효과가 전혀 없는지 검정하고 싶다면 \(\theta^0 = (0, ..., 0)\)으로 두면 됩니다. 이 가설이 처치가 없을 때의 반사실적 결과를 완전히 결정한다는 점에 주목하세요.

\[ Y_t(0) = Y_t(1) - \theta_t = Y_t - \theta_t \]

핵심 아이디어는 검정하려는 귀무가설을 따르는 데이터를 만들고, 이렇게 만든 데이터에서 \(Y(0)\) 모델의 잔차를 확인하는 것입니다. 잔차가 너무 극단적이면, 이 데이터가 가정한 귀무가설에서 나왔을 가능성이 낮다고 말합니다. 처음에는 절차 전체가 모호하게 들리더라도 걱정하지 마세요. 단계별로 구현해 보면 분명해질 것입니다.

첫 단계는 귀무가설 아래의 데이터를 만드는 것입니다. 위 식처럼 실험군 대상의 결과에서 가정한 귀무가설 값을 빼기만 하면 됩니다. 코드는 다음과 같습니다.

def with_effect(df, state, null_hypothesis, start_at, window):
    window_mask = (df.index >= start_at) & (df.index < (start_at +window))
    
    y = np.where(window_mask, df[state] - null_hypothesis, df[state])
    
    return df.assign(**{state: y})
코드
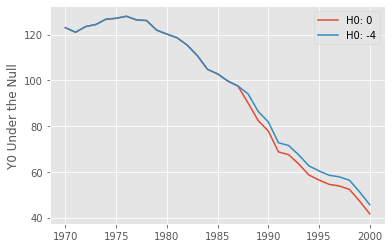
plt.plot(with_effect(data, "california", 0, 1988, 2000-1988+1)["california"], label="H0: 0")
plt.plot(with_effect(data, "california", -4, 1988, 2000-1988+1)["california"], label="H0: -4")

plt.ylabel("Y0 Under the Null")
plt.legend();

효과가 없다는 귀무가설을 가정하면, 그 귀무가설 아래의 데이터는 \(Y(0) = Y(1) = Y\)입니다. 즉 실험군인 캘리포니아에서 관측한 결과의 궤적 그대로입니다. 이번에는 귀무가설을 -4, 즉 발의안 99호가 담배 판매량을 4갑 줄인다고 가정하면 \(Y(0) = Y(1) - (-4)\)가 되어 처치 후 결과의 궤적이 +4만큼 위로 이동합니다. 아주 직관적입니다. 법안이 담배 판매량을 줄인다고 생각한다면, 법안이 없었을 때는 관측 데이터보다 담배 판매량이 더 높아야 하니까요.

추론 절차의 다음 단계는 방금 만든 함수로 얻은 반사실 \(Y(0)\)에 대한 모델을 처치 전과 처치 후 기간을 아우르는 전체 데이터로 적합하는 것입니다. 평소 가상의 대조군을 적합할 때와 크게 다른 점입니다. 개입 이후 잔차가 지나치게 커지지 않도록, 가정한 귀무가설 아래에서 전체 데이터로 모델을 추정해야 한다는 것이 이 방법의 아이디어입니다. 그다음 이 모델로 모든 기간 \(t\)에 대해 잔차 \(\hat{u_t} = Y_t - \hat{Y}_t(0)\)를 계산합니다.

이 일을 하는 함수는 먼저 앞에서 만든 with_effect 함수로 귀무가설 아래의 데이터를 만듭니다. 그다음 이 데이터로 모델을 적합합니다. 이어서 방금 적합한 모델로 예측해서 \(Y(0)\)를 추정합니다. 마지막으로 잔차 \(\hat{u}_t\)를 계산하고 모든 결과를 데이터프레임에 담습니다.

@curry
def residuals(df, state, null, intervention_start, window, model):
    
    null_data = with_effect(df, state, null, intervention_start, window)
            
    model.fit(null_data.drop(columns=[state]), null_data[state])
    
    y0_est = pd.Series(model.predict(null_data.drop(columns=[state])), index=null_data.index)
    
    residuals = null_data[state] - y0_est
    
    test_mask = (null_data.index >= intervention_start) & (null_data.index < (intervention_start + window))
    
    return pd.DataFrame({
        "y0": null_data[state],
        "y0_est": y0_est,
        "residuals": residuals,
        "post_intervention": test_mask
    })[lambda d: d.index < (intervention_start + window)]  # just discard  points after the defined effect window

이 데이터에서 \(H_0 : 0\), 즉 발의안 99호가 효과가 없었다는 귀무가설의 잔차를 구하려면 함수의 귀무가설 인자에 0을 넘기기만 하면 됩니다.

model = SyntheticControl()

residuals_df = residuals(data,
                         "california",
                         null=0.0,
                         intervention_start=1988,
                         window=2000-1988+1,
                         model=model)

residuals_df.head()
y0 y0_est residuals post_intervention
year
1970 123.000000 112.529475 10.470525 False
1971 121.000000 114.315723 6.684277 False
1972 123.500000 119.302289 4.197711 False
1973 124.400002 121.265554 3.134447 False
1974 126.699997 124.356696 2.343301 False

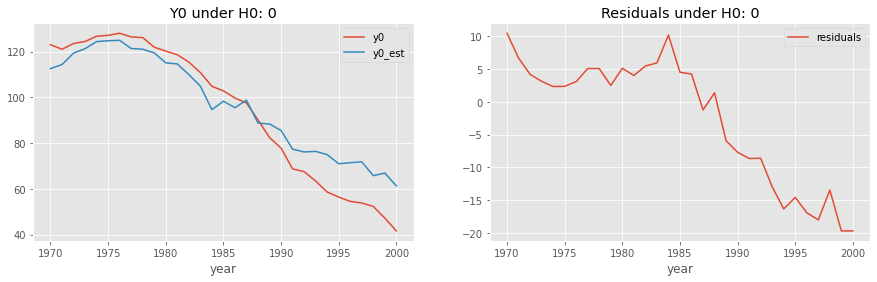
결과는 기간마다 추정한 잔차를 담은 데이터프레임이며, 앞으로 계속 이 결과를 사용합니다. 개입 이후 기간의 잔차가 너무 큰지 확인하는 것이 목적이라는 점을 기억하세요. 잔차가 너무 크다면 이 데이터가 효과가 0이라는 귀무가설에서 나왔을 가능성이 낮습니다. 무슨 이야기인지 눈으로 확인하기 위해 개입 이후 기간의 모델 오차를 살펴봅시다.

코드
fig, (ax1, ax2) = plt.subplots(1, 2, figsize=(15, 4))
residuals_df[["y0", "y0_est"]].plot(ax=ax1)
ax1.set_title("Y0 under H0: 0");
residuals_df[["residuals"]].plot(ax=ax2);
ax2.set_title("Residuals under H0: 0");

\(H_0: 0\) 아래에서 적합한 모델의 잔차가 음수 쪽으로 꽤 크다는 것이 벌써 보입니다. 효과가 없다는 귀무가설을 기각해야 할 수도 있다는 증거입니다.

검정통계량

이런 시각적 증거는 직관적으로 이해하는 데는 도움이 되지만, 조금 더 엄밀하게 따질 필요가 있습니다. 그래서 검정통계량(test statistic) S를 정의합니다. 검정통계량은 잔차가 얼마나 큰지, 따라서 귀무가설 아래에서 관측한 데이터가 나올 가능성이 얼마나 낮은지를 요약합니다.

\[ S(\hat{u})_q = \bigg(\sum_{t=T0 + 1}^{T} |u_t|^q \bigg) ^{1/q} \]

여기서는 \(q=1\)인 경우에 집중합니다. 그러면 \(S(\hat{u}) = \sum_{t=T0 + 1}^{T} |u_t|\)가 됩니다.

이 통계량은 \(t \geq T0 + 1\)인 개입 이후 기간만으로 계산한다는 점에 주목하세요. 반사실 \(Y(0)\) 모델은 전체 데이터로 적합하지만, 잔차는 귀무가설이 다루는 결과, 즉 개입 이후 기간에서만 확인합니다.

def test_statistic(u_hat, q=1, axis=0):
    return (np.abs(u_hat) ** q).mean(axis=axis) ** (1/q)
print("H0:0 ", test_statistic(residuals_df.query("post_intervention")["residuals"]))
H0:0  12.602929955114083

검정통계량이 크면 개입 이후 적합이 나쁘다는 뜻이고, 따라서 귀무가설을 기각합니다. 하지만 \(H_0\)가 참이더라도 모델이 잘 적합되지 않았다면 개입 이후 기간의 검정통계량이 꽤 클 수 있습니다. 그러니 ’크다’를 절대적인 기준으로 정할 수는 없습니다. 대신 개입 이후의 잔차와 검정통계량이 개입 이전의 잔차에 비해 얼마나 큰지를 따져야 합니다.

p 값

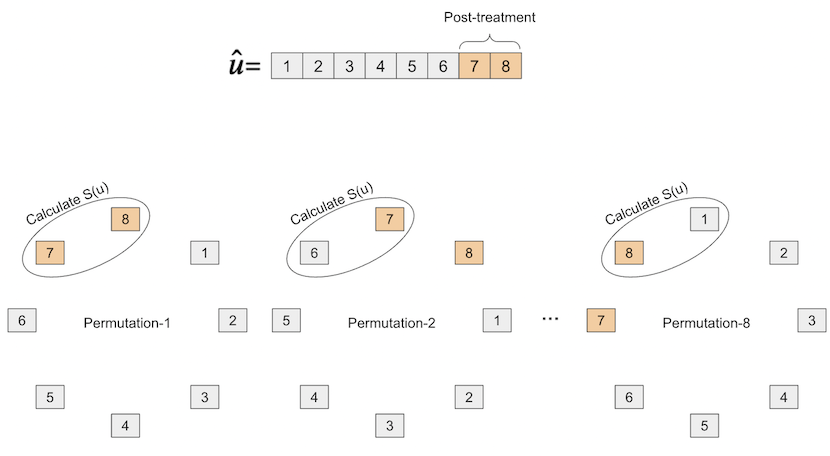
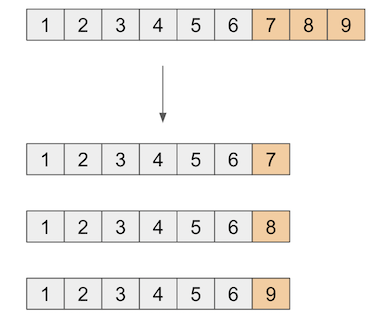
p 값을 계산하려면 잔차를 블록 순열(block permutation)하고, 순열마다 검정통계량을 계산합니다. 다음 그림을 보면 이 절차를 더 쉽게 이해할 수 있습니다.

이렇게 하면 블록 순열마다 하나씩, 모두 \(T\)개의 검정통계량을 얻습니다.

모든 블록 순열의 집합을 \(\Pi\)라고 하면, p 값의 정의에 따라

\[ \text{P-value} = \frac{1}{|\Pi|}\sum_{\pi \in \Pi} \mathcal{1}\{S(\hat{u}_{\pi_0}) \leq S(\hat{u}_{\pi})\} \]

입니다. 여기서 \(\hat{u}_{\pi_0}\)는 순열하지 않은 원래 잔차 벡터입니다. 쉽게 말해, 순열하지 않은 검정통계량이 가능한 모든 블록 순열로 얻은 검정통계량보다 큰(더 극단적인) 경우의 비율을 구하는 것입니다.

구현에는 np.roll 함수를 씁니다. 이 함수는 배열을 받아서 위 그림처럼 원형으로 돌립니다.

힌트옮긴이

식과 아래 p_value 함수가 실제로 세는 것은 순열한 검정통계량이 원래 검정통계량보다 크거나 같은 경우의 비율입니다. 원래 검정통계량이 순열 분포에서 상위 몇 %에 있는지를 나타낸다고 보면 됩니다.

def p_value(resid_df, q=1):
    
    u = resid_df["residuals"].values
    post_intervention = resid_df["post_intervention"].values
    
    block_permutations = np.stack([np.roll(u, permutation, axis=0)[post_intervention]
                                   for permutation in range(len(u))])
    
    statistics = test_statistic(block_permutations, q=1, axis=1)
    
    p_val = np.mean(statistics >= statistics[0])

    return p_val

이제 \(H_0: 0\)의 p 값을 계산할 수 있습니다. 보다시피 p 값이 낮긴 하지만 아주 낮지는 않습니다. \(\alpha=0.1\)에서는 효과가 없다는 이 귀무가설을 기각하지 않습니다.

p_value(residuals_df)
0.16129032258064516

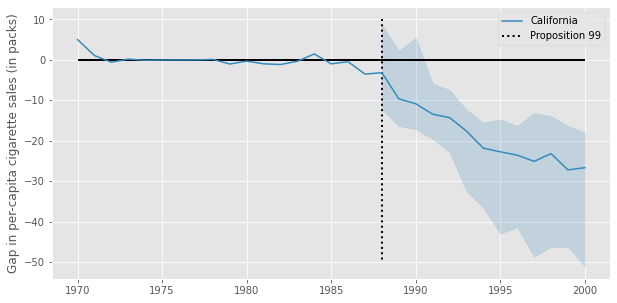
이 p 값은 모든 기간의 효과가 0이라는 귀무가설 \(\theta = (\theta_{T0+1}=0, ..., \theta_{T}=0)\)에 대한 것이라는 점을 기억하세요. 통제집단합성법으로 그린 효과 그래프를 보면 발의안 99호의 효과가 고정된 값이 아닌 것 같습니다. 처음에는 -5 정도로 작게 시작하지만 점점 커져서 -25까지 갑니다. 그래서 효과 궤적 전체에 대한 귀무가설 하나만 검정하기보다는, 처치 이후 기간마다 효과의 신뢰구간을 따로 그려 보는 편이 흥미로울 수 있습니다.

신뢰구간

처치 이후 각 기간의 효과에 신뢰구간을 두는 방법을 이해하기 위해, 먼저 한 기간의 신뢰구간을 어떻게 정의할지 생각해 봅시다. 기간이 하나뿐이라면 \(H_0\)는 궤적 벡터 \(\theta\)가 아니라 스칼라 값 하나로 정의됩니다. 따라서 \(H_0s\)를 촘촘하게 늘어놓고 귀무가설마다 p 값을 계산할 수 있습니다. 예를 들어 발의안 99호가 통과된 1988년의 효과가 -20에서 20 사이 어딘가라고 생각한다고 합시다. 그러면 -20부터 20까지 여러 \(H_0\)와 각각의 p 값을 담은 표를 만들 수 있습니다.

P-value(H_0: -20) = 0.01
P-value(H_0: -19) = 0.01
P-value(H_0: -18) = 0.02
...
P-value(H_0: 18) = 0.03
P-value(H_0: 19) = 0.03
P-value(H_0: 20) = 0.02

앞에서 정의한 함수로 이 표를 만들려면, 먼저 관심 있는 기간(이 예에서는 1988년)을 개입 이전 기간 끝에 이어 붙여 증강 데이터셋(augmented dataset)이라는 것을 만듭니다. 그다음 촘촘하게 늘어놓은 귀무가설들을 차례로 돌면서, 관심 기간에서 시작하는 길이 1짜리 개입 이후 구간의 p 값을 계산합니다.

def p_val_grid(df, state, nulls, intervention_start, period, model):
    
    df_aug = df[df.index < intervention_start].append(df.loc[period])
    
    p_vals =  {null: p_value(residuals(df_aug,
                                       state,
                                       null=null,
                                       intervention_start=period,
                                       window=1,
                                       model=model)) for null in nulls}        
        
    return pd.DataFrame(p_vals, index=[period]).T
model = SyntheticControl()

nulls = np.linspace(-20, 20, 100)

p_values_df = p_val_grid(
    data,
    "california",
    nulls=nulls,
    intervention_start=1988,
    period=1988,
    model=model
)

p_values_df
1988
-20.000000 0.052632
-19.595960 0.052632
-19.191919 0.052632
-18.787879 0.052632
-18.383838 0.052632
... ...
18.383838 0.052632
18.787879 0.052632
19.191919 0.052632
19.595960 0.052632
20.000000 0.052632

100 rows × 1 columns

보다시피 결과는 행 인덱스가 귀무가설이고 값이 p 값인 표입니다.

신뢰구간을 만들려면 p 값이 낮게 나온 \(H_0\)들을 걸러 내기만 하면 됩니다. p 값이 낮다는 것은 지금 가진 데이터가 그 귀무가설에서 나왔을 가능성이 낮다는 뜻입니다. 예를 들어 유의수준 \(\alpha\)를 0.1로 정했다면 p 값이 0.1보다 낮은 \(H_0\)들을 제거합니다.

def confidence_interval_from_p_values(p_values, alpha=0.1):
    big_p_values = p_values[p_values.values >= alpha]
    return pd.DataFrame({
        f"{int(100-alpha*100)}_ci_lower": big_p_values.index.min(),
        f"{int(100-alpha*100)}_ci_upper": big_p_values.index.max(),
    }, index=[p_values.columns[0]])
confidence_interval_from_p_values(p_values_df)
90_ci_lower 90_ci_upper
1988 -12.323232 8.686869

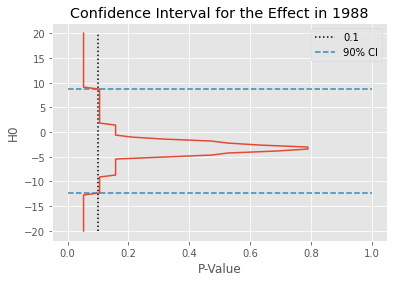
이렇게 1988년 효과의 신뢰구간을 얻습니다.

\(H_0\)별 p 값을 그래프로 그려 보면 이 신뢰구간이 어떻게 나왔는지 더 잘 이해할 수 있습니다. 아래 그림에서 점선은 앞에서 정한 \(\alpha\)인 0.1을 나타냅니다. 파란 선은 신뢰구간의 경계입니다. 이 선 바깥의 \(H_0\)는 p 값이 0.1보다 낮습니다.

코드
plt.plot(p_values_df[1988], p_values_df.index)
plt.xlabel("P-Value")
plt.ylabel("H0")
plt.vlines(0.1, nulls.min(), nulls.max(), color="black", ls="dotted", label="0.1")

plt.hlines(confidence_interval_from_p_values(p_values_df)["90_ci_upper"], 0, 1, color="C1", ls="dashed")
plt.hlines(confidence_interval_from_p_values(p_values_df)["90_ci_lower"], 0, 1, color="C1", ls="dashed", label="90% CI")

plt.legend()
plt.title("Confidence Interval for the Effect in 1988");

이제 남은 일은 위 절차를 기간마다 반복하는 것뿐입니다. 즉, 개입 이후 각 연도를 개입 이전 기간 끝에 이어 붙여 증강 데이터셋을 만들고, 앞에서 한 것과 똑같이 신뢰구간을 계산합니다.

def compute_period_ci(df, state, nulls, intervention_start, period, model, alpha=0.1):
    p_vals = p_val_grid(df=df,
                        state=state,
                        nulls=nulls,
                        intervention_start=intervention_start,
                        period=period,
                        model=model)
    
    return confidence_interval_from_p_values(p_vals, alpha=alpha)


def confidence_interval(df, state, nulls, intervention_start, window, model, alpha=0.1, jobs=4):    
    return pd.concat([compute_period_ci(df, state, nulls, intervention_start, period, model, alpha)
                     for period in range(intervention_start, intervention_start+window)])

이제 개입 이후 모든 기간의 신뢰구간을 계산할 준비가 됐습니다.

model = SyntheticControl()

nulls = np.linspace(-60, 20, 100)

ci_df = confidence_interval(
    data,
    "california",
    nulls=nulls,
    intervention_start=1988,
    window=2000 - 1988 + 1,
    model=model
)

ci_df
90_ci_lower 90_ci_upper
1988 -12.323232 8.686869
1989 -16.363636 2.222222
1990 -17.171717 5.454545
1991 -19.595960 -5.858586
1992 -22.828283 -7.474747
1993 -32.525253 -12.323232
1994 -36.565657 -15.555556
1995 -43.030303 -14.747475
1996 -41.414141 -16.363636
1997 -48.686869 -13.131313
1998 -46.262626 -13.939394
1999 -46.262626 -16.363636
2000 -51.111111 -17.979798
코드
plt.figure(figsize=(10,5))
plt.fill_between(ci_df.index, ci_df["90_ci_lower"], ci_df["90_ci_upper"], alpha=0.2,  color="C1")
plt.plot(pred_data["california"].index, pred_data["residuals"], label="California", color="C1")
plt.hlines(y=0, xmin=1970, xmax=2000, lw=2, color="Black")
plt.vlines(x=1988, ymin=10, ymax=-50, linestyle=":", color="Black", lw=2, label="Proposition 99")
plt.legend()
plt.ylabel("Gap in per-capita cigarette sales (in packs)");

참고 자료

이 부록은 Victor Chernozhukov, Kaspar Wüthrich, Yinchu Zhu의 논문 An Exact and Robust Conformal Inference Method for Counterfactual and Synthetic Controls를 바탕으로 썼습니다. 제가 가졌던 많은 궁금증을 풀어 준 Kaspar에게 특별히 감사드립니다.

통제집단합성법에 관한 추가 자료로는 Alberto Abadie(2021)의 Using Synthetic Controls: Feasibility, Data Requirements, and Methodological Aspects를 참고하세요.

기여하기

Causal Inference for the Brave and True는 과학의 통계학이라 할 수 있는 인과추론을 다루는 오픈소스 자료입니다. 파이썬 기반의 무료 소프트웨어만 사용하며, 돈이 없어도, 배경지식이 많지 않아도 누구나 볼 수 있는 자료를 목표로 합니다. 이 책이 도움이 되었고 후원하고 싶다면 Patreon을 방문해 주세요. 금전적으로 기여하기 어렵다면 오타를 고치거나, 수정할 부분을 제안하거나, 이해하기 어려웠던 부분에 의견을 주는 것으로도 도울 수 있습니다. 책의 저장소에서 이슈를 열어 주세요. 마지막으로 이 내용이 마음에 들었다면 도움이 될 만한 사람들과 공유하고 GitHub에서 스타를 눌러 주세요.
힌트옮긴이

한국어판의 오역이나 오탈자는 한국어판 이슈 페이지에 알려 주세요. 한국어판이 도움이 되었다면 한국어판 저장소에도 스타를 부탁드립니다.

의견 나누기

번역이 어색한 곳, 더 쉬운 설명, 궁금한 점을 남겨 주세요. GitHub 계정으로 로그인하면 댓글을 달 수 있고, 남긴 의견은 GitHub Discussions에 장별로 모입니다.