앞의 장들에서는 패널데이터(여러 대상을 여러 기간에 걸쳐 관측한 데이터)로 처치효과를 식별하는 방법으로 이중차분법(difference-in-differences, DID)과 통제집단합성법(synthetic control)을 살펴봤습니다. 그런데 이 두 접근법을 하나의 추정량으로 합칠 수 있습니다. 새로운 추정 방법인 합성 이중차분법(synthetic difference-in-differences, SDID)은 두 방법의 장점을 함께 살리면서 처치효과 추정값의 정밀도까지 높여 줍니다(오차 막대가 줄어듭니다).
이 장에서는 주로 블록 처치 배정(block treatment assignment) 상황에서 합성 이중차분법을 다룹니다. 여러 대상을 시간에 걸쳐 관측하는데, 일부 대상은 같은 시점에 처치를 받고 나머지 대상은 처치를 받지 않는 경우를 말합니다. 이 상황은 처치 배정 행렬 \(D\)로 나타낼 수 있는데, 이 행렬의 열은 대상이고 행은 기간입니다.
좀 더 구체적으로, 발의안 99호(Proposition 99)가 캘리포니아의 담배 소비에 미친 영향을 추정하는 예제를 따라가 보겠습니다. 이 예제에서 실험군은 캘리포니아 하나뿐이며, 캘리포니아는 어느 시점(정확히는 1988년 11월)에 처치를 받습니다(발의안 99호를 통과시킵니다). 캘리포니아를 행렬의 마지막 열이라고 하면 다음과 같은 행렬이 됩니다.
여기서는 모든 실험군이 같은 시점에 처치를 받는 경우만 다룬다는 점에 주의하세요. 장의 끝부분에서는 처치가 대상들에 점진적으로 도입되어 대상마다 처치 시점이 다른 시차 도입(staggered adoption) 처치 배정을 다루는 방법도 살펴봅니다. 이 설계에서 요구하는 조건은 단 하나, 어떤 대상이 한 번 처치를 받으면 다시 처치받지 않은 상태로 돌아가지 않는다는 것뿐입니다.
모든 대상이 같은 시점에 처치를 받는 단순한 경우로 돌아가면, 처치 배정 행렬을 네 개의 블록으로 단순화할 수 있고 각 블록은 또 하나의 행렬로 나타낼 수 있습니다. 일반적으로 행렬에서 아래로 내려갈수록 시간이 흐릅니다. 또한 실험군은 행렬의 오른쪽에 모아 둡니다. 그 결과 첫 번째 블록(왼쪽 위)은 처치 전 기간의 대조군, 두 번째 블록(오른쪽 위)은 처치 전 기간의 실험군, 세 번째 블록(왼쪽 아래)은 처치 후 기간의 대조군, 네 번째 블록(오른쪽 아래)은 처치 후 기간의 실험군에 해당합니다. 처치 지표는 처치 후 기간의 실험군 블록을 제외하면 모두 0입니다.
발의안 99호의 효과를 추정하는 예제에서 결과 \(Y\)는 담배 판매량입니다. \(pre\)와 \(post\)는 각각 처치 전 기간과 처치 후 기간을, \(co\)와 \(tr\)은 각각 대조군과 실험군을 나타냅니다.
통제집단합성법의 가중치를 추정하는 이야기를 할 때는 늘 위의 행렬 표현을 쓰겠지만, 특히 DID를 이야기할 때 유용한 데이터 표현이 하나 더 있습니다. 바로 열이 5개인 표입니다. 대상을 나타내는 열, 기간을 나타내는 열, 결과 열, 그리고 실험군과 처치 기간을 표시하는 불리언 열 두 개로 이루어집니다. 이 표의 행 수는 대상 수 \(N\)에 기간 수 \(T\)를 곱한 값입니다. 발의안 99호 데이터는 다음과 같은 모습입니다.
코드
import numpy as npimport pandas as pdfrom toolz import curry, partialimport seaborn as snsfrom matplotlib import pyplot as pltimport statsmodels.formula.api as smfimport cvxpy as cpimport warningswarnings.filterwarnings('ignore')from matplotlib import stylestyle.use("ggplot")pd.set_option('display.max_columns', 10)
이 표를 앞에서 이야기한 행렬 표현으로 바꾸려면 시간(연도)과 대상(주)을 기준으로 표를 피벗하기만 하면 됩니다. 앞으로 이 두 표현을 오가며 작업하겠습니다. 하나는 DID에, 다른 하나는 통제집단합성법 추정에 더 편리하기 때문입니다.
data_piv = data.pivot("year", "state", "cigsale")data_piv = data_piv.rename(columns={c: f"state_{c}"for c in data_piv.columns if c !="california"})data_piv.head()[["state_1", "state_2", "state_4", "state_38", "state_39", "california"]].round()
state
state_1
state_2
state_4
state_38
state_39
california
year
1970
90.0
100.0
125.0
106.0
132.0
123.0
1971
95.0
104.0
126.0
105.0
132.0
121.0
1972
101.0
104.0
134.0
109.0
140.0
124.0
1973
103.0
108.0
138.0
110.0
141.0
124.0
1974
108.0
110.0
133.0
112.0
146.0
127.0
잠재적 결과 관점에서 결과 행렬을 다시 보면 여기서 인과추론의 목표가 무엇인지 정리할 수 있습니다. 처치는 처치 기간 이후에 실험군에만 도입되므로, 오른쪽 아래 블록을 제외한 행렬의 모든 곳에서 잠재적 결과 \(Y_0\)를 관측합니다.
목표는 실험군에 대한 평균 처치효과 \(ATT = \pmb{Y}(1)_{post, tr} - \pmb{Y}(0)_{post, tr}\)를 추정하는 것입니다. 이를 위해서는 관측되지 않은 잠재적 결과 \(\pmb{Y}(0)_{post, tr}\)를 어떻게든 추정해야 합니다. 말로 풀면, 실험군이 처치를 받지 않았다면 처치 후 기간에 어떤 일이 일어났을지 알아야 합니다. 이 점을 염두에 두고 이중차분법과 통제집단합성법을 차례로 복습하는 것부터 시작하겠습니다. 언뜻 보면 두 방법은 관측되지 않은 잠재적 결과를 추정하려고 완전히 다른 일을 하는 것처럼 보입니다. 둘을 합친다니 확실히 이상하게 느껴집니다. 하지만 두 방법에는 생각보다 공통점이 많습니다.
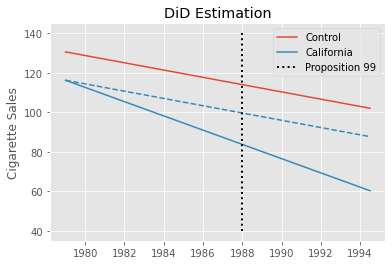
여기서 post는 처치 이후 기간임을 나타내는 시간 더미이고, treated는 실험군에 속한 대상임을 표시하는 대상 더미입니다. 캘리포니아 예제에서 이 모델을 추정하면 \(ATT\) 추정값으로 -27.34가 나옵니다. 발의안 99호의 효과가 강한 음수, 즉 발의안 99호 때문에 1인당 담배 소비량이 27갑 줄었다는 뜻입니다.
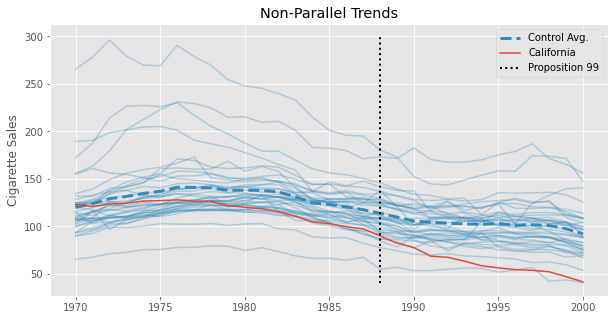
하지만 이 추정값을 곧이곧대로 받아들여서는 안 됩니다. 이중차분법은 처치가 없었을 때 대조군의 추세가 실험군의 추세와 같아야 한다는 조건을 요구합니다. 식으로 쓰면 \(E[Y(0)_{post, co} - Y(0)_{pre, co}] = E[Y(0)_{post, tr} - Y(0)_{pre, tr}]\)입니다. 검증할 수 없는 가정이지만, 캘리포니아(실험군)와 다른 주들의 처치 전 추세를 보면 이 가정이 얼마나 그럴듯한지 감을 잡을 수 있습니다. 구체적으로 캘리포니아의 cigsale 추세는 적어도 처치 전 기간에는 다른 주들과 평행하지 않습니다. 캘리포니아의 담배 판매량은 처치 전부터 이미 대조군 주들의 평균보다 빠르게 줄고 있습니다. 이 추세가 처치 전 기간 이후로도 이어진다면 DID 추정량에는 하향 편향이 생깁니다. 즉, 실제 효과는 위에서 추정한 값보다 덜 극단적입니다.
평행하지 않은 추세 문제를 해결하는 것이 바로 합성 이중차분법 모델에서 통제집단합성법이 맡는 역할입니다. 하지만 너무 앞서 나갔습니다. 위 데이터에 DID가 타당한 모델인지와는 별개로, DID의 흥미로운 점은 이원고정효과(two-way fixed effects, TWFE) 형태로 다시 쓸 수 있다는 것입니다. DID를 이렇게 표현하려면 처치 지표와 함께 대상 평균(\(\alpha_i\))과 시간 평균(\(\beta_t\))을 적합합니다.
이 식에서 대상 효과는 각 대상의 절편 차이를, 시간 효과는 실험군과 대조군 모두에 걸친 전반적인 추세를 포착합니다. 이를 구현하려면 모델에 시간 더미와 대상 더미를 추가하거나 데이터에서 평균을 제거하면 됩니다. 평균 제거 과정에서는 처치변수와 결과변수 모두에서 시간 평균과 대상 평균을 뺍니다.
보다시피 앞에서와 정확히 같은 매개변수가 나옵니다. 결국 두 접근법은 같은 DID 추정량을 다른 방식으로 바라본 것일 뿐입니다. 그런데 지금 목적에서 이 표현이 훨씬 흥미로운 이유는 DID가 사실 통제집단합성법과 꽤 비슷하다는 점을 드러내 주기 때문입니다. 위의 TWFE 식을 아주 자세히 보세요. 시간 효과와 대상 효과가 들어간 회귀 문제입니다. 그런데 최적화 목적함수에 가중치가 없다는 점에 주목하세요. 곧 보겠지만 이것이 이중차분법과 통제집단합성법의 가장 큰 차이입니다.
통제집단합성법 다시 보기
표준적인 통제집단합성법 추정량에서는 (공변량이 없는 상황이라면) 실험군의 처치 전 결과와, 대조군 처치 전 결과의 가중평균 사이의 차이를 최소화하는 대상(주) 가중치를 찾습니다. 또한 가중치가 모두 양수이고 합이 1이 되도록 제약합니다. 이 가중치를 찾으려면 다음 최적화 문제를 풉니다.
여기서 결과 \(\pmb{Y}_{pre, co}\)는 \(T_{pre}\) × \(N_{co}\) 행렬로, 열은 대상이고 행은 기간입니다. \(\pmb{w}_{co}\)는 대상마다 원소가 하나씩 있는 \(N_{co}\) × 1 열벡터입니다. 마지막으로 \(\pmb{\bar{y}}_{pre, tr}\)은 \(T_{pre}\) × 1 열벡터이고, 각 원소는 처치 전 기간의 각 시점에서 구한 실험군의 평균입니다. 그래서 통제집단합성법을 수평 회귀(horizontal regression)라고 부르기도 합니다. 대부분의 회귀 문제에서는 대상이 행렬의 행이지만, 여기서는 열입니다. 즉, 실험군의 평균 결과를 대조군 대상들에 회귀하는 셈입니다.
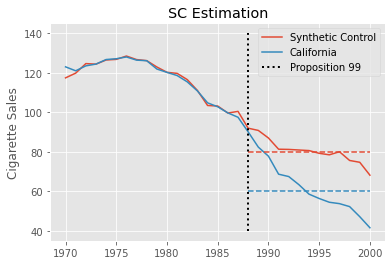
위 문제를 푸는 가중치를 찾으면, 모든 기간의 대조군에 이 가중치를 곱해서 실험군에 대한 가상의 대조군을 얻을 수 있습니다.
이 추정값은 이중차분법으로 얻은 값보다 훨씬 작습니다. 통제집단합성법은 평행하지 않은 처치 전 추세를 훨씬 잘 다루므로 이중차분법과 같은 편향에 빠지지 않습니다. 오히려 가상의 대조군을 빚어내는 과정 자체가 적어도 처치 전 기간에는 평행 추세를 강제합니다. 그 결과 훨씬 작고 훨씬 그럴듯한 추정값을 얻습니다.
캘리포니아의 실제 결과와 가상의 대조군의 결과를 함께 그려 보면 이 추정 과정을 눈으로 확인할 수 있습니다. 캘리포니아와 가상의 대조군 각각의 개입 후 평균도 점선으로 그렸습니다. 두 점선의 차이가 \(ATT\) 추정값입니다.
여기서 대조군의 가중치 \(\hat{w}^{sc}_i\)는 앞서 본 최적화 문제로 추정합니다. 실험군의 가중치는 단순히 \(1/N_{tr}\)입니다(균일 가중치).
이 식에서 통제집단합성법(SC)과 DID의 차이를 살펴보세요. 첫째, 통제집단합성법은 식에 대상 가중치(unit weights) \(\hat{w}^{sc}_i\)를 추가합니다. 둘째, 시간 고정효과 \(\beta_t\)는 있지만 대상 고정효과 \(\alpha_i\)도, 전체 절편 \(\mu\)도 없습니다.
두 식이 실제로 같은지 확인할 수 있도록 코드를 준비했습니다. 정확히 같은 \(ATT\) 추정값이 나옵니다.
보다시피 대상 고정효과 \(\alpha_i\)를 다시 넣었고, 대상 가중치 \(\hat{w}_i\)도 그대로 두었습니다. 그런데 새로운 것이 하나 있습니다. 바로 시간 가중치(time weights) \(\hat{\lambda}_t\)입니다. 걱정하지 마세요. 대단한 것은 아닙니다. 대상 가중치 \(w_i\)가 대조군과 실험군 평균 사이의 차이를 최소화했던 것을 떠올려 보세요. 다시 말해 대상 가중치는 실험군과 대조군의 처치 전 추세를 맞추는 데 쓰였습니다. 시간 가중치는 같은 일을 기간 쪽에서 합니다. 즉, 대조군에서 처치 전 기간과 처치 후 기간 사이의 차이를 최소화합니다.
다시 말하지만 \(\pmb{Y}_{pre, co}\)는 행이 기간, 열이 대상을 나타내는 \(T_{pre}\) × \(N_{co}\) 결과 행렬입니다. 하지만 이번에는 \(\bar{\pmb{y}}_{post, co}\)가 1 × \(N_{co}\) 행벡터이고, 각 원소는 해당 대조군 대상의 처치 후 기간 평균 결과입니다. 마지막으로 \(\pmb{\lambda}_{pre}\)는 처치 전 기간마다 원소가 하나씩 있는 1 × \(T_{pre}\) 행벡터입니다. 다른 각도에서 보면, 대상 가중치 \(w\)는 결과 행렬에 오른쪽에서 곱해졌습니다(\(\pmb{Y}_{pre, co} \pmb{w}_{co}\)). 그때는 실험군의 대상별 평균 결과를 대조군 대상들의 결과에 회귀했습니다. 이번에는 그 문제를 거꾸로 뒤집어서, 대조군의 처치 후 기간별 평균 결과를 같은 대조군 대상들의 처치 전 기간 결과에 회귀합니다.
처치 후 기간의 시간 가중치는 1을 처치 후 기간 수로 나눈 값 \(1/T_{post}\)로 둡니다(이번에도 균일 가중치입니다). 절편 \(\lambda_0\)도 있습니다. 절편을 두는 이유는 처치 후 기간이 모든 처치 전 기간보다 위에 있거나 아래에 있을 수 있게 하기 위해서입니다. 뚜렷한 상승 추세나 하락 추세가 있는 많은 응용 사례가 이런 경우입니다.
이 모든 내용이 다소 추상적으로 느껴진다면, 코드를 보면 무슨 일이 일어나는지 이해하는 데 도움이 될 것입니다.
def fit_time_weights(data, outcome_col, year_col, state_col, treat_col, post_col): control = data.query(f"~{treat_col}")# pivot the data to the (T_pre, N_co) matrix representation y_pre = (control .query(f"~{post_col}") .pivot(year_col, state_col, outcome_col))# group post-treatment time period by units to have a (1, N_co) vector. y_post_mean = (control .query(f"{post_col}") .groupby(state_col) [outcome_col] .mean() .values)# add a (1, N_co) vector of 1 to the top of the matrix, to serve as the intercept. X = np.concatenate([np.ones((1, y_pre.shape[1])), y_pre.values], axis=0)# estimate time weights w = cp.Variable(X.shape[0]) objective = cp.Minimize(cp.sum_squares(w@X - y_post_mean)) constraints = [cp.sum(w[1:]) ==1, w[1:] >=0] problem = cp.Problem(objective, constraints) problem.solve(verbose=False)# print("Intercept: ", w.value[0])return pd.Series(w.value[1:], # remove intercept name="time_weights", index=y_pre.index)
이 코드에서 가장 먼저 하는 일은 실험군을 걸러 내는 것입니다. 그런 다음 처치 전 데이터를 피벗해서 행렬 \(\pmb{Y}_{pre,co}\)를 만듭니다. 이어서 처치 후 데이터를 그룹화해 대조군 대상별로 처치 후 기간의 평균 결과를 구합니다. 그다음 \(\pmb{Y}_{pre,co}\)의 맨 위에 1로 채운 행을 추가해 절편 역할을 하게 합니다. 그리고 \(\bar{\pmb{y}}_{post, co}\)를 처치 전 기간들(\(\pmb{Y}_{pre,co}\)의 행)에 회귀해서 시간 가중치 \(\lambda_t\)를 얻습니다. 가중치의 합이 1이고 음수가 아니어야 한다는 제약도 추가했습니다. 마지막으로 절편은 버리고 시간 가중치를 시리즈에 저장합니다.
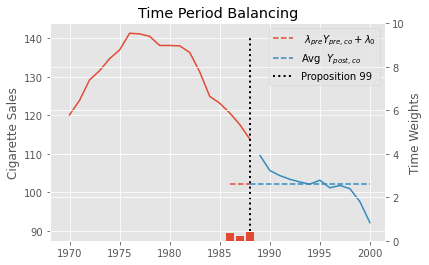
위 코드를 실행해 발의안 99호 문제의 시간 가중치를 구하면 다음과 같은 결과가 나옵니다. 1986, 87, 88년을 제외한 모든 기간의 가중치가 0입니다. 마지막 3개 기간의 가중평균만으로도 처치 전 기간과 처치 후 기간의 균형을 맞추기에 충분하다는 뜻입니다.
이 가중치의 역할을 좀 더 이해하기 위해, 처치 전 기간 중 가중치가 0이 되지 않은 구간에 \(\hat{\pmb{\lambda}}_{pre} \pmb{Y}_{pre, co} + \hat{\lambda}_0\)를 수평선으로 그려 보겠습니다. 그 옆에는 처치 후 기간의 평균 결과를 그립니다. 두 선이 완벽하게 맞아떨어지는 것을 볼 수 있습니다. 추정한 시간 가중치도 보조 축에 빨간 막대로 함께 나타냈습니다.
합성 이중차분법 추정량에서 시간 가중치 \(\lambda_t\)가 무엇이고 어떻게 추정하는지 배웠으니, 이제 대상 가중치 \(w_i\)로 눈을 돌려 보겠습니다. 아쉽게도 대상 가중치는 기존 통제집단합성법에서 얻는 가중치와 똑같지 않습니다. 첫 번째 차이는 여기서도 절편 \(w_0\)을 허용한다는 것입니다. 이제는 실험군과 가상의 대조군의 수준이 같을 필요가 없기 때문입니다. DID를 함께 쓸 것이므로 가상의 대조군과 실험군의 추세만 평행하게 만들면 됩니다.
두 번째 차이는 가중치에 \(L_2\) 페널티를 추가한다는 것입니다. 이 페널티 덕분에 소수의 대상만 가상의 대조군에 기여하는 대신, 0이 아닌 가중치가 여러 대조군 대상에 더 고르게 퍼집니다. \(L_2\) 페널티는 아주 큰 가중치가 생기지 않게 막아서 더 많은 대상을 쓰도록 강제합니다.
대상 가중치 자체에는 특별히 새로운 것이 없습니다. 시간 가중치를 추정하는 함수의 코드를 상당 부분 다시 쓸 수 있습니다. 이제는 문제가 위아래로 뒤집혔으니 차원에만 주의하면 됩니다.
def fit_unit_weights(data, outcome_col, year_col, state_col, treat_col, post_col): zeta = calculate_regularization(data, outcome_col, year_col, state_col, treat_col, post_col) pre_data = data.query(f"~{post_col}")# pivot the data to the (T_pre, N_co) matrix representation y_pre_control = (pre_data .query(f"~{treat_col}") .pivot(year_col, state_col, outcome_col))# group treated units by time periods to have a (T_pre, 1) vector. y_pre_treat_mean = (pre_data .query(f"{treat_col}") .groupby(year_col) [outcome_col] .mean())# add a (T_pre, 1) column to the begining of the (T_pre, N_co) matrix to serve as intercept T_pre = y_pre_control.shape[0] X = np.concatenate([np.ones((T_pre, 1)), y_pre_control.values], axis=1) # estimate unit weights. Notice the L2 penalty using zeta w = cp.Variable(X.shape[1]) objective = cp.Minimize(cp.sum_squares(X@w - y_pre_treat_mean.values) + T_pre*zeta**2* cp.sum_squares(w[1:])) constraints = [cp.sum(w[1:]) ==1, w[1:] >=0] problem = cp.Problem(objective, constraints) problem.solve(verbose=False)# print("Intercept:", w.value[0])return pd.Series(w.value[1:], # remove intercept name="unit_weights", index=y_pre_control.columns)
먼저 앞에서 정의한 함수로 \(\zeta\)를 계산하고 처치 후 기간을 걸러 냅니다. 그다음 처치 전 데이터를 피벗해 결과 행렬 \(\bar{\pmb{y}}_{pre, tr}\)을 만듭니다. 이어서 \(\bar{\pmb{y}}_{pre, tr}\) 행렬의 맨 앞에 1로 채운 열을 추가합니다. 이 열로 절편을 추정할 수 있습니다. 이렇게 준비를 마치면 가중치에 거는 \(L_2\) 페널티를 포함한 최적화 목적함수를 정의합니다. 마지막으로 절편은 버리고 추정한 가중치를 시리즈에 저장합니다.
이 코드로 발의안 99호 문제의 대상 가중치를 추정하면 처음 5개 주의 결과가 다음과 같이 나옵니다.
힌트옮긴이
코드에서 피벗해 만들고 맨 앞에 1로 채운 열을 붙이는 행렬은 대조군의 처치 전 결과 행렬(y_pre_control)이고, 실험군의 처치 전 평균 결과(y_pre_treat_mean)는 따로 그룹화해서 구합니다. 본문의 기호는 원문 표기를 그대로 옮겼습니다.
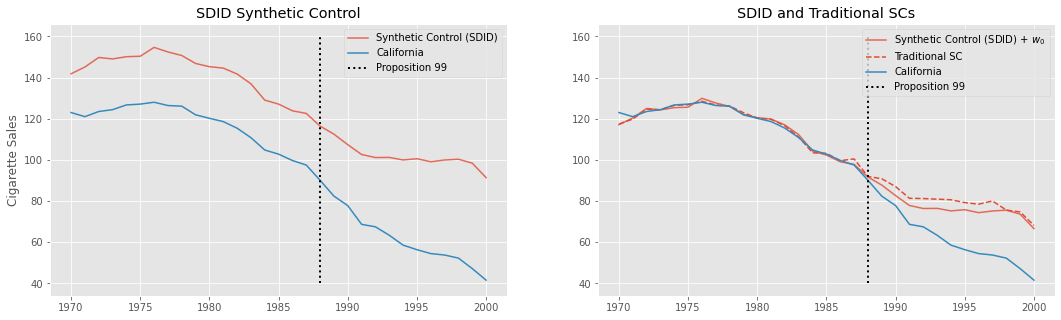
이 대상 가중치로도 가상의 대조군을 정의할 수 있으니 캘리포니아의 결과와 함께 그려 보겠습니다. 또한 앞에서 추정한 기존 가상의 대조군을, 방금 추정한 가상의 대조군에 절편 항을 더한 것과 나란히 그리겠습니다. 이렇게 하면 무슨 일이 일어나고 있는지, 방금 한 작업이 기존 통제집단합성법과 어떻게 다른지 감을 잡을 수 있습니다.
첫 번째 그래프에서 보듯이 가장 눈에 띄는 차이는 새 가상의 대조군이 더 이상 캘리포니아와 겹치지 않는다는 점입니다. 절편을 포함했기 때문입니다. 절편 덕분에 실험군은 가상의 대조군과 얼마든지 다른 수준에 있을 수 있습니다. 이 새로운 통제집단합성법은 실험군과 처치 전 추세가 같도록 만들어지지만, 수준까지 같을 필요는 없습니다.
두 번째 그래프에서는 앞에서 제거했던 절편을 다시 더해서 새 가상의 대조군을 옮깁니다. 그러면 실험군인 캘리포니아와 겹치게 됩니다. 비교를 위해 앞에서 적합한 기존 가상의 대조군을 빨간 점선으로 표시했습니다. 둘이 같지 않다는 것을 알 수 있습니다. 이 차이는 절편을 허용했다는 점과, 가중치를 0 쪽으로 끌어당긴 \(L_2\) 페널티 양쪽에서 비롯됩니다.
이제 시간 가중치 \(\hat{\lambda}_t\)와 대상 가중치 \(\hat{w}_t\)가 모두 있으니, 합성 이중차분법 추정량의 이중차분 부분을 실행할 수 있습니다. 이 단계에서는 데이터를 \(N\) × \(T\)개의 행으로 된 표 형식으로 다루는 편이 좋습니다. 이 표에는 주, 연도, 결과, 처치 후 기간 지표, 실험군 지표 열이 있습니다. 여기에 시간 가중치와 대상 가중치를 추가합니다. 시간 가중치는 시간을 인덱스로 하는 시리즈에, 대상 가중치는 대상을 인덱스로 하는 다른 시리즈에 들어 있으므로 모두 조인하기만 하면 됩니다.
이렇게 조인하면 실험군의 대상 가중치와 처치 후 기간의 시간 가중치가 null로 남습니다. 다행히 두 경우 모두 균일 가중치를 쓰므로 이 null을 채우기는 아주 쉽습니다. 시간 가중치는 처치 후 기간 더미의 평균인 \(1/T_{post}\)로, 대상 가중치는 실험군 더미의 평균인 \(1/N_{tr}\)로 채웁니다. 마지막으로 두 가중치를 곱합니다.
발의안 99호 데이터로 이 코드를 실행하면 다음과 같은 결과가 나옵니다.
힌트옮긴이
엄밀히 말하면 처치 후 기간 더미의 전체 평균은 1을 처치 후 기간 수로 나눈 값이 아니라 전체 기간 가운데 처치 후 기간이 차지하는 비율입니다(실험군 더미도 마찬가지입니다). 아래 두 코드 셀이 이 차이를 보여 주며, join_weights 함수는 실제로 1을 처치 후 연도 수(또는 실험군 수)로 나눈 값으로 채웁니다.
이 추정값은 이중차분법으로 얻은 값보다 훨씬 작지만 놀랄 일은 아닙니다. 앞서 이야기했듯이 이 예제에서는 평행 추세 가정을 의심할 만한 이유가 충분하므로 이중차분법 추정량은 아마 편향되어 있을 것입니다. 덜 분명한 것은 SDID 추정값이 왜 기존 통제집단합성법 추정값보다도 작은가 하는 점입니다. 앞의 통제집단합성법 그래프를 다시 보면, 캘리포니아의 담배 판매량이 발의안 99호 이전부터 가상의 대조군보다 낮아지기 시작했습니다. 이는 기존 통제집단합성법이 처치 전 기간 전체에 걸쳐 실험군과 대조군을 맞춰야 해서 이 연도 저 연도에서 조금씩 빗나가기 때문일 것입니다. SDID에서는 시간 가중치 덕분에 개입 후 기간과 더 비슷한 기간에만 집중할 수 있으므로 이 문제가 덜합니다. 이 예제에서는 그 기간이 바로 발의안 99호 직전 3년이었습니다.
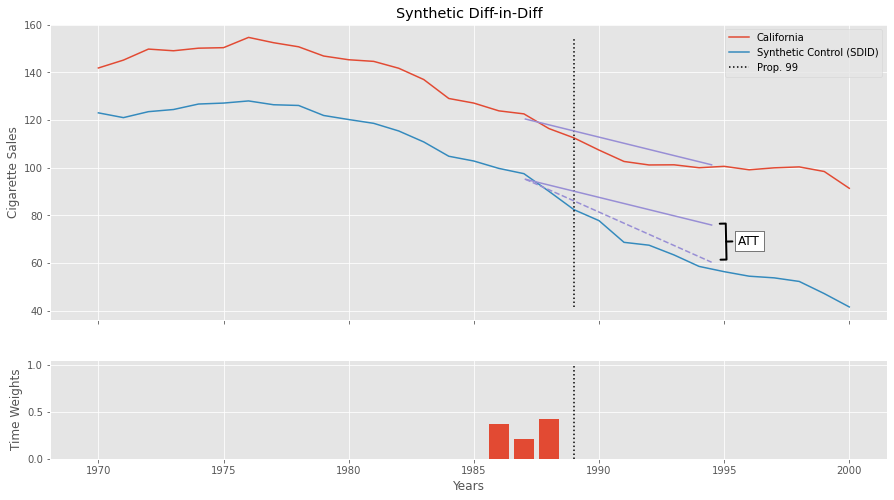
SDID가 하는 일을 이해하기 위해 실험군(캘리포니아)과 SDID 가상의 대조군의 이중차분 선을 그려 보겠습니다. 가상의 대조군에서 보이는 추세를 실험군에 투영해서 반사실(counterfactual) \(Y(0)_{tr, post}\)를 얻는다는 점에 주목하세요. 보라색 점선과 아래쪽 보라색 실선 사이의 차이가 \(ATT\)입니다. 시간 가중치가 1986, 87, 88년을 제외한 모든 기간을 0으로 만든다는 점을 보여 주려고 선을 1987년에서 시작했습니다. 시간 가중치는 아래쪽의 작은 그래프에도 나타냈습니다.
위의 추정량이 추정하는 \(ATT\)는 캘리포니아에 미친 발의안 99호의 효과를 처치 후 모든 기간에 걸쳐 평균한 값입니다. 그런데 위 그래프를 보면 효과가 시간이 지날수록 커지는 것 같습니다. 이 점을 반영하고 싶다면 어떻게 해야 할까요? 다행히 아주 간단합니다.
넘어가기 전에 위의 추정량과 관련해 주의할 점을 하나 말씀드리겠습니다. 방금 실행한 회귀분석이 보고하는 표준오차나 신뢰구간은 믿으면 안 됩니다. 가중치를 추정하면서 생기는 분산이 반영되어 있지 않기 때문입니다. 올바르게 추론하는 방법은 잠시 후에 살펴보고, 그 전에 시간에 따른 효과의 이질성을 다루는 방법부터 보겠습니다.
시간에 따른 효과 이질성과 시차 도입
다행히 SDID로 기간마다 효과를 하나씩 추정하기는 놀라울 만큼 쉽습니다. 기간마다 한 번씩, 여러 번 실행하기만 하면 됩니다. 좀 더 정확히 설명하기 위해 기간이 4개, 대상이 3개인 다음 처치 배정 행렬이 있다고 해 보겠습니다. 마지막 대상이 실험군입니다.
위 행렬로 SDID를 실행하면 기간 3과 4에 걸친 평균 \(ATT\)를 얻습니다. 각 기간의 효과를 따로 추정하려면 처치 후 기간마다 하나씩, 문제를 둘로 나누기만 하면 됩니다. 처치 후 기간 중 기간 3만 남긴 데이터로 SDID를 실행하고, 다시 기간 4만 남긴 데이터로 SDID를 실행하는 것입니다. 즉, 다음 두 행렬 각각에 SDID를 실행합니다.
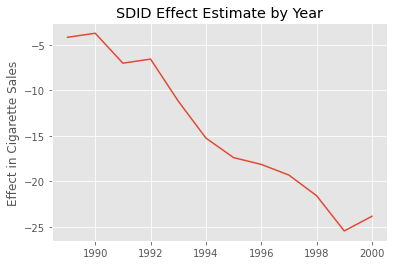
plt.plot(effects);plt.ylabel("Effect in Cigarette Sales")plt.title("SDID Effect Estimate by Year");
예상대로 효과는 시간이 지날수록 커집니다. 처음에는 작지만 점점 커져서 2020년에는 1인당 담배 소비량이 25갑 줄어든 것으로 보입니다.
편리하게도 SDID를 여러 번 실행하는 방식은 시차 도입 상황을 다룰 때도 중요합니다. 시차 도입 설계에서는 실험군이 여럿이고, 각 실험군이 서로 다른 기간에 처치를 받습니다. 예를 들어 대상 3개, 기간 4개로 된 아주 단순한 배정 행렬로 돌아가서, 대상 1은 처치를 전혀 받지 않고, 대상 2는 기간 4에, 대상 3은 기간 3에 처치를 받는다고 해 보겠습니다. 그러면 다음 행렬이 됩니다.
SDID는 이 행렬을 처리할 수 없습니다. 무엇이 처치 전 기간인지(두 번째 대상이라면 기간 4 이전, 세 번째 대상이라면 기간 3 이전), 무엇이 대조군인지(기간 3에 시작하는 처치에 대해서는 대상 2가 대조군이 될 수 있습니다) 명확하게 정의되지 않기 때문입니다. 이 문제를 푸는 열쇠는 행렬에서 열(대상)이나 행(기간)을 지워서 블록 배정 설계로 되돌릴 수 있다는 사실을 깨닫는 것입니다.
예를 들어 위 행렬에서 세 번째 기간을 지워 블록 행렬을 하나 만들고, 네 번째 기간을 지워 또 하나를 만들 수 있습니다.
그러면 블록 행렬이 두 개 생기므로 두 행렬 모두에 SDID를 실행할 수 있습니다. 그 결과로 \(ATT\) 추정값 두 개를 얻고, 이를 가중평균으로 합칠 수 있습니다. 가중치는 각 블록에 있는 처치 칸(처치받은 대상과 기간의 조합)의 비율입니다. 이 예에서 \(ATT_1\)의 가중치는 \(2/3\), \(ATT_2\)의 가중치는 1/3이 됩니다.
또는 열을 지워서 블록 설계 2개를 만들 수도 있습니다. 그러면 다음과 같은 행렬이 나옵니다.
여기서 \(D_1\)은 대상 1과 2로, \(D_2\)는 대상 1과 3으로 이루어져 있습니다.
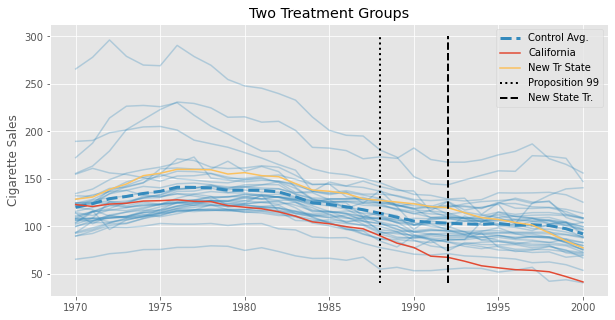
기간별로 SDID를 추정하는 방법은 이미 보았으니, 이번에는 대상을 걸러 내는 접근법을 살펴보겠습니다. 원래 발의안 99호 데이터는 시차 도입 설계가 아니므로 시뮬레이션으로 만들어 보겠습니다. 데이터에서 새로운 주 3개를 만들고, 이 주들이 1993년에 발의안 99호와 비슷한 법을 통과시켰다고 가정합니다. 캘리포니아의 성과에 감명받아 자기 주에서도 시도해 보고 싶었을지도 모릅니다. 이 주들이 통과시킨 법은 시행 후 매년 담배 소비를 3%씩 줄입니다. 무슨 일이 일어나는지 더 잘 이해하기 위해 새 주들의 평균 담배 소비량을 시각화해 보겠습니다. 검은 점선은 이 주들이 금연법을 통과시킨 연도입니다.
힌트옮긴이
원문의 몇 군데 오기를 바로잡거나 짚어 둡니다. 데이터는 2000년까지이므로 첫 문단의 2020년은 2000년의 오기로 보입니다(본문은 원문대로 두었습니다). 처치 전 기간을 설명하는 괄호에서 원문은 두 번 모두 ’두 번째 대상’이라고 썼고, 열을 지운 예에서는 두 번째 행렬이 ’대상 1과 4’로 이루어졌다고 썼지만, 문맥상 각각 세 번째 대상, 대상 1과 3이 맞아서 그렇게 옮겼습니다.
보다시피 주 그룹이 두 개 있습니다. 하나는 1989년부터 처치를 받은 캘리포니아만 있는 그룹이고, 다른 하나는 새로 만든 주 3개로 이루어진 그룹으로 모두 1993년부터 처치를 받았습니다. 이제 그룹마다 SDID를 실행해야 합니다. 대조군 대상에 그룹 하나만 더해서 남기면 쉽게 할 수 있습니다. 다만 함정이 하나 있습니다. after_treatment 열은 어떤 그룹을 보느냐에 따라 의미가 달라집니다. 캘리포니아만 있는 그룹을 볼 때는 after_treatment가 year >= 1989여야 하고, 새 주들로 이루어진 그룹을 볼 때는 year >= 1993이어야 합니다. 다행히 이 점은 아주 쉽게 반영할 수 있습니다. 반복할 때마다 after_treatment를 다시 만들기만 하면 됩니다.
staggered_effects = {year: synthetic_diff_in_diff(new_data .query(f"~treated|(state.isin({states}))") .assign(**{"after_treatment": lambda d: d["year"] >= year}), outcome_col="cigsale", year_col="year", state_col="state", treat_col="treated", post_col="after_treatment")for year, states in assignment_blocks.items()}staggered_effects
여기서는 처치 사례가 모두 36개입니다. 캘리포니아의 처치 후 기간 12개에, 새로 만든 실험군 주 3개 각각의 처치 기간 8개(1993~2000년)를 더한 값입니다. 따라서 첫 번째 \(ATT\)의 가중치는 \(12/36\), 두 번째 \(ATT\)의 가중치는 \(24/36\)이고, 이렇게 합치면 위의 결과가 나옵니다.
위약 분산 추정
장이 좀 길어지고 있지만 아직 지키지 못한 약속이 하나 남았습니다. 맨 처음에 SDID가 통제집단합성법보다 정밀도가 높다(오차 막대가 작다)고 했던 것을 기억하나요? SDID의 시간 고정효과와 대상 고정효과가 결과의 변동을 상당 부분 포착하고, 그 덕분에 추정량의 분산이 줄어들기 때문입니다.
물론 제 말만 믿으라고 하지는 않겠습니다. 이제 SDID 추정값의 신뢰구간을 구하는 방법을 보여 드리겠습니다. 이 문제에는 여러 해법이 있지만, 실험군이 하나뿐인 경우에 맞는 방법은 하나뿐입니다. 캘리포니아만 처치를 받았으니 지금이 바로 그런 경우입니다. 아이디어는 일련의 위약 검정(placebo test)을 실행하는 것입니다. 대조군 풀에서 실제로는 처치를 받지 않은 대상 하나를 처치받은 것처럼 꾸밉니다. 그런 다음 SDID로 이 위약 검정의 \(ATT\)를 추정하고 결과를 저장합니다. 매번 대조군 대상을 하나씩 뽑으면서 이 단계를 여러 번 반복합니다. 그러면 결국 위약 \(ATT\)의 배열을 얻게 됩니다. 이 배열의 분산이 SDID 효과 추정값의 위약 분산이며, 이를 이용해 신뢰구간을 만들 수 있습니다.
위 예에서는 주 39를 뽑았고, 이제 이 주가 처치를 받았다고 가정합니다. treated 열이 True로 바뀐 것을 확인할 수 있습니다.
다음으로 필요한 것은 이 위약 데이터로 SDID 추정값을 계산하는 과정을 여러 번 반복하는 것입니다. 다음 함수가 이 일을 합니다. 이 함수는 synthetic_diff_in_diff 함수를 실행해 SDID 추정값을 구하는데, 평소의 데이터 대신 make_random_placebo를 호출한 결과를 넘깁니다. 이를 여러 번 반복해서 SDID 추정값의 배열을 얻고, 마지막으로 이 배열의 분산의 제곱근, 즉 표준편차를 계산합니다.
Effect: -19.513629763998537
Standard Error: 11.2419349486209
90% CI: (-38.06282242922302, -0.9644370987740523)
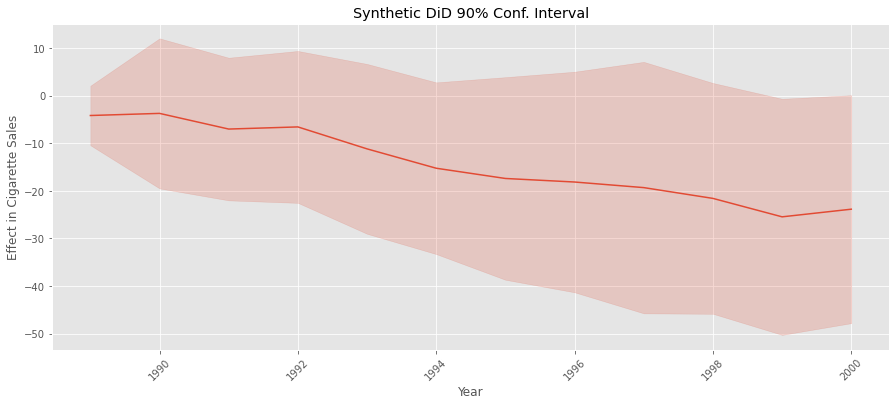
통제집단합성법의 오차가 SDID보다 크다는 점에 주목하세요. 다시 말하지만 SDID는 시간 고정효과와 대상 고정효과로 결과의 분산을 상당 부분 포착하기 때문입니다. 이로써 앞에서 한 약속을 지켰습니다. 다만 마무리하기 전에, 같은 분산 추정 절차로 처치 후 기간별로 추정한 효과에도 신뢰구간을 만들 수 있다는 점을 짚고 넘어가겠습니다. 기간마다 한 번씩 위 코드를 실행하기만 하면 됩니다. 앞에서 구현한 병렬 처리를 쓰더라도 실행에 시간이 꽤 걸릴 수 있다는 점은 염두에 두세요.
plt.figure(figsize=(15,6))plt.plot(effects, color="C0")plt.fill_between(effects.index, effects-1.65*standard_errors, effects+1.65*standard_errors, alpha=0.2, color="C0")plt.ylabel("Effect in Cigarette Sales")plt.xlabel("Year")plt.title("Synthetic DiD 90% Conf. Interval")plt.xticks(rotation=45);
핵심 요약
합성 이중차분법(SDID)은 이중차분법과 통제집단합성법 양쪽에서 아이디어를 가져왔고, 그 덕분에 두 모델의 장점을 함께 누립니다. SDID는 통제집단합성법처럼 처치 전 추세가 평행하지 않아도 여러 기간에 걸쳐 잘 작동합니다. 하지만 통제집단합성법과 달리, SDID는 실험군과 평행하기만 한(수준까지 맞출 필요는 없는) 대조 대상을 만들도록 대상 가중치를 추정합니다. SDID는 DID에서 시간 고정효과와 대상 고정효과를 가져오는데, 이 고정효과들이 결과의 분산을 많이 설명해 주므로 SDID 추정량의 분산이 줄어듭니다. 합성 이중차분법은 고유한 새 아이디어도 몇 가지 내놓습니다. 첫째, 대상 가중치를 최적화할 때 \(L2\) 페널티를 추가해 가중치가 대조군 대상들에 더 넓게 퍼지게 합니다. 둘째, 가중치를 만들 때 절편을 허용합니다(따라서 외삽도 허용합니다). 셋째, DID에도 SC에도 없는 시간 가중치를 사용합니다. 그래서 저는 SDID가 단순히 SC와 DID를 합친 것이라고 말하지 않겠습니다. 오히려 두 접근법에서 영감을 받아 새로운 것을 만들었다고 보는 편이 맞습니다. 또한 SDID가 기존 통제집단합성법보다 낫다거나 못하다고 말하지도 않겠습니다. 둘은 서로 다른 성질을 지니고 있어서 상황에 따라 적절할 수도, 그렇지 않을 수도 있습니다. 예를 들어 SDID가 허용하는 외삽이 위험한 상황에 놓일 수도 있습니다. 그럴 때는 SC가 좋은 대안이 될 수 있습니다.
힌트옮긴이
원문은 “SC와 SDID를 합친 것”이라고 썼지만 “SC와 DID”의 오기로 보고 그렇게 옮겼습니다.
참고 자료
이 장은 사실상 Dmitry Arkhangelsky, Susan Athey, David A. Hirshberg, Guido W. Imbens, Stefan Wager의 논문 Synthetic Difference in Differences (2019)를 풀어 쓴 해설입니다. 또한 SDID를 파이썬으로 구현한 pysynthdid의 저자 Masa Asami에게 감사를 전하고 싶습니다. 그의 코드 덕분에 제 코드에 버그가 없는지 확인할 수 있었고, 이는 정말 큰 도움이 되었습니다.
기여하기
Causal Inference for the Brave and True는 과학의 통계학이라 할 수 있는 인과추론을 다루는 오픈소스 자료입니다. 파이썬 기반의 무료 소프트웨어만 사용하며, 돈이 없어도, 배경지식이 많지 않아도 누구나 볼 수 있는 자료를 목표로 합니다. 이 책이 도움이 되었고 후원하고 싶다면 Patreon을 방문해 주세요. 금전적으로 기여하기 어렵다면 오타를 고치거나, 수정할 부분을 제안하거나, 이해하기 어려웠던 부분에 의견을 주는 것으로도 도울 수 있습니다. 책의 저장소에서 이슈를 열어 주세요. 마지막으로 이 내용이 마음에 들었다면 도움이 될 만한 사람들과 공유하고 GitHub에서 스타를 눌러 주세요.
의견 나누기
번역이 어색한 곳, 더 쉬운 설명, 궁금한 점을 남겨 주세요. GitHub 계정으로 로그인하면 댓글을 달 수 있고, 남긴 의견은 GitHub Discussions에 장별로 모입니다.