코드
import pandas as pd
import numpy as np
from matplotlib import pyplot as plt
import seaborn as sns앞 장에서는 직교화(orthogonalization)로 편향된 데이터셋을 처치가 무작위 배정이나 다름없어 보이는 데이터셋으로 바꾸는 방법을 살펴봤습니다. 처치와 결과를 각각 예측한 다음, 둘 다 예측의 잔차로 바꾸는 기법이었습니다.
\[ t^* = t - M_t(X) \]
\[ y^* = y - M_y(X) \]
이것만으로도 강력한 기법입니다. 처치가 연속형이든 이진형이든 모두 통합니다. 이번에는 성향점수(propensity score)를 바탕으로 한 또 다른 방법을 살펴보겠습니다. 성향점수는 처치가 이진형이거나 범주형일 때 가장 잘 정의되므로, 이 편향 제거(debiasing) 기법도 범주형이나 이진형 처치에만 쓸 수 있습니다. 그래도 상황에 따라서는 직교화보다 더 믿을 만하고, 충분히 배울 가치가 있습니다.
그 전에 맥락을 조금 바꿔야 합니다. 지금까지는 연속형 처치인 아이스크림 가격을 이야기했습니다. 이번에는 이진 처치인 마케팅 이메일을 살펴보겠습니다. 덧붙이자면, 연속형 처치를 구간으로 나눠 범주형처럼 만드는 것도 얼마든지 괜찮습니다(예를 들어 연속형인 가격을 2.00헤알(BRL) 간격으로 [2.00, 4.00, 6.00, 8.00]처럼 나눌 수 있습니다). 다시 이메일 이야기로 돌아가겠습니다.
상황은 이렇습니다. 여러분은 금융 회사에서 일합니다(제가 예시를 지어내는 재주가 영 없습니다. 죄송합니다). 이 회사는 당연하게도 생명보험, 예금 계좌, 투자 계좌 같은 금융 상품을 판매합니다. 회사는 새로운 금융 자문 서비스를 출시하면서 고객에게 홍보하려 합니다. 이를 위해 마케팅팀은 em1, em2, em3 세 가지 이메일을 시험해 봤습니다.
마케팅팀은 통계와 실험 설계를 잘 아는 사람들이라, 그냥 모두에게 이메일을 보내고 어떻게 되는지 지켜보지 않았습니다. 대신 고객마다 이메일을 받을 확률을 정하는 실험을 설계했습니다. 이 확률은 누가 이메일에 더 잘 반응할지 가늠하는 팀의 비즈니스 직관을 바탕으로 정했습니다. 예를 들어 em1은 투자를 많이 하지 않고 소득이 높지 않은 대중 시장 고객을 겨냥한 이메일입니다. 이런 고객은 em1을 받을 확률이 더 높습니다. 끝으로 이렇게 확률을 정한 뒤에는 처치 배정을 무작위로 해서, 고객이 각자 배정된 확률에 따라 이메일을 받게 했습니다.
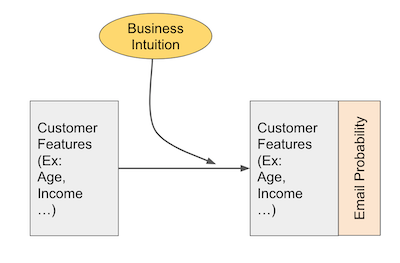
덧붙이자면, 비즈니스 전문성을 살려 타깃 고객을 고르면서도 마케팅 전략이 얼마나 효과적인지 타당하게 추론할 수 있는 방법으로는 이것이 제가 아는 최선입니다. 마케팅팀은 이 확률 함수에 따라 이메일을 배정했을 뿐 아니라 고객별 확률까지 저장해 두었습니다. 나중에 아주 요긴하게 쓰일 것입니다.
실험 데이터는 다음과 같습니다. 고객 속성은 네 가지로, 나이(age), 소득(income), 생명보험 가입액(insurance), 투자액(invested)입니다. 마케팅팀은 이 속성들로 고객이 각 이메일을 받을 확률을 정했습니다. 그 확률은 em1_ps, em2_ps, em3_ps 열에 저장되어 있습니다. 다음으로 em1, em2, em3 열에는 고객이 실제로 이메일을 받았는지가 들어 있습니다. 이것이 처치변수입니다. 마지막으로 결과변수 converted는 고객이 금융 자문 서비스에 가입했는지를 나타냅니다.
import pandas as pd
import numpy as np
from matplotlib import pyplot as plt
import seaborn as snsemail = pd.read_csv("./data/invest_email.csv")
email.head()| age | income | insurance | invested | em1_ps | em2_ps | em3_ps | em1 | em2 | em3 | converted | |
|---|---|---|---|---|---|---|---|---|---|---|---|
| 0 | 44.1 | 4214.66 | 14036.41 | 7988.66 | 0.118507 | 0.045174 | 0.921281 | 0 | 0 | 1 | 1 |
| 1 | 39.8 | 1151.27 | 66622.15 | 1000.74 | 0.431123 | 0.005659 | 0.000000 | 1 | 0 | 0 | 0 |
| 2 | 49.0 | 8047.26 | 14119.53 | 29480.22 | 0.062137 | 0.166706 | 0.840049 | 0 | 0 | 1 | 0 |
| 3 | 39.7 | 10558.37 | 14798.26 | 36373.09 | 0.047372 | 0.205684 | 0.000000 | 0 | 0 | 0 | 0 |
| 4 | 35.3 | 802.15 | 780.84 | 1643.16 | 0.616450 | 0.009292 | 0.000000 | 1 | 0 | 0 | 0 |
보다시피 em1을 받을 확률이 매우 낮은 고객이 있습니다. 2번 고객이 그런 경우로, 확률이 0.062밖에 되지 않습니다. 이 고객은 em1을 받지 않았다는 점도 눈여겨보세요. 이 이메일을 받을 확률이 아주 낮았으니 놀랄 일은 아닙니다.
이번에는 다음 고객들과 비교해 보세요. 모두 em1을 받을 확률이 매우 높았지만, 아무도 받지 않았습니다.
email.query("em1 == 0").query("em1_ps>0.9")| age | income | insurance | invested | em1_ps | em2_ps | em3_ps | em1 | em2 | em3 | converted | |
|---|---|---|---|---|---|---|---|---|---|---|---|
| 2438 | 48.0 | 538.02 | 26276.38 | 1582.82 | 0.913562 | 0.008951 | 0.999208 | 0 | 0 | 1 | 1 |
| 2692 | 44.2 | 545.62 | 2377.01 | 743.40 | 0.901065 | 0.004204 | 0.999047 | 0 | 0 | 1 | 0 |
| 3152 | 44.6 | 541.42 | 13272.96 | 1455.92 | 0.907929 | 0.008233 | 0.999136 | 0 | 0 | 1 | 1 |
| 4175 | 38.0 | 543.20 | 16787.28 | 1302.20 | 0.905007 | 0.007364 | 0.000000 | 0 | 0 | 0 | 1 |
성향점수를 이용한 편향 제거의 아이디어를 다시 정리해 보겠습니다(성향점수 장에서 이미 본 내용입니다). 바로 위와 같은 고객들이 무척 흥미롭습니다. 이들은 em1을 받은 고객과 아주 비슷합니다. 어쨌든 이메일을 받을 확률이 높았으니까요. 그런데도 이메일을 받지 않았습니다. 그래서 반사실적 결과(counterfactual outcome) \(Y_0|em1=1\)을 추정하는 데 안성맞춤인 후보입니다.
실험군(treated)처럼 보이지만 처치를 받지 않은 고객은 직관적으로 중요하게 다루고 싶습니다. 성향점수 편향 제거는 이 중요도를 수치로 반영합니다. 마찬가지로 대조군(untreated)처럼 보이지만 처치를 받은 고객에게도 높은 중요도를 줍니다. 아이디어는 아주 간단합니다. 각 대상에, 그 대상이 실제로 받은 처치 확률의 역수를 가중치로 주면 됩니다. 즉, 처치를 받은 대상에는 \(1/P(treatment=1)\)로 가중치를 줍니다. 처치를 받지 않은 대상에는 \(1/P(treatment=0)\), 즉 \(1/P(control)\)로 가중치를 줍니다. 처치가 이진형이라면 간단히 다음과 같습니다.
\[ W_i = \dfrac{T}{P(T=1|X)} + \dfrac{1-T}{1-P(T=1|X)} \]
처치가 여러 개라면 다음과 같이 일반화할 수 있습니다.
\[ W_i = \sum^K_{k=0} \dfrac{\mathcal{1}_{K=k} }{P(T=k|X)} \]
성향점수로 편향을 제거하는 방법을 대략 알았으니, 실제로 어떻게 작동하는지 확인해 보겠습니다. 하지만 먼저 데이터셋의 편향을 제거하지 않으면 어떻게 되는지 보겠습니다.
앞에서 말했듯이 처치는 고객의 특성, 즉 나이, 소득, 보험 가입액, 투자액과 교란되어 있습니다.
confounders = ["age", "income", "insurance", "invested"]상관관계 구조를 보면 이 변수들이 실제로 교란 요인(confounder)이라는 것을 알 수 있습니다. 처치 em1과도, 결과 converted와도 상관관계가 있습니다.
email[confounders + ["em1", "converted"]].corr()[["em1", "converted"]]| em1 | converted | |
|---|---|---|
| age | -0.058796 | 0.401759 |
| income | -0.305610 | -0.054009 |
| insurance | -0.023948 | -0.076234 |
| invested | -0.242374 | -0.030250 |
| em1 | 1.000000 | 0.046598 |
| converted | 0.046598 | 1.000000 |
이 교란편향을 고려하지 않으면 인과 추정값이 틀리게 됩니다. invested 변수를 예로 들어 보겠습니다. 투자를 적게 하는 고객일수록 전환할 가능성이 더 높고, 동시에 이메일을 받을 가능성도 더 높습니다. 그러니 투자액을 통제하지 않으면 em1이 전환 확률을 높이는 것처럼 보일 것입니다. 하지만 이는 인과관계가 아니라 그저 상관관계 때문일 수 있습니다. 투자액이 적으면 전환율도 높아지고 em1을 받을 확률도 높아지기 때문입니다.
교란 요인과의 상관관계 말고도, 이메일 em1을 받은 고객과 받지 않은 고객의 분포가 어떻게 생겼는지도 확인할 수 있습니다.
plt_df = pd.melt(email[confounders + ["em1"]], ["em1"], confounders)

g = sns.FacetGrid(plt_df, col="variable", hue="em1", col_wrap=4, sharey=False, sharex=False)

for i, ax in enumerate(g.axes):
    iter_df = plt_df.loc[lambda df: df["variable"] == confounders[i]]
    sns.kdeplot(x="value", hue="em1", data=iter_df, ax=ax, fill=True)
    ax.set_xlabel(confounders[i])

plt.show() 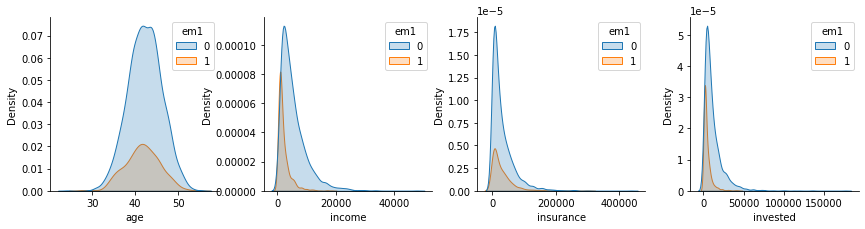
em1 배정이 실제로 편향되어 있다는 것을 확인했으니, 이제 성향점수로 편향을 제거해 보겠습니다. 마침 머릿속에 떠올랐을 법한 질문에 답하기 좋은 때입니다. 왜 그냥 직교화를 쓰면 안 될까요? 좀 더 점잖게 묻자면, 언제 직교화 대신 성향점수를 써야 할까요? 좋은 질문이고, 솔직히 말해 저도 모든 답을 알지는 못합니다. 하지만 성향점수를 써야 한다고 자신 있게 말할 수 있는 경우가 분명히 하나 있습니다.
실험을 진행하면서 처치를 받을 확률을 저장해 두었다면 모델을 추정하지 않고도 성향점수로 편향을 제거할 수 있습니다. 이메일을 확률적으로 배정했고 그 확률을 저장해 두었다면 모델에 기댈 필요가 없습니다. 엄청난 장점입니다. 모델은 결코 완벽하지 않고, 따라서 모델로 하는 편향 제거도 결코 완벽할 수 없기 때문입니다. 지금이 바로 그런 상황입니다. 처치 확률이 em1_ps, em2_ps, em3_ps 열에 저장되어 있습니다.
지금은 em1만 다루므로 편향 제거에는 em1_ps의 확률만 있으면 됩니다. 방법은 이렇습니다. 먼저 위에서 본 공식으로 편향 제거 가중치를 만듭니다. 그다음 새로 만든 가중치를 써서 이 데이터셋에서 복원추출(resample with replacement)을 합니다. 가중치가 2인 대상은 가중치가 1인 대상보다 두 배 자주 뽑힌다는 뜻입니다.
np.random.seed(123)
em1_rnd = email.assign(
    em1_w = email["em1"]/email["em1_ps"] + (1-email["em1"])/(1-email["em1_ps"])
).sample(10000, replace=True, weights="em1_w")np.random.seed(5)
em1_rnd.sample(5)| age | income | insurance | invested | em1_ps | em2_ps | em3_ps | em1 | em2 | em3 | converted | em1_w | |
|---|---|---|---|---|---|---|---|---|---|---|---|---|
| 2252 | 44.0 | 5102.43 | 42300.28 | 2294.60 | 0.097928 | 0.012976 | 0.902465 | 0 | 0 | 1 | 0 | 1.108559 |
| 4364 | 44.0 | 8503.72 | 751.08 | 33314.37 | 0.058805 | 0.188387 | 0.830375 | 1 | 0 | 0 | 1 | 17.005333 |
| 752 | 44.4 | 1778.21 | 24615.45 | 3054.08 | 0.279973 | 0.017270 | 0.972922 | 1 | 0 | 1 | 1 | 3.571777 |
| 3656 | 39.8 | 1752.18 | 487.22 | 1893.95 | 0.284108 | 0.010710 | 0.000000 | 0 | 0 | 0 | 0 | 1.396859 |
| 4613 | 43.1 | 1023.04 | 64695.01 | 2220.32 | 0.484638 | 0.012556 | 0.988928 | 0 | 0 | 1 | 1 | 1.940382 |
이렇게 다시 추출하면 편향이 제거된 새 데이터셋이 만들어질 것입니다. 실험군처럼 보이지만(em1_ps가 높지만) 처치를 받지 않은 대상과, 대조군처럼 보이지만(em1_ps가 낮지만) 처치를 받은 대상이 더 많이 뽑혔을 것입니다.
처치와 교란 요인 사이의 상관관계를 보면 사실상 사라진 것을 확인할 수 있습니다.
em1_rnd[confounders + ["em1", "converted"]].corr()[["em1", "converted"]]| em1 | converted | |
|---|---|---|
| age | -0.021004 | 0.404736 |
| income | -0.026685 | -0.037946 |
| insurance | -0.037656 | -0.071385 |
| invested | -0.012073 | -0.047987 |
| em1 | 1.000000 | 0.076342 |
| converted | 0.076342 | 1.000000 |
게다가 처치 배정에 따라 교란 요인의 분포를 나눠 보면 두 분포가 아주 잘 겹칩니다. 편향 제거가 제대로 됐다는 100% 증거는 아니지만, 좋은 근거는 됩니다.
plt_df = pd.melt(em1_rnd[confounders + ["em1"]], ["em1"], confounders)

g = sns.FacetGrid(plt_df, col="variable", hue="em1", col_wrap=4, sharey=False, sharex=False)

for i, ax in enumerate(g.axes):
    iter_df = plt_df.loc[lambda df: df["variable"] == confounders[i]]
    sns.kdeplot(x="value", hue="em1", data=iter_df, ax=ax, fill=True)
    ax.set_xlabel(confounders[i])

plt.show() 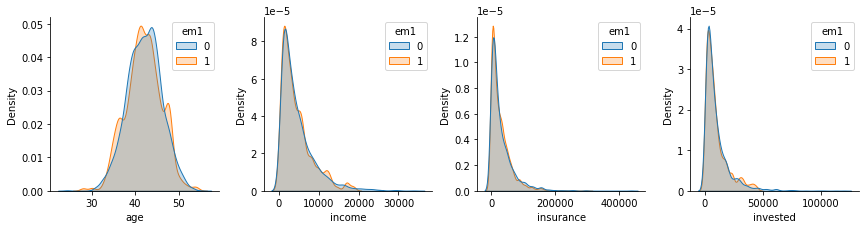
이제 새로 만든 데이터셋은 편향이 제거된 상태입니다. 모델 평가는 물론, 처치가 무작위로 배정되어 있어야 하는 다른 분석에도 쓸 수 있습니다. 주의할 점은 딱 하나입니다. 원래 데이터셋은 5000개뿐인데 10000개를 뽑았다는 점을 눈치챘나요? 이 재추출 방식으로는 편향 제거 데이터셋을 원하는 만큼 크게 만들 수 있습니다. 그래서 이 데이터셋에서 계산한 신뢰구간은 타당하지 않습니다. 표본 크기가 인위적으로 부풀려질 수 있다는 사실을 반영하지 않기 때문입니다.
좋습니다. 이 기법은 애초에 확률이 저장되어 있었기 때문에 효과가 아주 좋았습니다. 그런데 확률이 저장되어 있지 않다면 어떨까요? 교란 요인과 실제로 배정된 처치만 알고, 각 대상이 처치를 받을 가능성이 얼마였는지는 모른다면요?
성향점수가 저장되어 있지 않다면 추정해야 합니다. 이런 상황에서는 편향 제거에 성향점수를 써야 할지 직교화를 써야 할지가 덜 분명해집니다.
성향점수가 없으니 머신러닝 모델로 추정하겠습니다. 성향점수는 처치 확률과 밀접하게 관련되어 있으므로, 이 머신러닝 모델은 확률을 출력하도록 보정되어(calibrated) 있어야 합니다. 그뿐 아니라 과적합으로 생길 수 있는 편향을 피하려면 교차 예측(cross prediction)을 해야 합니다.
from sklearn.model_selection import cross_val_predict
from sklearn.ensemble import RandomForestClassifier
from sklearn.calibration import CalibratedClassifierCV

t = "em1"

folds = 5

np.random.seed(123)

# makes calibrated Random Forest.
m_t = CalibratedClassifierCV(
    RandomForestClassifier(n_estimators=100, min_samples_leaf=40, max_depth=3),
    cv=3
)

# estimate PS with cross prediction.
ps_score_m1 = cross_val_predict(m_t, email[confounders], email[t],
                                cv=folds, method="predict_proba")[:, 1]
email.assign(ps_score_m1_est = ps_score_m1).head()| age | income | insurance | invested | em1_ps | em2_ps | em3_ps | em1 | em2 | em3 | converted | ps_score_m1_est | |
|---|---|---|---|---|---|---|---|---|---|---|---|---|
| 0 | 44.1 | 4214.66 | 14036.41 | 7988.66 | 0.118507 | 0.045174 | 0.921281 | 0 | 0 | 1 | 1 | 0.104727 |
| 1 | 39.8 | 1151.27 | 66622.15 | 1000.74 | 0.431123 | 0.005659 | 0.000000 | 1 | 0 | 0 | 0 | 0.389991 |
| 2 | 49.0 | 8047.26 | 14119.53 | 29480.22 | 0.062137 | 0.166706 | 0.840049 | 0 | 0 | 1 | 0 | 0.083805 |
| 3 | 39.7 | 10558.37 | 14798.26 | 36373.09 | 0.047372 | 0.205684 | 0.000000 | 0 | 0 | 0 | 0 | 0.086290 |
| 4 | 35.3 | 802.15 | 780.84 | 1643.16 | 0.616450 | 0.009292 | 0.000000 | 1 | 0 | 0 | 0 | 0.737111 |
궁금하니 한번 살펴보면, 추정한 성향점수 ps_score_m1_est는 실제 성향점수 em1_ps와 가깝지만 똑같지는 않습니다. 추정 과정의 이런 오차는 최종 편향 제거에 영향을 주겠지만, 그 영향이 크지 않기를 바랄 뿐입니다. 점수가 얼마나 잘 보정되었는지도 확인할 수 있습니다. 평균 점수와 em1의 평균을 비교해 그려 보면 됩니다. 점수가 잘 보정되어 있다면 점수가 0.2인 고객 중 20%가, 점수가 0.3인 고객 중 30%가 이메일 1을 받았어야 합니다.
from sklearn.calibration import calibration_curve

prob_true, prob_pred = calibration_curve(email["em1"], ps_score_m1, n_bins=3)
plt.plot(prob_pred, prob_true, label="Calibrated RF")
plt.plot([.1,.8], [.1, .8], color="grey", linestyle="dashed", label="Perfectly Calibrated")
plt.ylabel("Fraction of Positives")
plt.xlabel("Average Prediction")
plt.legend();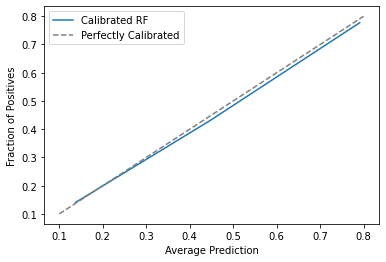
여기서부터는 실제 성향점수가 있을 때와 똑같이 진행하면 됩니다.
np.random.seed(123)
em1_rnd_est = email.assign(
    em1_w = email["em1"]/ps_score_m1 + (1-email["em1"])/(1-ps_score_m1)
).sample(10000, replace=True, weights="em1_w")
상관관계 구조를 확인해 보면, 편향 제거 과정을 거친 뒤에도 처치와 교란 요인 사이에 여전히 상당한 상관관계가 남아 있습니다. 예를 들어 소득의 상관계수는 -0.18입니다. 편향된 원래 데이터셋의 상관계수(-0.3)보다는 작지만, 원래 성향점수로 편향을 제거한 데이터셋에서 얻은 값(0.01)보다는 훨씬 큽니다. invested 변수도 마찬가지로 여전히 어느 정도 상관관계를 보입니다.
원문은 이 데이터셋을 “unbiased dataset”이라고 썼지만, 편향을 제거하기 전 원래 데이터를 가리키므로 “편향된 원래 데이터셋”으로 옮겼습니다.
em1_rnd_est[confounders + ["em1"]].corr()["em1"]age -0.030409
income -0.150937
insurance -0.037893
invested -0.111138
em1 1.000000
Name: em1, dtype: float64plt_df = pd.melt(em1_rnd_est[confounders + ["em1"]], ["em1"], confounders)
g = sns.FacetGrid(plt_df, col="variable", hue="em1", col_wrap=4, sharey=False, sharex=False)
for i, ax in enumerate(g.axes):
iter_df = plt_df.loc[lambda df: df["variable"] == confounders[i]]
sns.kdeplot(x="value", hue="em1", data=iter_df, ax=ax, fill=True)
ax.set_xlabel(confounders[i])
plt.show() 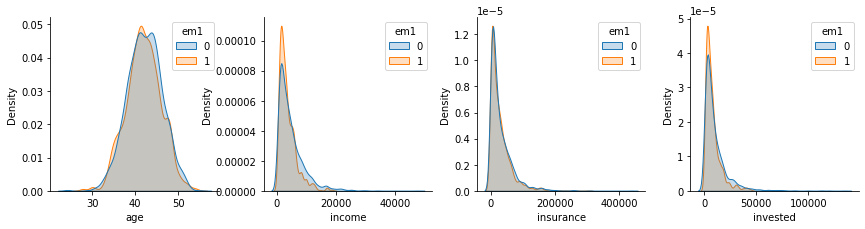
분포도 앞에서만큼 잘 겹치지 않습니다. 특히 invested와 income 변수가 그렇습니다.
성향점수 장에서 이미 많이 이야기했으니 길게 다루지는 않겠습니다. 다만 성향점수 편향 제거의 주요 약점 하나는 다시 짚어 둘 만합니다. 성향점수가 지나치게 높거나 낮은 경우와 관련된 문제입니다.
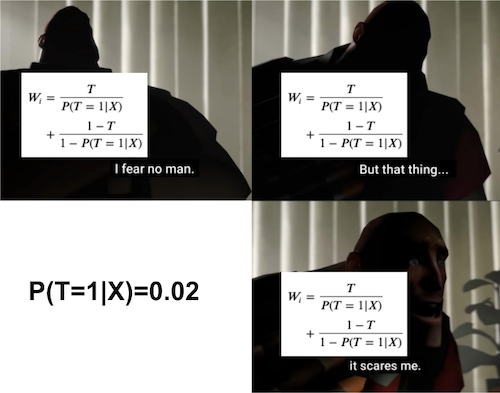
이 문제를 이해하기 위해 원래 데이터셋에 있는 다음 대상을 보겠습니다.
email.loc[[1014]]| age | income | insurance | invested | em1_ps | em2_ps | em3_ps | em1 | em2 | em3 | converted | |
|---|---|---|---|---|---|---|---|---|---|---|---|
| 1014 | 43.2 | 18628.09 | 30356.68 | 28335.68 | 0.026862 | 0.160233 | 0.615788 | 1 | 0 | 0 | 1 |
이 대상은 em1의 성향점수가 0.027입니다. 따라서 가중치는 약 37(1/0.027)이 됩니다. 성향점수가 0.05인 실험군 대상(가중치 20)과 비교해도 거의 두 배나 자주 뽑힐 텐데, 0.05도 이미 아주 낮은 성향점수입니다. 실제로 저장된(추정하지 않은) 성향점수로 다시 추출한 데이터셋에서 이 대상은 38번 나타납니다.
em1_rnd.loc[[1014]].shape(38, 12)이것이 문제인 이유는 편향 제거 데이터셋에 대상 하나가 지나치게 많이 들어가기 때문입니다. 이 대상이 원래 데이터셋에 없었다면 편향 제거 데이터셋은 완전히 다르게 보였을 수도 있습니다. 즉, 대상 하나만 빼도 편향 제거 데이터셋의 모습이 크게 달라질 수 있습니다. 바로 분산이 크다는 문제입니다.
편향 제거 데이터셋에서 대상별로 몇 번씩 복제되었는지 그려 보면, 10번 넘게 나타나는 대상이 꽤 많습니다. 성향점수가 낮은 실험군 대상이거나 성향점수가 높은 대조군 대상입니다.
plt.figure(figsize=(10,5))
sns.scatterplot(
    data=em1_rnd.assign(count=1).groupby(em1_rnd.index).agg({"count":"count", "em1_ps": "mean", "em1": "mean"}),
    x="em1_ps",
    y="count",
    hue="em1",
    alpha=0.2
)
plt.title("Replications on Debiased Data");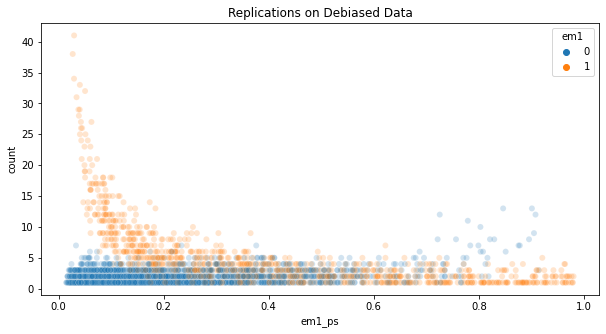
지나치게 중요한 대상이 생기지 않도록 가중치를 잘라내서(clip), 예컨대 최대 20을 넘지 않게 하는 과학자들도 있습니다. 이 기법이 분산을 일부 줄여 주는 것은 사실이지만, 그 대신 편향을 다시 끌어들입니다. 애초에 편향을 없애려고 한 일이니, 가중치를 잘라내는 것은 좋은 생각이 아니라고 봅니다.
제 생각에 가장 좋은 방법은 분석 단계가 아니라 실험 단계에서 손을 쓰는 것입니다. 가중치가 지나치게 큰 대상이 하나도 없도록 해야 합니다. 다시 말해 가능한 한 모두에게 같은 확률로 처치를 주도록 해 보세요.
성향점수 가중치 방법의 편을 조금 들어 주자면, 전체 표본이든 일부 하위 집단이든 처치를 받을 확률이나 받지 않을 확률이 너무 낮으면 어떤 인과추론 방법이든 어려움을 겪습니다. 직관적으로 말하면, 어떤 대상은 처치를 거의 받지 못하거나 반대로 거의 언제나 받으므로, 그 대상의 반사실을 추정하기 어렵다는 뜻입니다. 이 문제는 공통 지지 가정을 거의 위반하는 것으로 볼 수 있는데, 바로 다음에서 살펴보겠습니다.
분산이 큰 문제 말고도 양수성 문제가 생길 수 있습니다. 양수성(positivity) 또는 공통 지지(common support)는 실험군과 대조군의 특성이 충분히 겹쳐야 한다는 인과추론의 가정입니다. 달리 말해 누구든 처치를 받을 확률과 받지 않을 확률이 모두 0이 아니어야 합니다. 그렇지 않으면 전체 모집단에 대해 타당한 인과효과를 추정할 수 없고, 공통 지지가 있는 대상에 대해서만 추정할 수 있습니다.
분명히 해 두자면, 양수성 문제는 성향점수 방법의 문제가 아니라 데이터 자체의 문제입니다. 성향점수 방법은 양수성 문제가 있을 때 이를 아주 분명하게 드러낼 뿐입니다. 그런 의미에서 이 점은 오히려 성향점수에 유리한 논거입니다. 대부분의 방법은 양수성 문제가 있어도 경고해 주지 않지만, 성향점수는 문제를 눈앞에 들이밉니다. 실험군과 대조군의 성향점수 분포를 그려 보기만 하면 됩니다.
sns.displot(data=email, x="em1_ps", hue="em1")
plt.title("Positivity Check");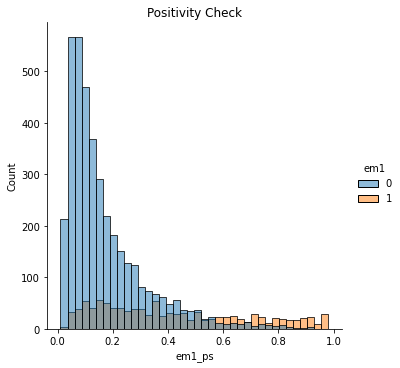
위 그래프처럼 두 분포가 잘 겹친다면 공통 지지가 있는 것입니다.
지금까지는 이메일 1(em1)만 살펴봤습니다. 이번에는 이메일 3을 보겠습니다.
email.head()| age | income | insurance | invested | em1_ps | em2_ps | em3_ps | em1 | em2 | em3 | converted | |
|---|---|---|---|---|---|---|---|---|---|---|---|
| 0 | 44.1 | 4214.66 | 14036.41 | 7988.66 | 0.118507 | 0.045174 | 0.921281 | 0 | 0 | 1 | 1 |
| 1 | 39.8 | 1151.27 | 66622.15 | 1000.74 | 0.431123 | 0.005659 | 0.000000 | 1 | 0 | 0 | 0 |
| 2 | 49.0 | 8047.26 | 14119.53 | 29480.22 | 0.062137 | 0.166706 | 0.840049 | 0 | 0 | 1 | 0 |
| 3 | 39.7 | 10558.37 | 14798.26 | 36373.09 | 0.047372 | 0.205684 | 0.000000 | 0 | 0 | 0 | 0 |
| 4 | 35.3 | 802.15 | 780.84 | 1643.16 | 0.616450 | 0.009292 | 0.000000 | 1 | 0 | 0 | 0 |
가장 먼저 눈에 띄는 것은 확률이 0인 대상이 있다는 점입니다. 이것만으로도 양수성 가정이 깨졌다는 신호입니다. 이제 em3에 따라 특성 분포를 나눠 보겠습니다.
sns.pairplot(email.sample(1000)[confounders + ["em3"]], hue="em3", plot_kws=dict(alpha=0.3));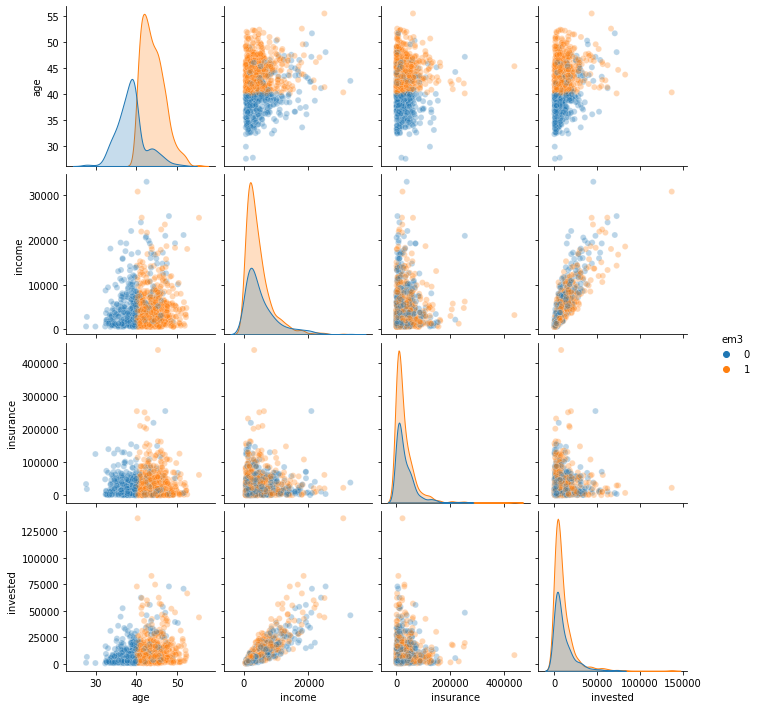
em3은 40세보다 나이가 많은 고객에게만 보낸 것으로 보입니다. 아주 큰 문제입니다. 대조군에는 젊은 사람이 있는데 실험군에는 없다면, 반사실 \(Y_0|T=1, age<40\)을 추정할 방법이 없습니다. 젊은 고객이 이 이메일에 어떻게 반응할지 전혀 알 수 없으니까요.
어떻게 되는지 보여 드리기 위해 일단 성향점수 편향 제거를 해 보겠습니다.
em3_weight = (email
              # using a different implementation to avoid division by zero
              .assign(em3_w = np.where(email["em3"].astype(bool), 1/email["em3_ps"], 1/(1-email["em3_ps"])))
              .sample(10000, replace=True, weights="em3_w"))
em3_weight[confounders + ["em3"]].corr()["em3"]age 0.251035
income 0.047607
insurance -0.000961
invested 0.053524
em3 1.000000
Name: em3, dtype: float64보다시피 나이와 처치 사이에는 여전히 큰 상관관계가 있습니다. 40세보다 어린 실험군 표본이 없어서 나이로 생긴 편향을 제거할 수 없었던 것입니다.
처치에 따라 성향점수 분포를 그리는 양수성 진단도 해 볼 수 있습니다.
sns.displot(data=email, x="em3_ps", hue="em3")
plt.title("Positivity Check");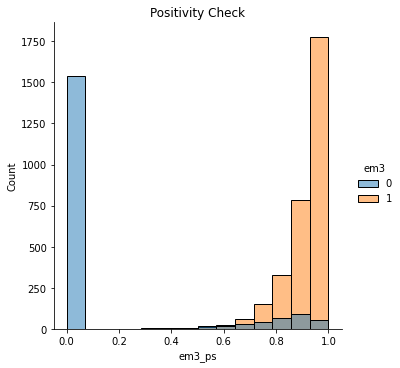
여기서는 중첩(overlap)이 얼마나 부족한지 보세요. 성향점수가 0.4보다 낮은 대상은 처치를 거의 받지 않습니다. 0에 우뚝 솟은 봉우리는 말할 것도 없습니다.
학계에서는 양수성 문제를 매우 심각하게 여깁니다. 결론이나 이론의 일반화를 위협하기 때문입니다. 실험군이 나이 든 사람뿐이라면, 찾아낸 처치효과가 무엇이든 젊은 모집단으로 일반화할 방법이 없습니다. 하지만 산업 현장에서는 양수성 가정 위반이 그렇게 큰 문제가 아닐 수도 있습니다.
예를 들어 대출 기관에서 대출 금액이 채무 불이행 확률에 미치는 탄력성을 추정하려 한다고 해 봅시다. 아마 신용 점수가 아주 낮은 사람에게는 큰 금액을 빌려주지 않을 것입니다. 물론 이는 양수성 가정을 위반합니다. 하지만 어차피 위험한 고객에게는 대출해 줄 생각이 없으니, 그런 고객의 대출 금액 탄력성을 추정하는 데는 별 관심이 없습니다. 조금 과장된 예를 들자면, 어떤 상품의 가격 탄력성을 추정하려 할 때 가격을 0부터 1000000까지 시험해 보지는 않을 것입니다. 가격이 보통 어느 범위에 있는지 어느 정도 감이 있기 때문입니다. 대개는 그 근처에서 시험하게 됩니다.
요점은 직관을 활용해 모집단의 일부를 처치(또는 대조군 배정)에서 빼도 되고, 아마 그렇게 하는 편이 낫다는 것입니다. 무작위 실험은 비용이 많이 들므로 유망한 곳에 노력을 집중해야 합니다.
이메일 예시에서는 아마 마케팅팀이 이메일 3을 젊은 사람에게는 절대 보내지 않아야 한다고 생각했을 것입니다. 나이 든 사람만 공감할 수 있는 내용을 대놓고 다루는 이메일일 수도 있습니다. 이유가 무엇이든 이메일 3의 효과는 40세보다 나이가 많은 모집단에 대해서만 추정할 수 있습니다. 그래도 전혀 문제없습니다. 그저 찾아낸 결과를 젊은 모집단으로 일반화하리라 기대하지만 않으면 됩니다.
이 점을 염두에 두고 이메일 3의 편향을 제거해 보겠습니다. 물론 표본에서 젊은 모집단은 빼겠습니다.
em3_weight.query("age>40")[confounders + ["em3"]].corr()["em3"]age -0.034455
income 0.024633
insurance -0.005650
invested 0.020711
em3 1.000000
Name: em3, dtype: float64그렇게 하고 나면 처치와 교란 요인 사이의 상관관계가 사라지는 것을 볼 수 있습니다. 전체 표본에서는 나이와의 상관계수가 0.2를 넘었다는 점을 떠올려 보세요. 이제는 아마 0과 구별하기 어려울 것입니다.
이렇게 걸러 낸 표본에서 실험군과 대조군의 분포도 살펴볼 수 있습니다.
sns.pairplot(em3_weight.query("age>40").sample(1000)[confounders + ["em3"]], hue="em3", plot_kws=dict(alpha=0.3))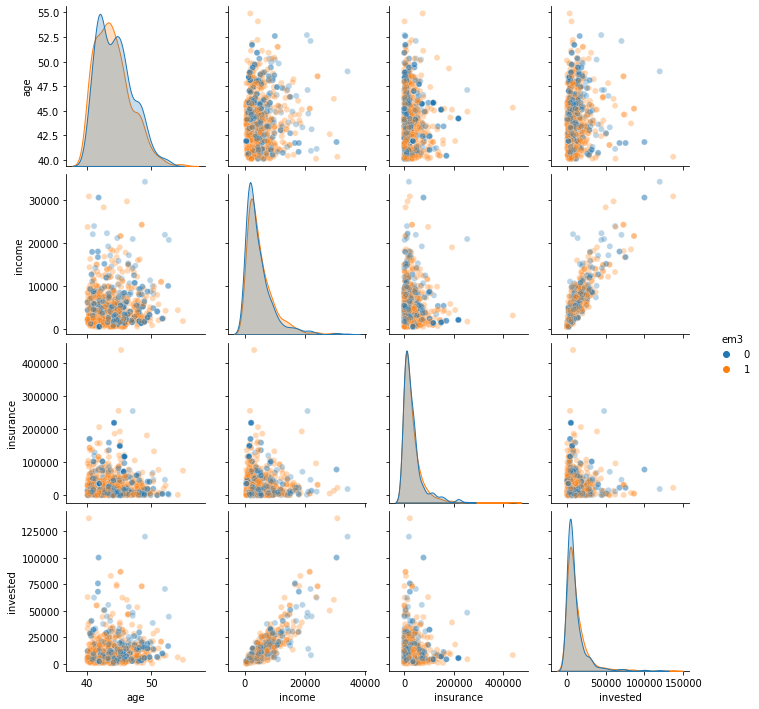
정리하면, 양수성 위반 때문에 em3에 대해서는 전체 표본의 편향을 제거할 수 없습니다. 하지만 이메일 3이 애초에 겨냥한 모집단에 대해서는 편향을 제거할 수 있습니다. 그것으로 충분합니다.
이번 장에서는 처치가 이진형이거나 이산형일 때 쓸 수 있는 또 다른 편향 제거 아이디어를 소개했습니다. 성향점수의 역수를 가중치로 삼아 대상을 다시 추출하는 것입니다. 이렇게 하면 실험군처럼 보이지만(성향점수가 높지만) 처치를 받지 않은 대상과, 대조군처럼 보이지만(성향점수가 낮지만) 처치를 받은 대상이 더 많이 뽑힙니다.
성향점수 편향 제거의 가장 큰 장점은 실험 중에 처치 확률을 저장해 두었다면 모델을 추정할 필요가 없다는 점입니다. 그렇다고 확률이 없으면 성향점수 재가중을 쓸 수 없다는 뜻은 아닙니다. 다만 확률을 추정해야 하므로 편향 제거 과정에 오차가 더해집니다.
단점도 있습니다. 성향점수가 지나치게 높거나 낮으면 가중치가 엄청나게 커져서 성향점수 재가중의 분산이 매우 커질 수 있습니다. 직관적으로 말하면, 실험군과 비슷한 대조군 대상이 거의 없고 대조군과 비슷한 실험군 대상도 거의 없을 때 이런 일이 생깁니다. 성향점수 가중치의 편을 들어 주자면, 이는 모든 인과추론 방법에 해당하는 문제입니다. 다만 성향점수 가중치는 양수성 가정을 거의 위반하는 이런 상황을 더 분명하게 드러냅니다.
끝으로 양수성 가정 위반이 얼마나 큰 문제인지 간단히 논의했습니다. 결론은 양수성이 성립하지 않는 모집단 부분으로까지 결론을 일반화하려 하지만 않는다면 문제가 아니라는 것이었습니다.
여기에 쓴 내용은 대부분 제 머릿속에서 나왔습니다. 경험으로 익힌 것들입니다. 그러니 좋은 과학이 보통 거치는 학계의 엄격한 검증을 통과하지 않았습니다. 실무에서 잘 통하는 방법을 이야기하면서도 왜 그런지 설명하는 데는 시간을 많이 들이지 않았다는 점을 눈치챘을 겁니다. 말하자면 길거리 과학인 셈입니다. 그래도 이 글을 공개해 누구나 검토할 수 있게 했으니, 터무니없는 내용을 발견하면 언제든 이슈를 열어 주세요. 최선을 다해 답하겠습니다.
이 장의 내용은 대부분 Guido W. Imbens의 Causal Inference for Statistics, Social, and Biomedical Sciences에서 가져왔습니다. 이 책에서 성향점수에 대한 폭넓은 논의를 찾아볼 수 있습니다. 다만 양수성에 관한 논의는 회사에서 동료들과 수없이 벌인 토론에서 나온 제 생각입니다.
Causal Inference for the Brave and True는 과학의 통계학이라 할 수 있는 인과추론을 다루는 오픈소스 자료입니다. 파이썬 기반의 무료 소프트웨어만 사용하며, 돈이 없어도, 배경지식이 많지 않아도 누구나 볼 수 있는 자료를 목표로 합니다. 이 책이 도움이 되었고 후원하고 싶다면 Patreon을 방문해 주세요. 금전적으로 기여하기 어렵다면 오타를 고치거나, 수정할 부분을 제안하거나, 이해하기 어려웠던 부분에 의견을 주는 것으로도 도울 수 있습니다. 책의 저장소에서 이슈를 열어 주세요. 마지막으로 이 내용이 마음에 들었다면 도움이 될 만한 사람들과 공유하고 GitHub에서 스타를 눌러 주세요.
한국어판의 오역이나 오탈자는 한국어판 이슈 페이지에 알려 주세요. 한국어판이 도움이 되었다면 한국어판 저장소에도 스타를 부탁드립니다.
의견 나누기
번역이 어색한 곳, 더 쉬운 설명, 궁금한 점을 남겨 주세요. GitHub 계정으로 로그인하면 댓글을 달 수 있고, 남긴 의견은 GitHub Discussions에 장별로 모입니다.