코드
import pandas as pd
import numpy as np
from matplotlib import pyplot as plt
import seaborn as sns
from nb21 import cumulative_gain, elast간단히 복습하면, 지금 관심사는 처치효과의 이질성, 즉 분석단위마다 처치에 다르게 반응하는 양상을 찾아내는 것입니다. 이 틀에서 추정하려는 대상은 다음과 같습니다.
\[ \tau(x) = E[Y_i(1) − Y_i(0)|X] = E[\tau_i|X] \]
처치가 연속형이라면 \(E[\delta Y_i(t)|X]\)입니다. 다시 말해 각 대상이 처치에 얼마나 민감한지 알고 싶은 것입니다. 이런 정보는 모두에게 처치를 줄 수 없어서 우선순위를 정해야 할 때 아주 유용합니다. 할인을 주고 싶은데 예산이 한정된 경우가 좋은 예입니다.
앞 장에서는 결과변수 \(Y\)를 변환해서 예측 모델에 그대로 넣고 조건부 평균 처치효과(CATE) 추정값을 얻는 방법을 살펴봤습니다. 그 대가로 분산이 커지는 것을 감수해야 했습니다. 데이터 과학에서는 이런 일이 흔합니다. 방법마다 장단점이 있어서 하나만 고를 수 있는 최선의 방법은 없습니다. 그래서 여러 기법을 알아 두었다가 상황에 따라 장단점을 따져 골라 쓰는 것이 좋습니다. 이 장도 그런 취지로, 손에 쥘 수 있는 도구를 더 늘리는 데 집중합니다.
메타러너(meta-learner)는 시중에 나와 있는 예측용 머신러닝 기법을 가져다가, 지금까지 다뤄 온 바로 그 문제, 즉 CATE 추정을 푸는 간단한 방법입니다. 이번에도 어느 하나가 최선은 아니며 저마다 약점이 있습니다. 하나씩 살펴보겠지만 이 내용은 상황에 크게 좌우된다는 점을 기억해 두세요. 게다가 메타러너는 선형회귀나 부스팅 의사결정 트리부터 신경망, 가우시안 프로세스까지 다양한 예측용 머신러닝 모델을 부품으로 씁니다. 따라서 메타러너의 성패는 어떤 머신러닝 기법을 구성 요소로 쓰느냐에도 크게 달려 있습니다. 결국 여러 가지를 직접 시도해 보고 무엇이 가장 잘 맞는지 확인해야 하는 경우가 많습니다.
import pandas as pd
import numpy as np
from matplotlib import pyplot as plt
import seaborn as sns
from nb21 import cumulative_gain, elast여기서는 앞에서 쓴 투자 광고 이메일 데이터를 다시 사용합니다. 이번에도 목표는 누가 이메일에 더 잘 반응할지 알아내는 것입니다. 다만 한 가지가 달라집니다. 이번에는 무작위가 아닌 데이터로 모델을 학습하고, 무작위 데이터로 모델을 검증합니다. 무작위가 아닌 데이터를 다루기는 훨씬 어렵습니다. 메타러너가 데이터의 편향을 제거하는 일과 CATE를 추정하는 일을 둘 다 해내야 하기 때문입니다.
test = pd.read_csv("./data/invest_email_rnd.csv")
train = pd.read_csv("./data/invest_email_biased.csv")
train.head()| age | income | insurance | invested | em1 | em2 | em3 | converted | |
|---|---|---|---|---|---|---|---|---|
| 0 | 44.1 | 5483.80 | 6155.29 | 14294.81 | 0 | 0 | 1 | 0 |
| 1 | 39.8 | 2737.92 | 50069.40 | 7468.15 | 1 | 0 | 0 | 0 |
| 2 | 49.0 | 2712.51 | 5707.08 | 5095.65 | 0 | 0 | 1 | 1 |
| 3 | 39.7 | 2326.37 | 15657.97 | 6345.20 | 0 | 0 | 0 | 0 |
| 4 | 35.3 | 2787.26 | 27074.44 | 14114.86 | 1 | 1 | 0 | 0 |
결과변수는 전환(conversion)이고 처치는 첫 번째 이메일(email-1)입니다. 이 둘과 함께, 처치효과의 이질성을 찾는 데 쓸 특성(feature) \(X\)를 변수로 저장해 둡시다.
y = "converted"
T = "em1"
X = ["age", "income", "insurance", "invested"]첫 번째로 쓸 러너는 S 러너(S-learner)입니다. 생각할 수 있는 가장 단순한 러너입니다. 머신러닝 모델 하나(single, 그래서 S입니다) \(M_s\)로 다음을 추정합니다.
\[ \mu(x) = E[Y| T, X] \]
방법은 간단합니다. 결과 Y를 예측하는 모델에 처치를 특성 하나로 넣기만 하면 됩니다.
여기서는 \(E[Y| T, X]\)를 추정하는 데 회귀 모델을 쓰지만, 결과변수가 이진이므로 분류 모델을 써도 됩니다. 그럴 때는 모델이 0, 1 같은 이진 클래스 대신 확률을 출력하도록 코드를 고쳐 주세요.
‘Go-Horse’는 브라질 개발자들이 농담 삼아 쓰는 ’eXtreme Go Horse(XGH)’ 방법론에서 온 말로, 깊이 고민하지 않고 일단 밀어붙이는 방식을 비꼬는 표현입니다.
from lightgbm import LGBMRegressor

np.random.seed(123)
s_learner = LGBMRegressor(max_depth=3, min_child_samples=30)
s_learner.fit(train[X+[T]], train[y]);
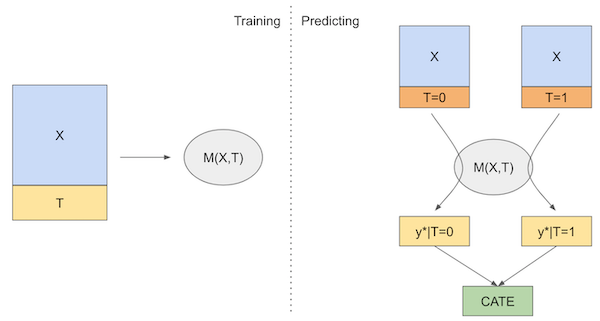
그다음 처치 조건을 바꿔 가며 예측합니다. 처치했을 때와 처치하지 않았을 때의 예측값 차이가 CATE 추정값이 됩니다.
\[ \hat{\tau}(x)_i = M_s(X_i, T=1) - M_s(X_i, T=0) \]
그림으로 나타내면 다음과 같습니다.
이제 이 러너를 코드로 구현해 봅시다.
s_learner_cate_train = (s_learner.predict(train[X].assign(**{T: 1})) -
                        s_learner.predict(train[X].assign(**{T: 0})))

s_learner_cate_test = test.assign(
    cate=(s_learner.predict(test[X].assign(**{T: 1})) - # predict under treatment
          s_learner.predict(test[X].assign(**{T: 0}))) # predict under control
)
모델을 평가하려고 테스트 셋에서 누적 이득 곡선(cumulative gain curve)을 그려 보겠습니다. 훈련 셋의 이득 곡선도 함께 그립니다. 훈련 셋은 편향되어 있으므로 이 곡선으로 모델이 좋은지 판단할 수는 없지만, 훈련 셋에 과적합(overfitting)됐는지는 알 수 있습니다. 과적합되면 훈련 셋의 곡선이 아주 높게 올라갑니다. 어떤 모습인지 궁금하다면 max_depth 매개변수를 3에서 20으로 바꿔 보세요.
gain_curve_test = cumulative_gain(s_learner_cate_test, "cate", y="converted", t="em1")
gain_curve_train = cumulative_gain(train.assign(cate=s_learner_cate_train), "cate", y="converted", t="em1")
plt.plot(gain_curve_test, color="C0", label="Test")
plt.plot(gain_curve_train, color="C1", label="Train")
plt.plot([0, 100], [0, elast(test, "converted", "em1")], linestyle="--", color="black", label="Baseline")
plt.legend()
plt.title("S-Learner");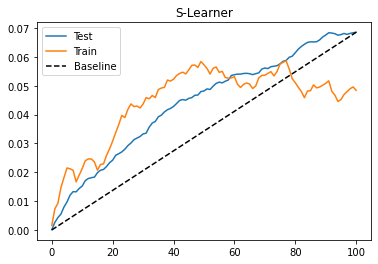
누적 이득 곡선에서 보듯이 S 러너는 단순하지만 이 데이터셋에서 그럭저럭 괜찮은 성능을 냅니다. 다만 이 성능은 이 데이터셋에 국한된 결과라는 점을 기억해 두세요. 데이터의 종류에 따라 S 러너는 더 잘할 수도, 더 못할 수도 있습니다. 실무에서 저는 S 러너가 어떤 인과 문제에서든 처음 시도해 볼 만한 좋은 선택지라고 생각합니다. 무엇보다 단순하기 때문입니다. 또한 S 러너는 연속형 처치와 이산형 처치를 모두 다룰 수 있지만, 이 장의 나머지 러너는 이산형 처치만 다룰 수 있습니다.
S 러너의 가장 큰 단점은 처치효과를 0 쪽으로 치우치게 추정하는 경향이 있다는 것입니다. S 러너에는 보통 정규화된 머신러닝 모델을 쓰는데, 이 정규화가 추정된 처치효과를 억누를 수 있습니다. Chernozhukov 등(2016)은 시뮬레이션 데이터로 이 문제를 보여 줍니다.
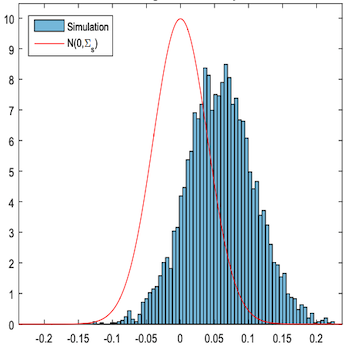
이 그림은 실제 인과효과(빨간 윤곽선)와 S 러너로 추정한 인과효과의 차이 \(\tau - \hat{\tau}\)를 나타냅니다. 추정된 인과효과가 심하게 편향되어 있습니다.
더 나쁜 경우도 있습니다. 결과를 설명하는 데 다른 공변량이 하는 역할에 비해 처치의 영향이 아주 약하면, S 러너는 처치변수를 아예 버릴 수도 있습니다. 이 문제는 어떤 머신러닝 모델을 쓰느냐와 밀접하게 관련됩니다. 정규화가 강할수록 문제도 커집니다. 이 문제를 바로잡으려는 시도가 다음에 볼 러너입니다.
T 러너(T-learner)는 러너가 처치를 기준으로 먼저 데이터를 나누도록 강제해서 처치를 통째로 버리는 문제를 해결하려고 합니다. 모델 하나를 쓰는 대신 처치변수의 값마다 모델을 하나씩 씁니다. 처치가 이진이면 추정할 모델은 두 개뿐입니다(그래서 이름이 T입니다).
\[ \mu_0(x) = E[Y| T=0, X] \]
\[ \mu_1(x) = E[Y| T=1, X] \]
그러고 나서 예측할 때 각 처치 조건에서의 반사실 예측을 구하고, 다음과 같이 CATE를 계산합니다.
\[ \hat{\tau}(x)_i = M_1(X_i) - M_0(X_i) \]
이 러너를 그림으로 나타내면 다음과 같습니다.
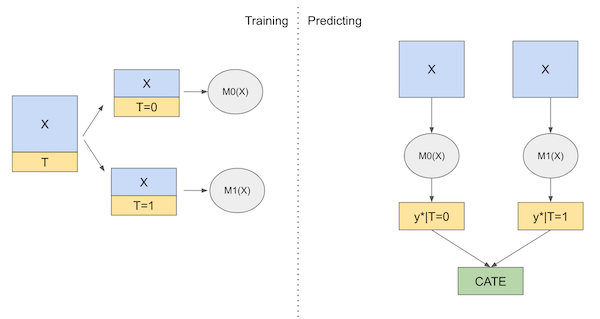
이론은 이쯤 하고, 코드로 옮겨 봅시다.
np.random.seed(123)

m0 = LGBMRegressor(max_depth=2, min_child_samples=60)
m1 = LGBMRegressor(max_depth=2, min_child_samples=60)

m0.fit(train.query(f"{T}==0")[X], train.query(f"{T}==0")[y])
m1.fit(train.query(f"{T}==1")[X], train.query(f"{T}==1")[y])

# estimate the CATE
t_learner_cate_train = m1.predict(train[X]) - m0.predict(train[X])
t_learner_cate_test = test.assign(cate=m1.predict(test[X]) - m0.predict(test[X]))gain_curve_test = cumulative_gain(t_learner_cate_test, "cate", y="converted", t="em1")
gain_curve_train = cumulative_gain(train.assign(cate=t_learner_cate_train), "cate", y="converted", t="em1")
plt.plot(gain_curve_test, color="C0", label="Test")
plt.plot(gain_curve_train, color="C1", label="Train")
plt.plot([0, 100], [0, elast(test, "converted", "em1")], linestyle="--", color="black", label="Baseline")
plt.legend();
plt.title("T-Learner");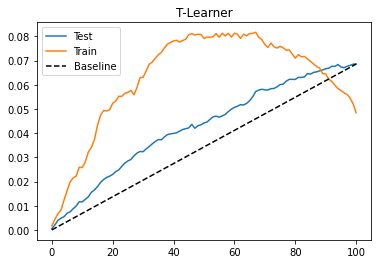
T 러너도 이 데이터셋에서 괜찮은 성능을 보입니다. 테스트 성능은 S 러너와 크게 다르지 않습니다. 처치가 그렇게 약하지 않기 때문일 수 있습니다. 또 훈련 셋 성능이 테스트 셋 성능보다 훨씬 높은데, 모델이 과적합됐다는 신호입니다. 모델마다 데이터의 일부만으로 학습했기 때문에 생길 수 있는 일입니다. 데이터 포인트가 적으니 모델이 잡음까지 학습했을 가능성이 큽니다.
T 러너는 약한 처치변수를 놓치는 문제는 피하지만, 여전히 정규화 편향에 시달릴 수 있습니다. Kunzela 등(2019)에서 가져온 다음 상황을 생각해 봅시다. 처치를 받지 않은 대상의 데이터는 아주 많고 처치를 받은 대상의 데이터는 아주 적습니다. 처치에는 대개 비용이 많이 들기 때문에 실제로 꽤 흔한 상황입니다. 이제 결과 Y에는 비선형성이 있지만 처치효과는 일정하다고 해 봅시다. 어떤 일이 생기는지 다음 그림에서 볼 수 있습니다.
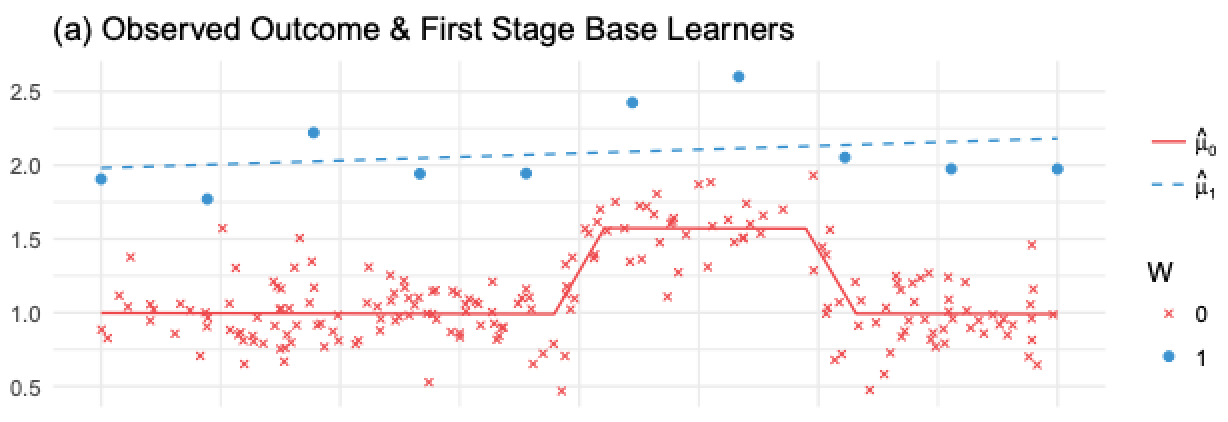
실험군의 관측값이 아주 적으므로 \(M_1\)은 과적합을 피하려고 아주 단순한 모델(여기서는 선형)이 됩니다. \(M_0\)는 더 복잡해지지만, 데이터가 풍부해서 과적합을 막아 주니 문제가 없습니다. 머신러닝 관점에서는 모두 타당한 결과입니다. 그런데 이 두 모델로 CATE \(\hat{\tau}=M_1(X) - M_0(X)\)를 계산하면, 선형인 \(M_1(X)\)에서 비선형인 \(M_0(X)\)를 빼게 되므로 CATE도 비선형이 됩니다(파란 선에서 빨간 선을 뺀 값). 이 예에서 CATE는 1로 일정하므로 틀린 결과입니다.
대조군 모델은 비선형성을 잡아낼 수 있지만, 실험군 모델은 표본이 작아서 정규화를 걸었고, 그 탓에 비선형성을 잡아내지 못했습니다. 물론 실험군 모델의 정규화를 줄일 수도 있지만, 그러면 작은 표본 크기 탓에 과적합이 일어납니다. 진퇴양난에 빠진 셈입니다. 이 문제를 풀기 위해 Kunzela 등이 같은 논문에서 제안한 X 러너를 쓸 수 있습니다.
X 러너(X-learner)는 앞의 러너들보다 설명하기가 훨씬 복잡하지만 구현은 꽤 간단하니 걱정하지 마세요. X 러너는 두 단계와 성향점수(propensity score) 모델로 이루어집니다. 첫 번째 단계는 T 러너와 똑같습니다. 먼저 표본을 실험군과 대조군으로 나누고, 실험군과 대조군에 각각 머신러닝 모델을 적합합니다.
\[ \hat{M}_0(X) \approx E[Y| T=0, X] \]
\[ \hat{M}_1(X) \approx E[Y| T=1, X] \]
여기서부터 이야기가 달라집니다. 두 번째 단계에서는 위 모델을 사용해 대조군과 실험군의 처치효과를 대체(impute)합니다.
\[ \hat{\tau}(X, T=0) = \hat{M}_1(X, T=0) - Y_{T=0} \]
\[ \hat{\tau}(X, T=1) = Y_{T=1} - \hat{M}_0(X, T=1) \]
그다음 이 효과를 예측하는 모델을 두 개 더 적합합니다.
\[ \hat{M}_{\tau 0}(X) \approx E[\hat{\tau}(X)|T=0] \]
\[ \hat{M}_{\tau 1}(X) \approx E[\hat{\tau}(X)|T=1] \]
앞에서 본 그림에 이 과정을 적용하면, 대조군에서 대체한 처치효과 \(\hat{\tau}(X, T=0)\)이 빨간 십자 표시이고 빨간 점선이 \(\hat{M}_{\tau 0}(X)\)입니다. 이 모델은 틀렸습니다. \(\hat{\tau}(X, T=0)\)을 실험군에서 추정한 단순하고 정규화된 모델 \(\hat{M}_1\)로 만들었기 때문입니다. 그 모델은 Y 변수의 비선형성을 잡아내지 못하므로, 그 모델로 대체한 처치효과는 비선형이 됩니다.
반면 파란 점은 실험군에서 대체한 처치효과 \(\hat{\tau}(X, T=1)\)입니다. 이 효과는 처치를 받지 않은 큰 표본으로 학습한 올바른 모델 \(M_0\)로 추정했습니다. 대체한 처치효과가 올바르므로, 파란 선으로 나타낸 두 번째 단계 모델 \(\hat{M}_{\tau 1}(X)\)도 올바르게 학습할 수 있습니다.
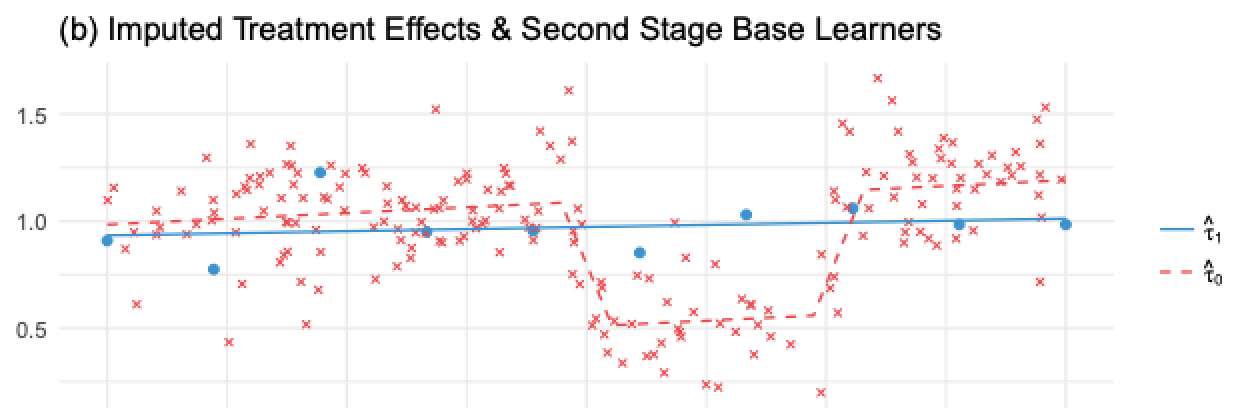
정리하면, 처치효과를 잘못 대체해서 틀린 모델이 하나 있고 처치효과를 제대로 대체해서 올바른 모델이 하나 있습니다. 이제 올바른 모델에 더 큰 가중치를 주면서 두 모델을 결합할 방법이 필요합니다. 여기서 성향점수 모델이 등장합니다. 성향점수 모델을 \(\hat{e}(x)\)라고 하면, 두 번째 단계 모델 둘을 다음과 같이 결합할 수 있습니다.
\[ \hat{\tau(x)} = \hat{M}_{\tau 0}(X)\hat{e}(x) + \hat{M}_{\tau 1}(X)(1-\hat{e}(x)) \]
처치를 받은 대상이 아주 적으므로 \(\hat{e}(x)\)는 아주 작습니다. 그래서 틀린 모델 \(\hat{M}_{\tau 0}(X)\)에는 아주 작은 가중치가 붙습니다.
반대로 \(1-\hat{e}(x)\)는 1에 가까우므로 올바른 모델 \(\hat{M}_{\tau 1}(X)\)에는 큰 가중치가 붙습니다. 더 일반적으로 말하면, 성향점수로 가중평균을 내면 실제로 배정된 처치가 나올 가능성이 더 컸던 쪽에서 추정한 CATE 모델에 더 큰 가중치가 실립니다. 즉, 더 많은 데이터로 학습한 모델을 우대합니다. 다음 그림은 X 러너와 T 러너가 추정한 CATE를 보여 줍니다.
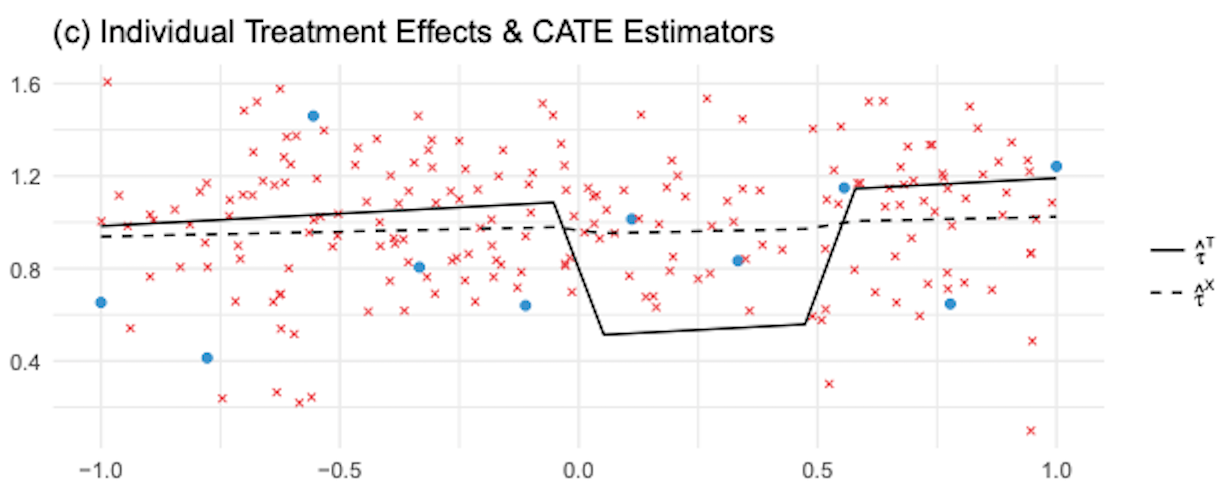
보다시피 X 러너는 T 러너보다 비선형 구간에서 잘못 추정된 CATE를 훨씬 잘 바로잡습니다. 일반적으로 X 러너는 한쪽 처치 집단이 다른 쪽보다 훨씬 클 때 더 좋은 성능을 냅니다.
한 번에 소화하기 벅찰 수 있지만 구현으로 넘어가면 분명해질 것입니다. 전체를 요약한 X 러너의 그림은 다음과 같습니다.
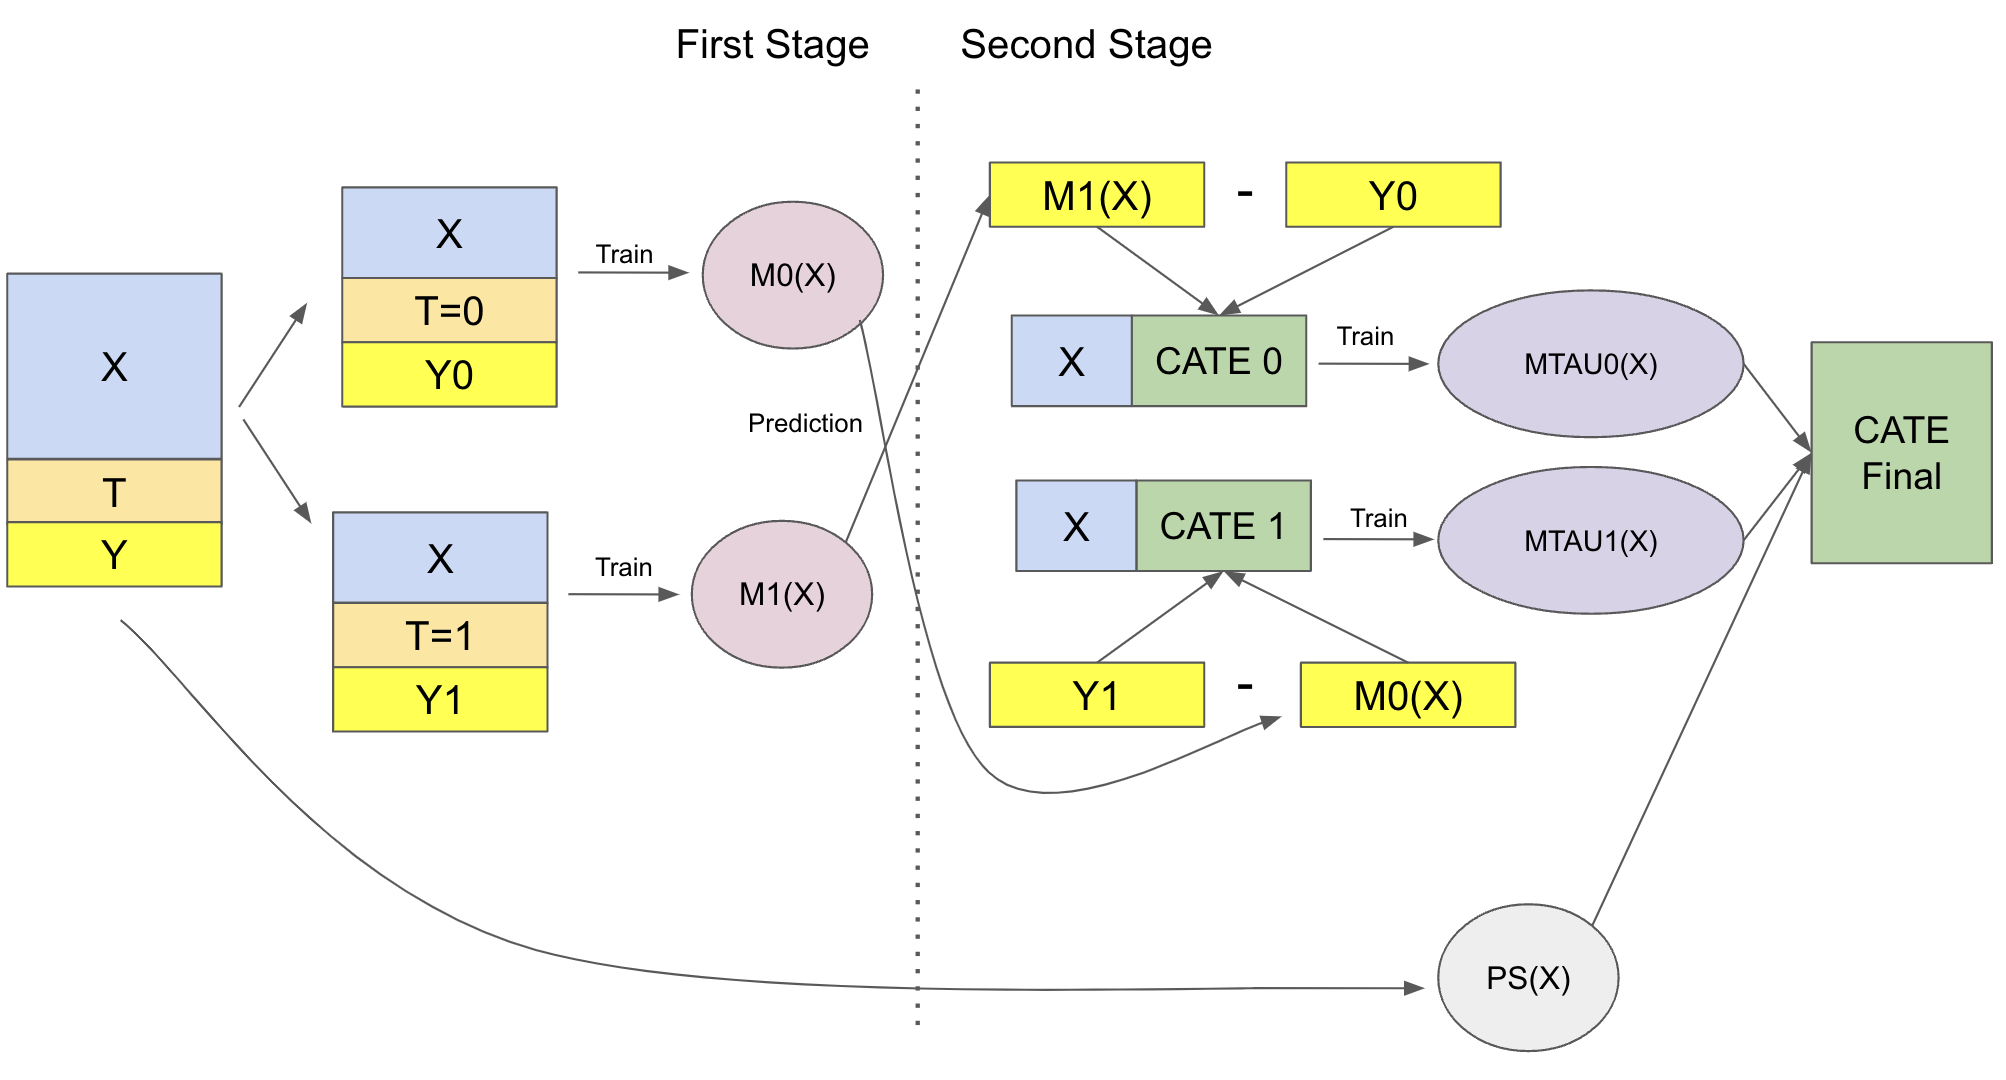
드디어 코드입니다! 먼저 첫 번째 단계는 T 러너와 똑같습니다.
from sklearn.linear_model import LogisticRegression

np.random.seed(123)

# first stage models
m0 = LGBMRegressor(max_depth=2, min_child_samples=30)
m1 = LGBMRegressor(max_depth=2, min_child_samples=30)

# propensity score model
g = LogisticRegression(solver="lbfgs", penalty='none')

m0.fit(train.query(f"{T}==0")[X], train.query(f"{T}==0")[y])
m1.fit(train.query(f"{T}==1")[X], train.query(f"{T}==1")[y])

g.fit(train[X], train[T]);
이제 처치효과를 대체하고, 그 값으로 두 번째 단계 모델을 적합합니다.
d_train = np.where(train[T]==0,
                   m1.predict(train[X]) - train[y],
                   train[y] - m0.predict(train[X]))

# second stage
mx0 = LGBMRegressor(max_depth=2, min_child_samples=30)
mx1 = LGBMRegressor(max_depth=2, min_child_samples=30)

mx0.fit(train.query(f"{T}==0")[X], d_train[train[T]==0])
mx1.fit(train.query(f"{T}==1")[X], d_train[train[T]==1]);
마지막으로 성향점수 모델을 사용해 보정된 예측값을 구합니다.
def ps_predict(df, t):
    return g.predict_proba(df[X])[:, t]


x_cate_train = (ps_predict(train,1)*mx0.predict(train[X]) +
                ps_predict(train,0)*mx1.predict(train[X]))

x_cate_test = test.assign(cate=(ps_predict(test,1)*mx0.predict(test[X]) +
                                ps_predict(test,0)*mx1.predict(test[X])))
X 러너가 테스트 셋에서 어떤 성능을 내는지 봅시다. 이번에도 누적 이득 곡선을 그립니다.
gain_curve_test = cumulative_gain(x_cate_test, "cate", y="converted", t="em1")
gain_curve_train = cumulative_gain(train.assign(cate=x_cate_train), "cate", y="converted", t="em1")
plt.plot(gain_curve_test, color="C0", label="Test")
plt.plot(gain_curve_train, color="C1", label="Train")
plt.plot([0, 100], [0, elast(test, "converted", "em1")], linestyle="--", color="black", label="Baseline")
plt.legend();
plt.title("X-Learner");
/Users/matheus.facure/Documents/python-causality-handbook/causal-inference-for-the-brave-and-true/nb21.py:10: RuntimeWarning: invalid value encountered in double_scalars
np.sum((data[t] - data[t].mean())**2))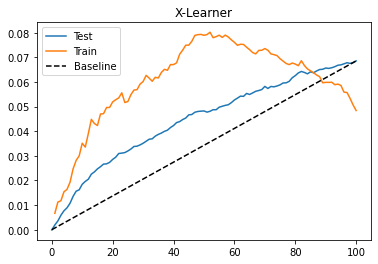
이번에도 이 데이터셋에서 괜찮은 성능이 나옵니다. 여기서는 S, T, X 러너의 성능이 꽤 비슷해 보입니다. 그래도 이 메타러너들을 모두 알아 둘 가치는 있습니다. 그래야 그때그때 가장 잘 맞는 것을 골라 쓸 수 있습니다. 성능은 바탕이 되는 머신러닝 모델을 무엇으로 고르느냐에도 크게 달려 있다는 점을 기억하세요. 여기서는 모두 그레이디언트 부스팅 트리를 썼지만, 다른 모델을 쓰거나 같은 모델이라도 하이퍼파라미터를 바꾸면 더 나을 수도 있습니다.
다시 말하지만, 가장 간단한 방법은 처치를 특성으로 넣은 단일 러너, 즉 S 러너를 쓰는 것입니다. 이 방법은 처치가 결과를 약하게 예측하는 변수가 아닐 때 잘 작동하는 편입니다. 그렇지 않다면 S 러너는 처치효과를 0 쪽으로 편향되게 추정하거나 처치를 아예 버리기도 합니다. 조금 더 복잡하게 T 러너를 쓰면 러너가 처치를 반드시 반영하게 만들 수 있습니다. T 러너는 처치 수준마다 머신러닝 모델을 하나씩 적합합니다. 모든 처치 수준에 표본이 충분하면 잘 작동하지만, 어느 한 처치 수준의 표본 크기가 작으면 모델을 강하게 정규화할 수밖에 없어서 실패할 수 있습니다. 이를 바로잡으려면 한 단계 더 복잡한 X 러너를 쓸 수 있습니다. X 러너는 적합을 두 단계로 나누고, 성향점수 모델을 사용해 아주 적은 데이터로 추정한 모델의 실수를 보정합니다.
이 러너들(S 러너 제외)의 큰 문제 하나는 처치가 이진이거나 범주형이라고 가정한다는 점입니다. 아직 다루지 않은, 더 일반적인 러너가 하나 더 있습니다. 바로 R 러너입니다. 하지만 걱정하지 마세요. R 러너만 다루는 장이 따로 있습니다.
여기 쓴 내용은 대부분 제 머릿속에서 나온 것입니다. 경험으로 배운 것들입니다. 즉, 좋은 과학이라면 보통 거치는 학계의 엄밀한 검증을 통과하지 않았다는 뜻입니다. 대신 실무에서 통하는 것들을 이야기하면서도 왜 그런지 설명하는 데는 시간을 많이 들이지 않았다는 점을 눈여겨보세요. 말하자면 길거리 과학인 셈입니다. 하지만 이 내용을 공개해 누구나 검토할 수 있게 해 두었으니, 터무니없는 내용을 발견하면 주저하지 말고 이슈를 열어 주세요. 최선을 다해 답하겠습니다.
이 장을 쓰면서 Uber의 causalml 라이브러리와 메타러너에 관한 문서를 참고했습니다. 이미지와 개념은 Kunzela 등(2019)의 Metalearners for estimating heterogeneous treatment effects using machine learning에서 많이 가져왔습니다. 마지막으로 S 러너가 0 쪽으로 편향된다는 논의는 Chernozhukov 등(2017)의 Double/Debiased Machine Learning for Treatment and Causal Parameters에서 가져왔습니다.
Causal Inference for the Brave and True는 과학의 통계학이라 할 수 있는 인과추론을 다루는 오픈소스 자료입니다. 파이썬 기반의 무료 소프트웨어만 사용하며, 돈이 없어도, 배경지식이 많지 않아도 누구나 볼 수 있는 자료를 목표로 합니다. 이 책이 도움이 되었고 후원하고 싶다면 Patreon을 방문해 주세요. 금전적으로 기여하기 어렵다면 오타를 고치거나, 수정할 부분을 제안하거나, 이해하기 어려웠던 부분에 의견을 주는 것으로도 도울 수 있습니다. 책의 저장소에서 이슈를 열어 주세요. 마지막으로 이 내용이 마음에 들었다면 도움이 될 만한 사람들과 공유하고 GitHub에서 스타를 눌러 주세요.
한국어판의 오역이나 오탈자는 한국어판 이슈 페이지에 알려 주세요. 한국어판이 도움이 되었다면 한국어판 저장소에도 스타를 부탁드립니다.
의견 나누기
번역이 어색한 곳, 더 쉬운 설명, 궁금한 점을 남겨 주세요. GitHub 계정으로 로그인하면 댓글을 달 수 있고, 남긴 의견은 GitHub Discussions에 장별로 모입니다.