from toolz import*import pandas as pdimport numpy as npfrom scipy.special import expitfrom linearmodels.panel import PanelOLSimport statsmodels.formula.api as smfimport seaborn as snsfrom matplotlib import pyplot as pltfrom matplotlib import stylestyle.use("ggplot")
처치효과의 이질성을 살펴봤으니 이제 방향을 조금 틀어 평균 처치효과로 돌아가겠습니다. 앞으로 몇 장에 걸쳐 패널데이터(panel data) 방법론의 최근 발전을 다룹니다. 패널은 같은 대상을 시간에 걸쳐 반복해서 관측한 데이터 구조입니다. 같은 대상을 여러 기간에 관측하므로 처치가 일어나기 전과 후에 무슨 일이 있었는지 볼 수 있습니다. 그래서 패널데이터는 무작위 배정이 불가능할 때 인과효과를 식별할 수 있는 유력한 대안이 됩니다.
패널데이터가 왜 필요한지 보여 드리기 위해 주로 마케팅 분야의 인과추론 사례를 이야기하겠습니다. 마케팅은 무작위 실험을 하기 어렵기로 악명이 높아서 특히 흥미로운 분야입니다. 마케팅에서는 누가 처치를 받는지, 즉 누가 광고를 보는지 통제할 수 없는 경우가 많습니다. 새 사용자가 사이트를 방문하거나 앱을 내려받았을 때, 그 사용자가 캠페인을 보고 왔는지 다른 이유로 왔는지 제대로 알 방법이 없습니다.
(참고: 마케팅 어트리뷰션에 익숙한 분들께 덧붙이자면, 이 문제를 풀려는 어트리뷰션 도구가 많다는 것은 저도 알고 있습니다. 그리고 그 도구들에 한계가 많다는 것도 알고 있습니다.)
오프라인 마케팅에서는 문제가 더 커집니다. TV 캠페인이 비용보다 큰 가치를 가져왔는지 어떻게 알 수 있을까요? 그래서 마케팅에서는 지역 실험(geo-experiment)을 흔히 활용합니다. 일부 지역에만 마케팅 캠페인을 진행하고 나머지 지역에는 진행하지 않은 뒤 둘을 비교하는 방식입니다. 이런 설계에서는 패널데이터 방법이 특히 유용합니다. 한 지역 전체(대상)의 데이터를 여러 기간에 걸쳐 모을 수 있기 때문입니다. 이러한 데이터를 해석하고 인과효과를 식별하는 데 가장 널리 쓰이는 방법은 아마 이중차분법(DID) 계열일 것입니다.
2020년과 2021년은 대부분의 사람에게 쉽지 않은 해였습니다. 그런데 DID에게는 유난히 혹독한 시기였습니다. 최근 여러 연구가 이 방법들의 심각한 결함을 짚어 냈는데, 과거에는 잘 알려지지 않았던 결함들입니다. 1부에도 DID를 다룬 장이 있지만 그 내용은 입문 수준이라서, 패널데이터 방법을 둘러싼 새로운 발견과 뜨거운 논의는 담고 있지 않습니다. 이제 DID부터 시작해 이 방법들을 좀 더 깊이 들여다볼 때입니다. 이 장에서는 최근 드러난 DID의 문제를 정리하고 이를 어떻게 고칠 수 있는지 보여 드리겠습니다. 이 장은 세 부분으로 나뉩니다.
탄생: 패널데이터가 인과추론에 왜 그렇게 매력적인지, DID와 이원고정효과(TWFE)가 시간 구조를 어떻게 활용하는지 다시 짚어 봅니다.
죽음: DID와 TWFE 모델에 깔려 있지만 그동안 간과된 핵심 가정 하나를 뜯어봅니다. 이 가정이 언제, 어떻게 무너지는지 이해합니다.
깨달음: DID와 TWFE의 문제를 알았으니 이제 해결책을 생각해 볼 수 있습니다. 2절에서 살펴본 문제를 간단히 우회하는 방법을 보여 드립니다.
바로 시작해 봅시다!
1) 탄생: 패널데이터의 약속
앞서 말했듯이 패널데이터는 여러 대상 i를 여러 기간 t에 걸쳐 관측한 데이터입니다. 미국에서 대마초 합법화가 범죄율에 미치는 영향을 평가하는 정책 평가 상황을 생각해 봅시다. 여러 주 i의 범죄율 데이터가 여러 기간 t에 걸쳐 있습니다. 또 각 주가 언제 대마초 합법화 쪽으로 법을 바꿨는지도 알고 있습니다. 이것이 인과추론에 얼마나 강력한지 감이 오실 겁니다. 대마초 합법화를 처치 D라고 부르겠습니다(T는 이미 시간을 나타내는 데 쓰고 있으니까요). 결국 처치를 받게 되는 어떤 주의 범죄율 추세를 따라가다가 처치 시점에 추세가 꺾이는지 볼 수 있습니다. 어떤 의미에서는 처치 전후 비교에서 그 주가 자기 자신의 대조군 역할을 하는 셈입니다. 게다가 주가 여러 개이므로 처치받은 주와 대조군 주를 비교할 수도 있습니다. 실험군 대 대조군, 처치 전 대 처치 후라는 두 비교를 합치면 반사실(counterfactual), 나아가 인과효과를 추론하는 매우 강력한 도구가 됩니다.
패널데이터 방법은 정부 정책 평가에 자주 쓰이지만, IT 업계에서도 아주 유용하다는 점은 쉽게 알 수 있습니다. 기업은 사용자 데이터를 여러 기간에 걸쳐 추적하는 경우가 많아서 풍부한 패널데이터를 갖게 됩니다. 그뿐 아니라 실험이 불가능해서 다른 식별 전략에 기대야 할 때도 있습니다. 이 생각을 더 구체적으로 살펴보기 위해, 여러 도시에서 자사 앱을 설치한 사람 수를 추적하는 신생 IT 기업의 가상 사례를 생각해 봅시다. 이 회사는 2021년 어느 시점에 앱에 새 기능을 출시했습니다. 이제 회사는 그 기능 덕분에 신규 사용자가 얼마나 늘었는지 알고 싶어 합니다. 출시는 점진적으로 이루어졌습니다. 일부 도시는 2021-06-01에, 다른 도시는 2021-07-15에 기능을 받았습니다. 나머지 도시에는 2022년에야 전면 출시됩니다. 데이터가 2021-07-31까지만 있으므로 이 마지막 그룹을 대조군으로 볼 수 있습니다. 인과추론의 용어로 말하면 이 기능의 출시는 처치, 설치 수는 결과입니다. 알고 싶은 것은 결과에 대한 처치효과, 즉 새 기능이 설치 수에 미치는 효과입니다.
이 회사가 왜 실험을 할 수 없는지 짚어 볼 필요가 있습니다. 누가 새 기능의 존재를 알게 될지 통제할 수 없기 때문입니다. 이럴 때 처치 배정을 제한적으로만 통제할 수 있다고 말합니다. 분석단위가 아직 고객이 아닌 사람들이기 때문입니다. 회사는 그중 몇 명을 앱 설치로 이끌어 고객으로 전환할 수 있는지 알고 싶어 합니다. 당연히 이 사람들을 대상으로는 아무것도 무작위로 배정할 수 없습니다. 그래서 분석단위를 도시로 바꿨습니다. 어떤 도시에는 출시하고 다른 도시에는 출시하지 않는 것은 회사가 통제할 수 있지만, 사람마다 출시 여부를 정하는 것은 그렇지 않습니다.
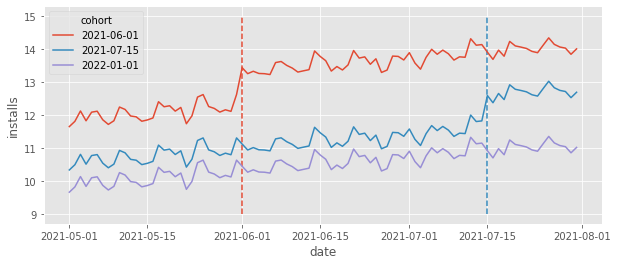
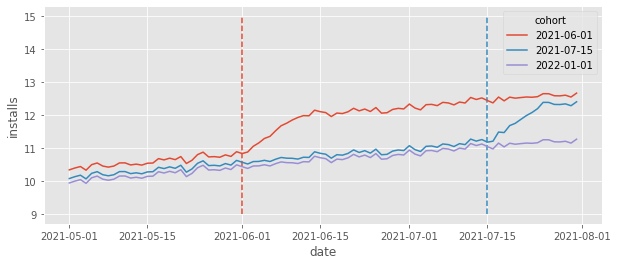
특정 시점에 기능을 받은(처치받은) 도시 그룹을 코호트(cohort)라고 합니다. 이 예에는 코호트가 세 개 있습니다. 2021-06-01에 처치받은 코호트, 2021-07-15에 처치받은 코호트, 그리고 데이터가 끝난 뒤에야 처치받는 대조군 코호트입니다. 데이터가 어떻게 생겼는지 감을 잡기 위해 코호트별 일평균 설치 수를 그려 보겠습니다.
plt.figure(figsize=(10,4))[plt.vlines(x=cohort, ymin=9, ymax=15, color=color, ls="dashed") for color, cohort inzip(["C0", "C1"], cohorts[:-1])]sns.lineplot( data=(df .groupby(["cohort", "date"])["installs"] .mean() .reset_index()), x="date", y ="installs", hue="cohort",);
점선은 각 코호트가 처치받은(기능이 출시된) 시점을 표시합니다. 위 그래프에 담긴 데이터가 얼마나 풍부한지 잠시 감상해 보세요. 먼저 코호트마다 기준 수준이 다릅니다. 도시마다 인구 규모가 달라서 도시 크기에 따라 설치 수가 많거나 적기 때문입니다. 예를 들어 첫 번째 코호트(06/01에 처치)의 도시들은 다른 코호트의 도시들보다 기준 수준이 높아 보입니다. 또 대조군 코호트는 설치 수의 기준 수준이 더 낮아 보입니다. 따라서 실험군 코호트와 대조군 코호트를 단순 비교하면 편향된 결과가 나옵니다. 대조군의 \(Y_{0}\)가 실험군의 \(Y_{0}\)보다 낮기 때문입니다. 즉 \(Y_{0}|G=Control < Y_{0}|G=Treated\)이며, 여기서 \(G\)는 코호트를 나타냅니다. 다행히 이는 문제가 되지 않습니다. 패널데이터에서는 도시 간 비교와 시간 간 비교를 함께 할 수 있으므로 기준 수준의 차이를 보정할 수 있습니다.
시간 이야기가 나왔으니, 전체적으로 우상향 추세가 있고 그 위에 약간의 출렁임(주간 계절성처럼 보입니다)이 있다는 점도 보세요. 대조군 코호트만 보면 일 설치 수가 5월 약 10건에서 6월 약 11건으로 1건 정도 늘었습니다. 기술적으로 말하면 뒤쪽 기간의 \(Y_{0}\)가 앞쪽 기간보다 높습니다. 따라서 같은 도시를 시간에 걸쳐 단순 비교해도 편향된 결과가 나옵니다. 이번에도 다행히 패널데이터 구조 덕분에 시간 간 비교뿐 아니라 도시 간 비교도 할 수 있어서 추세를 보정할 수 있습니다.
새 기능 출시가 설치 수에 미친 효과를 추론하려면, 이상적으로는 기능을 받은 코호트가 기능을 받지 않았다면 어떻게 됐을지 알아야 합니다. 실험군 코호트의 처치 후 기간의 반사실적 결과 \(Y(0)\)를 추정하고 싶은 것입니다. 각 코호트를 처치받은 시점 g로 나타내면(코호트는 같은 시점에 처치받은 도시들의 묶음일 뿐이라는 점을 기억하세요), 이 반사실을 \(E[Y_0|t\geq g]\)로 쓸 수 있습니다. 그러면 코호트 g의 실험군에 대한 평균 처치효과(ATT)를 다음과 같이 정의할 수 있습니다.
\[
E[Y_1|t \geq g] - E[Y_0|t\geq g]
\]
다음 질문은 가진 데이터로 이 값을 어떻게 추정하느냐입니다. 한 가지 방법은 패널데이터 구조의 힘을 빌려 반사실을 추정하는 것입니다. 예를 들어 선형회귀와 DID 공식을 써서 이원고정효과모델을 만들 수 있습니다. 각 도시 i에 기본 설치 수준 \(\gamma_i\)가 있다고 해 봅시다. 앞에서 본 내용과 이어지는 이야기입니다. 어떤 도시는 인구가 많아서, 혹은 그 도시의 문화가 회사 제품과 잘 맞아서 설치 수가 많을 수 있습니다. 이유가 무엇이든, 또 이유를 모르더라도, 이런 대상별 고유한 특성은 시간에 대해 고정된 매개변수\(\gamma_i\)로 포착할 수 있다고 봅니다. 마찬가지로 각 기간 t에도 기준 설치 수준이 있고, 이는 대상에 대해 고정된 매개변수\(\theta_t\)로 포착할 수 있습니다. 그렇다면 설치 수가 도시(대상) 효과 \(\gamma\)와 시간 효과 \(\theta\), 그리고 약간의 무작위 잡음으로 정해진다고 모델링하는 것이 좋은 방법입니다.
힌트옮긴이
원문의 표현을 그대로 옮겼지만, 이름 때문에 헷갈릴 수 있습니다. γᵢ는 시간이 지나도 변하지 않는 도시별 값이고 θₜ는 모든 도시에 똑같이 적용되는 기간별 값입니다. 보통은 γᵢ를 대상 고정효과(unit fixed effect), θₜ를 시간 고정효과(time fixed effect)라고 부릅니다.
처치를 이 그림에 넣기 위해, 대상이 처치받았으면 1이고 아니면 0인 변수 \(D_{it}\)를 정의합시다. 이 예에서 이 변수는 처치를 전혀 받지 않는 코호트에서는 항상 0입니다. 다른 코호트에서도 처음에는 0이지만, 06/01에 처치받은 코호트에서는 06/01에 1로 바뀌고 그 뒤로 계속 1을 유지합니다. 07/15에 처치받은 코호트에서는 07/15에 1로 바뀝니다. 이 처치 지표를 설치 수 모델에 다음과 같이 넣을 수 있습니다.
위 모델을 최소제곱법(OLS)으로 추정하는 것을 이원고정효과모델(TWFE)이라고 합니다. 대상이 처치받았을 때 설치 수가 얼마나 변하는지 알려 주므로 \(\tau\)가 처치효과가 됩니다.
선형회귀의 ‘다른 조건을 고정하는’ 성질을 떠올려 보는 것도 한 방법입니다. 위 모델을 추정하면 \(\tau\)의 추정값은 대상 i와 시간 t를 고정한 채 처치를 0에서 1로 바꿨을 때 설치 수가 얼마나 변하는지로 읽을 수 있습니다.
이게 얼마나 대담한 주장인지 보세요! 각 대상을 고정한 채 \(D\)가 결과를 어떻게 바꾸는지 본다는 말은, 시간에 따라 변하지 않는 대상별 특성을 알려진 것이든 알려지지 않은 것이든 모두 통제한다는 뜻입니다. 예를 들어 측정할 수 있는 도시별 기준 설치 수준뿐 아니라, 도시 문화가 제품과 얼마나 잘 맞는지처럼 짐작조차 할 수 없는 요인까지 통제하게 됩니다. 조건은 단 하나, 그 특성이 분석 기간 동안 변하지 않아야 한다는 것입니다. 또 각 기간을 고정한다는 말은 연도별 특성을 모두 통제한다는 뜻입니다. 예를 들어 \(D\)의 효과를 보는 동안 연도를 고정하므로 앞에서 본 추세와 계절성이 통제됩니다.
이 강력함을 직접 확인하려면 처치 지표 \(D\)(여기서는 treat)에 대상 더미와 시간 더미를 더해 OLS 모델을 돌리기만 하면 됩니다. 이 예제에서는 처치(새 기능)가 설치 수를 1만큼 늘리도록 데이터를 생성했습니다. TWFE가 이 처치효과를 정확히 찾아내는 것을 보세요.
데이터를 직접 시뮬레이션했으므로 실제 개별 처치효과를 정확히 알고 있고, 이 값은 tau 열에 저장되어 있습니다. TWFE는 실험군에 대한 처치효과를 추정해야 하므로 실제 ATT가 위 추정값과 일치하는지 확인할 수 있습니다. 처치받은 대상과 기간(treat==1)만 골라 tau 열의 평균을 구하면 됩니다.
df.query("treat==1")["tau"].mean()
1.0
빅데이터에서는 대상마다 더미 열을 하나씩 만드는 것이 불가능하다고 누가 지적하기 전에 먼저 털어놓겠습니다. 네, 맞는 말입니다. 하지만 쉬운 우회로가 있습니다. 프리슈-워-로벨 정리(FWL)를 이용하면 회귀 하나를 둘로 나눌 수 있습니다. 실제로 위 모델을 추정하는 것은 다음 모델을 추정하는 것과 수치적으로 똑같습니다.
수식이 너무 빽빽하다면 말로 풀어 보겠습니다. 처치 지표와 결과변수 양쪽에서 대상별 시간 평균(첫 번째 항)과 시점별 대상 평균(두 번째 항)을 빼서 잔차를 만듭니다. 결과와 처치에서 평균을 빼므로 이 과정을 흔히 평균 제거(de-meaning)라고 부릅니다. 마지막으로, 똑같은 작업을 코드로 하면 다음과 같습니다.
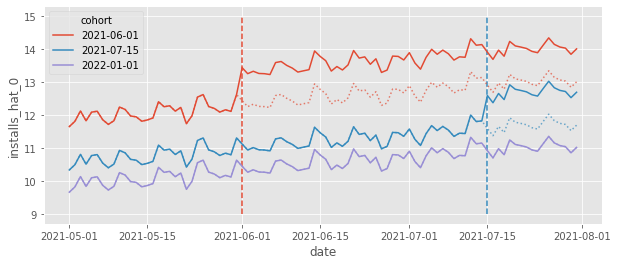
TWFE 모델이 무엇을 하는지 이해하는 또 다른 방법은 반사실 예측값 \(\hat{Y_0}|t \geq g\)를 그려 보는 것입니다. 모델이 처치효과 \(\hat{\tau}\)로 보는 것은 결국 추정된 차이 \(Y_1 - \hat{Y_0}\)이므로 이 그래프가 도움이 됩니다. 이 차이를 직접 보면 모델이 무엇을 하는지 감을 잡을 수 있습니다. 아래 그래프가 바로 그것을 보여 주며, 점선이 \(\hat{Y_0}\)입니다.
이 그래프는 TWFE가 대조군에서 본 추세를 실험군에 투영하면서 수준도 맞추고 있음을 보여 줍니다. 예를 들어 빨간색 코호트를 보면, 반사실 \(Y_0\)는 파란색과 보라색 코호트의 평균 추세를 가져와서(추세 투영) 빨간색 코호트의 수준으로 옮겨 놓은 것입니다(수준 조정). 그래서 TWFE를 이중차분법의 하나로 봅니다. TWFE도 추세 투영과 수준 조정을 하지만, 여러 기간과 여러 대상에서 작동한다는 점이 다릅니다(대상 2개, 기간 2개인 경우에는 TWFE와 DID가 같습니다).
2) 죽음: 효과 이질성 앞에서 무너지다
방금 본 것처럼 DID와 TWFE에는 장점이 있습니다. 시간별 변동과 대상별 변동을 모두 반영하면서 반사실을 꽤 잘 추정합니다. 그래서 강력한 인과추론 기법입니다. 하지만 이게 전부였다면 이 장은 필요 없었을 것입니다. 이 책의 1부에서 충분히 다뤘으니까요. 그런데 최근 많은 학자가 2×2 DID를 TWFE로 여러 기간에 확장하는 일이 처음 생각만큼 간단하지 않다는 것을 알아챘습니다. 실제로 흔히 쓰는 형태의 TWFE는 현실의 많은 응용에서 편향된 것으로 드러났습니다. 이 일로 이 기법에 기댄 경제학 연구 여러 편이 줄줄이 재검토되었습니다. 이 모든 것을 이해하려면 밑에 깔린 가정부터 짚는 것이 가장 좋습니다.
단순하게 하기 위해 시간 효과가 없는 고정효과모델(FE)을 생각해 봅시다.
\[
y_{it} = \tau D_{it} + \gamma_i + e_{it}
\]
이 모델이 하는 가정은 두 묶음으로 나눌 수 있습니다.
함수 형태(functional form) 가정
시간에 따른 이질적 효과 없음(효과가 일정함)
공변량에 대한 선형성
가법적 고정효과
강외생성(strict exogeneity)
평행 추세(parallel trends)
비기대(no anticipation)
시간에 따라 변하는 관측되지 않은 교란 요인 없음
과거 처치가 현재 결과에 영향을 주지 않음(이월 효과 없음)
과거 결과가 현재 처치에 영향을 주지 않음(피드백 없음)
여기서는 함수 형태 가정에 집중하겠습니다. 공변량에 대한 선형성은 잘 알려진 가정이고 모든 선형회귀 모델에 해당합니다. 하지만 이중/편향 제거 머신러닝 장에서 본 것처럼 머신러닝 모델을 쓰면 이 가정은 쉽게 완화할 수 있습니다. 즉, 원한다면 이 가정은 풀 수 있습니다. 가법적 고정효과는 그리 제약이 큰 가정이 아니어서 문제를 별로 일으키지 않습니다. 제가 집중하고 싶은 것(그리고 큰 소동을 일으킨 것)은 시간에 따른 이질적 효과가 없다는 가정입니다.
시간에 따른 처치효과의 이질성
마케팅이나 IT 업계에서 일해 봤다면 무엇이든 자리 잡는 데 시간이 걸린다는 것을 아실 겁니다. 새 기능을 출시하면 사용자가 익숙해지기까지 시간이 걸립니다. 마찬가지로 마케팅 캠페인을 시작해도 그 효과는 바로 나타나지 않습니다. 시간이 지나며 효과가 무르익고, 캠페인이 끝난 뒤에도 신규 사용자를 데려올 수 있습니다. 앞에서 본 설치 데이터는 이런 패턴이 아니었습니다. 거기서는 코호트가 처치받는 순간 설치 수가 곧바로 뛰었습니다. 이를 현실에 더 가깝게 바꾸면 어떻게 될까요? 구체적으로, ATT는 여전히 1이지만 효과가 무르익는 데 10일이 걸리도록 하겠습니다(처치 첫날에는 0.1, 둘째 날에는 0.2, 이런 식으로 늘어나 10일째에 1이 됩니다). 또 전체 추세가 잘 보이도록 시간 효과와 대상 효과의 크기를 줄이겠습니다.
먼저 실제 ATT가 더 이상 1이 아니라는 점에 주목하세요. 처음 몇 기간에는 효과가 더 작기 때문입니다. 둘째로, 그리고 가장 중요한 점은 TWFE로 추정한 ATT가 더 이상 실제 ATT를 찾아내지 못한다는 것입니다. 간단히 말해 TWFE가 편향되었습니다. 왜 그럴까요? 여기서는 평행 추세도, 비기대도, 그 밖의 강외생성 가정도 모두 성립합니다. 그런데 대체 무슨 일이 일어난 걸까요?
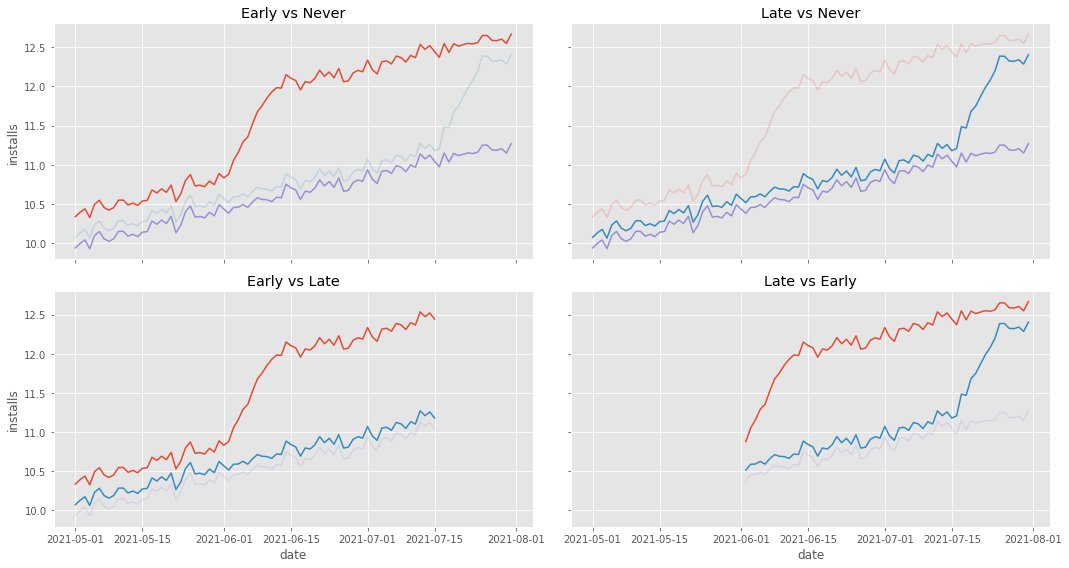
무슨 일이 일어나는지 이해하는 첫걸음은 TWFE를 여러 개의 2×2 DID로 분해할 수 있다는 사실을 깨닫는 것입니다. 이 예에서는 네 가지 비교가 나옵니다. 조기 처치 코호트 대 미처치 코호트, 후기 처치 코호트 대 미처치 코호트, 조기 처치 코호트 대 후기 처치 코호트(후기 처치 코호트가 대조군), 그리고 후기 처치 코호트 대 조기 처치 코호트(조기 처치 코호트가 대조군)입니다.
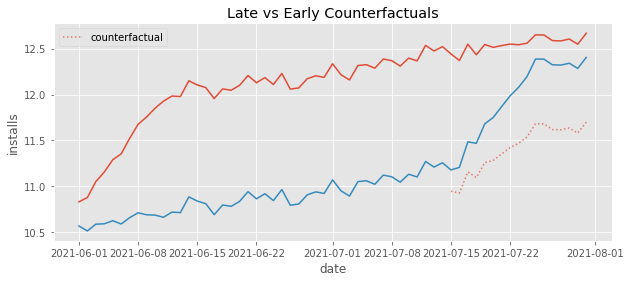
처음 세 비교는 크게 걱정할 필요가 없습니다. 대조군으로 쓰는 코호트가 아주 얌전하게 움직이기 때문입니다. 하지만 네 번째 비교인 후기 대 조기는 문제가 있습니다. 이 비교는 조기 처치 코호트를 대조군으로 쓴다는 점에 주목하세요. 그리고 이 대조군이 이상하게 움직인다는 점도 보세요. 초반에 가파르게 올라갑니다. ATT가 즉시 나타나지 않고 10일에 걸쳐 무르익는다는 사실이 반영된 모습입니다. 직관적으로도 이것이 DID의 반사실 추세 추정을 망가뜨려 추세를 실제보다 가파르게 만들리라는 것을 짐작할 수 있습니다. 이를 시각화하기 위해 네 번째 비교에서 후기 처치 코호트의 반사실 \(Y_0\) 추정값을 그려 보겠습니다.
첫 번째 항은 앞에서 본 것과 같은 여러 DID 비교의 분산 가중 ATT(variance weighted ATT)입니다. 이것이 바로 원하는 값입니다. 그런데 \(\Delta ATT\)라는 항이 하나 더 붙어 있습니다. 이 항은 ATT가 시간에 따라 얼마나 변하는지를 나타내며, 추정값을 편향시키는 주범입니다. 이 항을 보면 효과의 크기가 시간이 지나며 커지면(이 예처럼) 하향 편향이, 시간이 지나며 작아지면 상향 편향이 생긴다는 것을 알 수 있습니다.
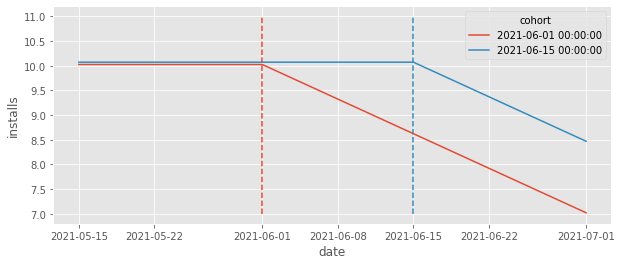
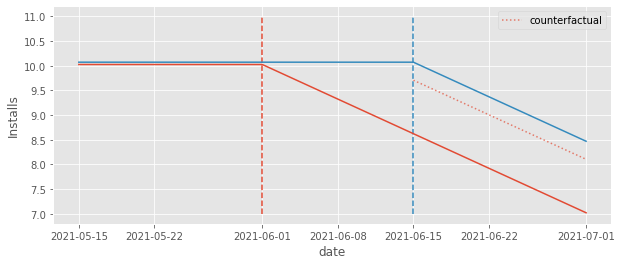
위 예에서는 TWFE로 구한 효과가 실제 ATT보다 작았습니다. 하지만 상황은 훨씬 더 극단적일 수도 있습니다. 마지막으로 예를 하나 더 보겠습니다. 이 편향이 실제 ATT의 부호를 뒤집을 만큼 강할 수 있다는 것을 보여 주는 예입니다. 코호트가 두 개뿐인 아주 단순한 과정을 생각해 봅시다. 여기서는 처치효과가 음수이고 매일 0.1씩 줄어듭니다. 무슨 일이 일어나는지 제대로 보이도록 시간 고정효과와 추세도 모두 없앴습니다.
반사실의 수준이 있어야 할 자리보다 아래로 밀려나 있습니다. 조기 처치 코호트의 효과가 줄어들고 있어서 이 수준이 10에서 약 9.5로 내려갔습니다. 그뿐 아니라 반사실은 있어서는 안 될 하향 추세까지 반영합니다. 그래프를 보면 올바른 반사실이 10 높이의 직선이어야 한다는 것이 분명하지만, 실제로는 대조군으로 쓰는 조기 처치 코호트에서 본 대로 우하향하는 선이 그려졌습니다.
그 결과 반사실 \(Y_0\)가 실제 결과 \(Y_1\)보다 아래에 놓여서 효과가 양수로 추정됩니다. 꽤 민망한 상황입니다. 그래프만 봐도 올바른 반사실이 어디쯤 있어야 하는지(10 높이의 직선) 거의 알 수 있습니다. 그런데도 TWFE는 그 반사실을 찾아내지 못합니다. 순전히 조기 처치 코호트를 후기 처치 코호트의 대조군으로 쓰기 때문입니다.
이벤트 스터디 설계
미리 짚고 넘어가겠습니다. 이벤트 스터디 설계(event study design)로 이 문제를 쉽게 풀 수 있다고 생각하는 분이 있을 것입니다. 처치 전후 각 기간마다 더미를 하나씩 추가하는 방식입니다. 이 경우 원래 TWFE 모델을 다음 모델로 바꿉니다.
여기서 \(D^k_{i,t}=1\{t-\text{Cohort}_i=k\}\)는 대상이 처치 시점에서 k 기간 떨어져 있으면 1, 아니면 0인 이벤트 스터디 더미입니다. 지저분하고 복잡해 보이지만 코드로 보면 사실 아주 간단합니다. 대상이 처치가 시작된 시점에서 얼마나 떨어져 있는지 재는 relative_days 열만 만들면 됩니다.
그다음 이 열을 범주형 변수로 넣으면 모델이 처치 시점 대비 각 기간의 기대 설치 수를 추정합니다. 그러면 효과를 처치 직전 마지막 날인 상대 일수 -1과 비교해 늘어난 기대 설치 수로 정의할 수 있습니다.
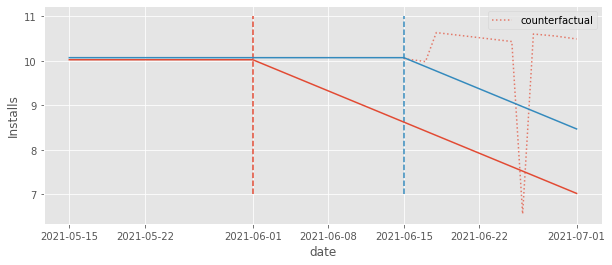
이렇게 하면 ATT의 시간 이질성을 포착해 모든 문제가 해결될 것 같습니다. 안타깝게도 그렇지 않습니다. 실제로 돌려서 반사실을 그려 보면, 직관적으로 있어야 할 자리(11 높이의 수평선)와 한참 떨어져 있습니다.
# remove the intercept, otherwise effects will be relative to relative day -30formula =f"installs ~ -1 + C(relative_days) + C(date) + C(unit)"twfe_model = smf.ols(formula, data=df_min_rel).fit()
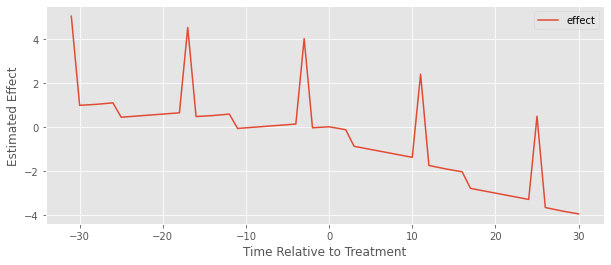
그래도 이 반사실은 조금 나아졌습니다. 실제로 관측된 결과 \(Y_1\)보다 위에 있으니까요. 그 덕분에 적어도 효과를 제대로 음수로 추정하기는 합니다. 이를 확인하기 위해 각 더미에 해당하는 매개변수를 뽑은 다음, 상대 일수 -1(기준점)에 해당하는 매개변수를 빼서 추정된 효과를 그려 보겠습니다.
코드
effects = (twfe_model.params[twfe_model.params.index.str.contains("relative_days")] .reset_index() .rename(columns={0:"effect"}) .assign(relative_day=lambda d: d["index"].str.extract(r'\[(.*)\]').astype(int))# set the baseline to period -1 .assign(effect =lambda d: d["effect"] - d.query("relative_day==-1")["effect"].iloc[0]))# effectseffects.plot(x="relative_day", y="effect", figsize=(10,4))plt.ylabel("Estimated Effect")plt.xlabel("Time Relative to Treatment");
처치 후 추정 효과가 1) 대체로 음수이고 2) 대체로 줄어들고 있으니 조금 나아진 것은 맞습니다. 하지만 이상하게 튀는 값들이 있고, 처치 전에 양의 효과가 있는 것처럼 보이는데, 이는 당연히 말이 안 됩니다.
문제는 지금까지 이야기한 것과 같습니다. 처치 시점이 서로 다르기 때문에 조기 처치 대상이 후기 처치 대상의 대조군으로 쓰이고, 그래서 모델이 아주 이상한 반사실 추세를 추정합니다. 결국 처치 시점 대비 상대 시간 더미를 추가해도 문제는 풀리지 않습니다. 그렇다면 무엇이 문제를 풀어 줄까요?
3) 깨달음: 유연한 함수 형태
좋은 소식과 나쁜 소식이 있습니다. 좋은 소식부터 말하면, 문제가 함수 형태와 관련되어 있다는 것을 알아냈으니 그 형태를 고치면 문제를 해결할 수 있습니다. 앞에서 TWFE의 이 편향이 시간에 따른 이질적 효과에서 온다고 거듭 말했습니다. 이런 이질성은 여러 이유로 생길 수 있는데, 그중 하나가 효과가 무르익는 데 시간이 걸리는 경우입니다(예: 마케팅 캠페인이 제 효과를 다 내기까지 10일이 걸릴 수 있습니다). 다시 말해 전통적인 TWFE의 함수 형태는 이 이질성을 포착할 만큼 유연하지 않고, 그래서 앞에서 본 편향이 생깁니다. 대부분의 경우가 그렇듯, 문제를 알았다면 해결책에 이미 한참 다가선 셈입니다.
앞 절 끝에서 처치 시점 대비 각 기간마다 다른 효과를 허용하는 것(이벤트 스터디 설계)만으로는 부족하다는 것을 봤습니다. 통하지는 않았지만 의도는 좋았습니다. 모델을 더 유연하게 만들긴 했지만, 문제를 해결하는 방향은 아니었습니다. 모델을 그보다 더 유연하게 만들 다른 방법을 생각해야 합니다.
이를 위해 원래 예제, 즉 새 기능 출시(처치)로 늘어난 설치 수를 모델링하려던 예로 돌아가 봅시다. 단순한 TWFE 모델은 여기서 통하지 않는다는 것을 확인했습니다.
안타깝게도 이 모델은 적합할 수 없습니다. 매개변수가 데이터 포인트보다 많아지기 때문입니다. 날짜와 대상을 상호작용시키므로 대상마다, 기간마다 처치효과 매개변수가 하나씩, 모두 \(T*N\)개 생깁니다. 그런데 이는 정확히 표본 수와 같습니다! OLS는 돌아가지도 않습니다.
이제 모델의 처치효과 매개변수 개수를 줄여야 합니다. 그러려면 대상을 어떻게든 묶는 방법을 생각해야 합니다. 조금만 생각해 보면 아주 자연스러운 방법이 보입니다. 코호트로 묶는 것입니다! 한 코호트 전체의 효과는 시간에 따라 같은 패턴을 따른다는 것을 알고 있습니다. 따라서 위의 비현실적인 모델을 자연스럽게 개선하는 방법은 효과가 대상이 아니라 코호트별로 달라지도록 허용하는 것입니다.
Number of param.: 467
True Effect:  0.8544117647058823
Pred. Effect:  0.8544117647058977
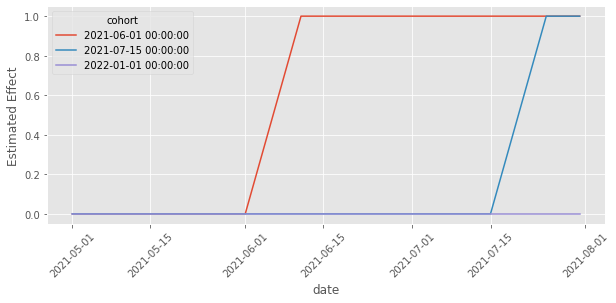
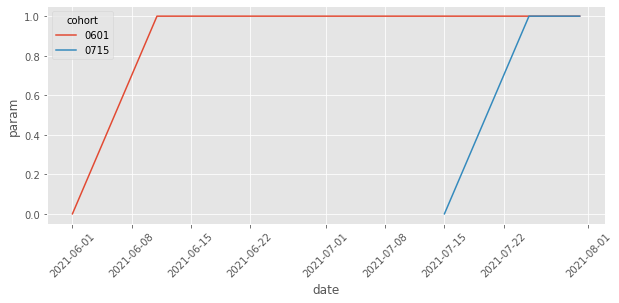
맞습니다! 마침내 시간 이질성을 포착할 만큼 유연한 모델을 만들었고, 덕분에 올바른 처치효과를 추정할 수 있었습니다! 또 하나 해 볼 만한 멋진 일은 시점과 코호트별 추정 효과를 뽑아 그래프로 그리는 것입니다. 이번에는 데이터가 어떻게 생성됐는지 알기 때문에 어떤 모양이 나와야 하는지도 압니다. 각 코호트의 효과는 처치 전에는 0, 처치 후 10일째부터는 1이어야 하고, 처치 시점부터 10일째까지는 0에서 1로 올라가는 직선이어야 합니다.
다만 이는 공식으로 구현하기가 까다로워서 먼저 특성 엔지니어링을 해야 합니다. 구체적으로, 코호트가 2021-06-01이면 1이고 아니면 0인 열과, 코호트가 2021-07-15이면 1이고 아니면 0인 열을 직접 만들어 코호트 더미로 씁니다. 또 2021-06-01 코호트용 날짜 열을 만들어 해당 코호트의 처치일 이전 날짜를 모두 control 범주로 묶습니다. 2021-07-15 코호트의 날짜도 같은 방식으로 처리할 수 있습니다. 코드로 쓰면 다음과 같습니다.
하지만 여기서 멈춰도 될 것 같습니다. 코호트별 이질성을 허용하지 않는 것은 대개 좋지 않은 생각입니다. 처치효과는 처치 후 경과 시간뿐 아니라 달력상의 시간에 따라서도 변하는 경향이 있기 때문입니다. 예를 들어 시간이 지나 경쟁사가 같은 기능을 베끼면, 그 기능은 더 이상 예전처럼 고객을 강하게 끌어들이지 못할 수 있습니다. 그렇다면 새 기능이 설치 수에 미치는 효과는 시간이 지나면서 줄어들 것입니다.
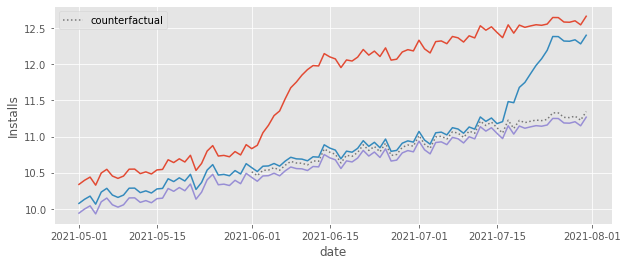
시간에 따른 효과를 보여 주는 것 말고 마지막으로 해야 할 일은 반사실을 그려서 그럴듯한 위치에 있는지 확인하는 것입니다. 모델을 과학적으로 검증하는 방법은 아니지만, 믿어 보세요. 정말 큰 도움이 됩니다. 그래프는 다음과 같습니다.
보다시피 반사실 \(Y_0\) 예측값이 있어야 할 곳, 즉 대조군 코호트와 아주 가까운 곳에 놓여 있습니다. 무척 안심이 됩니다. TWFE 모델은 처치효과를 \(Y-\hat{Y_0}\)로 추정한다는 것을 알고 있습니다. 즉, 실험군 코호트의 결과를 이 반사실과 단순히 비교할 뿐입니다. 반사실이 괜찮아 보이니 처치효과도 아마 괜찮을 것이라고 안심해도 됩니다.
여기까지가 좋은 소식입니다. 약속한 나쁜 소식을 잊은 건 아닙니다. TWFE의 함수 형태 문제는 해결했지만, DID와 TWFE에는 그보다 더 크다고도 할 만한 문제가 남아 있습니다. 바로 독립성 가정에 관한 문제입니다.
DID와 TWFE를 쓸 때는 평행 추세 가정이 정확히 무엇을 뜻하는지 깊이 생각하지 않고 그냥 가정해 버리는 경우가 많습니다. 안타깝게도 평행 추세 가정은 대부분의 사람이 생각하는 것보다 훨씬 제약이 강하고 덜 그럴듯합니다. 하지만 이 장은 이미 너무 길어졌으니, DID의 작은 승리를 아직 음미할 수 있는 여기서 마무리해도 괜찮을 것 같습니다.
핵심 요약
마침내 TWFE의 함수 형태 문제를 이해했을 뿐 아니라 바로잡는 데도 성공했다고 말해도 될 것 같습니다. 문제를 뿌리(시간 이질성)까지 추적했고, 모델에 더 많은 유연성을 허용해 고쳤습니다. 이제 TWFE를 다시 안심하고 쓸 수 있다는 것을 알았으니 한잔하며 쉬어도 됩니다. 정말 그럴까요?!
TWFE(넓게는 DID)가 함수 형태 가정과 독립성 가정이 함께 섞인 것이라는 점을 절대 잊어서는 안 됩니다. 이 장에서는 함수 형태 문제만 다뤘고, 방 안에는 아직 커다란 코끼리가 버티고 있습니다. 바로 평행 추세 가정입니다. 평행 추세는 DID가 하는 독립성 가정입니다. 여기까지는 잘 알려져 있습니다. 하지만 이 가정이 무엇을 함축하는지는 제대로 이해하지 못하고 있는 것 같습니다. 허공에서 불러내기만 하면 참이 되기라도 하는 것처럼 그냥 가정해 버리곤 합니다. 안타깝게도 평행 추세 가정은 대부분의 사람이 생각하는 것보다 훨씬 많은 것을 요구합니다. 다음 장들에서는 왜 그런지, 그리고 이에 대해 무엇을 할 수 있는지, 아니 할 수 있는 것이 있기는 한지 살펴보겠습니다.
참고 자료
이 장을 쓰는 데 (아주) 오랜 시간이 걸렸습니다. 최근 계량경제학 문헌에서는 DID의 문제와 그 해결 방법에 관한 새로운 아이디어와 통찰이 쏟아져 나오고 있습니다. 이 문제를 바라보는 각도가 여럿이고, 그에 따라 활용할 수 있는 해결 방법도 여럿입니다. 마음의 준비를 하세요. 참고 문헌 목록이 길 것입니다(그리고 아마 잘 정리되어 있지도 않을 것입니다).
먼저 Andrew Goodman-Bacon의 Difference-in-Differences with Variation in Treatment Timing에서 많은 것을 가져왔습니다. 그의 문제 진단은 아주 깔끔하고 직관적입니다. 게다가 DID에서 무슨 일이 일어나는지 명확하게 이해하게 해 준 멋진 그림들도 함께 실려 있습니다. 이 장의 그림 몇 개는 Goodman-Bacon의 그림을 거의 그대로 옮긴 것입니다.
두 번째로 큰 영감을 준 것은 Pedro H. C. Sant’Anna와 Brantly Callaway의 Difference-in-Differences with Multiple Time Periods입니다. Callaway와 Sant’Anna의 해결책은 이 장에서 택한 것과 다른 길을 간다는 점에 유의하세요. 그래도 그들의 해결책은 DID 문제를 환히 비춰 주어 이해하기 쉽게 만들어 줍니다. 논문과 별개로 Pedro는 TWFE의 문제를 보여 주는 아주 좋은 블로그 글도 썼습니다. 이 장에서 쓴 데이터 생성 과정은 그 블로그 글의 데이터 생성 과정에서 큰 영향을 받았습니다. 사실상 Pedro의 R 코드를 파이썬으로 옮긴 것입니다. Pedro는 DID 가정에 관해 제가 가졌던 몇 가지 질문에도 친절하게 답해 주었습니다. 그는 DID 모델에 공변량을 추가하는 문제를 다룬 매우 흥미로운 논문도 썼는데, 이 장이 이미 너무 길어 여기서는 다루지 않았습니다. 논문 제목은 Doubly Robust Difference-in-Differences Estimators이고, 모델에 공변량을 넣을 계획이라면 꼭 읽어 보기를 강력히 권합니다.
마지막으로 빼놓을 수 없는 자료가 있습니다. 이 장에서 쓴 함수 형태 수정은 Sun과 Abraham의 Estimating dynamic treatment effects in event studies with heterogeneous treatment effects와 Jeffrey Wooldridge의 Two-Way Fixed Effects, the Two-Way Mundlak Regression, and Difference-in-Differences Estimators에서 영감을 얻었습니다. Callaway와 Sant’Anna의 논문도 무척 좋았지만, 그들의 해결책은 구현하기가 조금 더 복잡합니다. 반면 Sun, Abraham, Wooldridge의 해결책은 TWFE 회귀 모델에서 상호작용을 영리하게 다루기만 하면 되므로, statsmodels와 공식 몇 줄만으로 아주 쉽게 구현할 수 있습니다.
위 논문들 외에 Taylor Wright가 YouTube에서 운영하는 DiD Study Group의 발표들에도 많이 기댔습니다. 저자들이 직접 설명하는 발표를 먼저 보면 위 논문들을 훨씬 쉽게 이해할 수 있습니다. 또 이 모든 내용을 하나로 엮어 준 Yiqing Xu 교수의 훌륭한 강의 시리즈 Causal Inference with Panel Data(역시 YouTube에서 볼 수 있습니다)에도 깊이 감사드립니다.
마지막으로, 저 역시 아직 배우는 중이라는 점을 기억해 주세요. 터무니없는 내용을 발견하면 언제든 이슈를 열어 주세요. 최선을 다해 바로잡겠습니다.
기여하기
Causal Inference for the Brave and True는 과학의 통계학이라 할 수 있는 인과추론을 다루는 오픈소스 자료입니다. 파이썬 기반의 무료 소프트웨어만 사용하며, 돈이 없어도, 배경지식이 많지 않아도 누구나 볼 수 있는 자료를 목표로 합니다. 이 책이 도움이 되었고 후원하고 싶다면 Patreon을 방문해 주세요. 금전적으로 기여하기 어렵다면 오타를 고치거나, 수정할 부분을 제안하거나, 이해하기 어려웠던 부분에 의견을 주는 것으로도 도울 수 있습니다. 책의 저장소에서 이슈를 열어 주세요. 마지막으로 이 내용이 마음에 들었다면 도움이 될 만한 사람들과 공유하고 GitHub에서 스타를 눌러 주세요.
의견 나누기
번역이 어색한 곳, 더 쉬운 설명, 궁금한 점을 남겨 주세요. GitHub 계정으로 로그인하면 댓글을 달 수 있고, 남긴 의견은 GitHub Discussions에 장별로 모입니다.