import matplotlib
if not hasattr(matplotlib.RcParams, "_get"):
    matplotlib.RcParams._get = dict.get
CATE with NN#
여기서는 CATE를 추정하는 다양한 방법들 중에서 Nerual Net (NN)을 사용하는 방법에 대해서 다룹니다. 그 중에서 가장 대표적인 2개의 방법론 (DragonNet, CEVAE)에 대해 다룰 예정입니다. 이를 통해 데이터의 비선형적 복잡성을 담는 NN의 장점을 사용함에 동시에 Balancing 전략을 모델에 통합 (DragonNet)하거나 관측되지 않은 교란 변수에 대한 강건성 (CEVAE)을 확보해볼 수 있습니다.
IHDP Dataset 불러오기#
이 데이터셋은 전문가의 집 방문이 미래의 인지 점수에 미치는 영향을 조사하기 위해 설계된 무작위 배정 실험으로, 일반적으로 Estimation 결과 확인을 위한 벤치마크로 사용됩니다. 여기서 True CATE 값을 알고 있다는 것이 중요한 특징입니다.
!pip install causalml -q
!pip install pyro-ppl -q
!pip install tensorflow -q
   ━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━ 620.7/620.7 MB 772.6 kB/s eta 0:00:00
   ━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━ 57.5/57.5 kB 5.6 MB/s eta 0:00:00
   ━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━ 24.5/24.5 MB 41.8 MB/s eta 0:00:00
   ━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━ 5.5/5.5 MB 133.4 MB/s eta 0:00:00
   ━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━ 6.6/6.6 MB 68.8 MB/s eta 0:00:00
   ━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━ 224.5/224.5 kB 18.0 MB/s eta 0:00:00
   ━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━ 72.5/72.5 kB 7.0 MB/s eta 0:00:00
?25h
import pandas as pd
import numpy as np
from matplotlib import pyplot as plt
import seaborn as sns
import torch

from sklearn.linear_model import LinearRegression
from sklearn.model_selection import train_test_split, StratifiedKFold
from sklearn.linear_model import LogisticRegressionCV, LogisticRegression
from sklearn.preprocessing import StandardScaler
from xgboost import XGBRegressor
from lightgbm import LGBMRegressor
from sklearn.metrics import mean_absolute_error
from sklearn.metrics import mean_squared_error as mse
from scipy.stats import entropy
import warnings

from causalml.inference.meta import LRSRegressor
from causalml.inference.meta import XGBTRegressor, MLPTRegressor
from causalml.inference.meta import BaseXRegressor, BaseRRegressor, BaseSRegressor, BaseTRegressor
from causalml.inference.tf import DragonNet
from causalml.inference.torch import CEVAE
from causalml.match import NearestNeighborMatch, MatchOptimizer, create_table_one
from causalml.propensity import ElasticNetPropensityModel
from causalml.dataset.regression import *
from causalml.metrics import *
from causalml.dataset import simulate_hidden_confounder


import os, sys

%matplotlib inline

warnings.filterwarnings('ignore')
plt.style.use('fivethirtyeight')
sns.set_palette('Paired')
plt.rcParams['figure.figsize'] = (12,8)
df = pd.read_csv(f'/content/ihdp_data.csv')
df.head()
| treatment | y_factual | y_cfactual | mu0 | mu1 | x1 | x2 | x3 | x4 | x5 | ... | x16 | x17 | x18 | x19 | x20 | x21 | x22 | x23 | x24 | x25 | |
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| 0 | True | 5.599916 | 4.318780 | 3.268256 | 6.854457 | -0.528603 | -0.343455 | 1.128554 | 0.161703 | -0.316603 | ... | 1 | 1 | 1 | 1 | 0 | 0 | 0 | 0 | 0 | 0 |
| 1 | False | 6.875856 | 7.856495 | 6.636059 | 7.562718 | -1.736945 | -1.802002 | 0.383828 | 2.244320 | -0.629189 | ... | 1 | 1 | 1 | 1 | 0 | 0 | 0 | 0 | 0 | 0 |
| 2 | False | 2.996273 | 6.633952 | 1.570536 | 6.121617 | -0.807451 | -0.202946 | -0.360898 | -0.879606 | 0.808706 | ... | 1 | 0 | 1 | 1 | 0 | 0 | 0 | 0 | 0 | 0 |
| 3 | False | 1.366206 | 5.697239 | 1.244738 | 5.889125 | 0.390083 | 0.596582 | -1.850350 | -0.879606 | -0.004017 | ... | 1 | 0 | 1 | 1 | 0 | 0 | 0 | 0 | 0 | 0 |
| 4 | False | 1.963538 | 6.202582 | 1.685048 | 6.191994 | -1.045229 | -0.602710 | 0.011465 | 0.161703 | 0.683672 | ... | 1 | 1 | 1 | 1 | 0 | 0 | 0 | 0 | 0 | 0 |
5 rows × 30 columns
df.shape
(747, 30)
df['treatment'].value_counts(normalize=True)
| proportion | |
|---|---|
| treatment | |
| False | 0.813922 |
| True | 0.186078 |
X = df.loc[:,'x1':]
treatment = df['treatment']
y = df['y_factual']
tau = df.apply(lambda d: d['y_factual'] - d['y_cfactual'] if d['treatment']==1
               else d['y_cfactual'] - d['y_factual'],
               axis=1)
mu_0 = df['mu0'].values
mu_1 = df['mu1'].values

print(tau) # CATE
0      1.281137
1      0.980638
2      3.637680
3      4.331034
4      4.239043
         ...
742    1.970030
743    1.264520
744    3.106954
745    4.477845
746    2.383340
Length: 747, dtype: float64
DragonNet#
이전 페이지에서 다룬 초기 메타러너 (S, T, X-learner 등)는 CATE 추정 문제를 여러 개의 지도 학습 문제로 분해하여 각 단계에서 ML을 사용할 수 있게 해주는 일종의 프레임워크입니다.
여기서 DragonNet은 처음부터 CATE를 하기 위해 하나의 통합적인 신경망을 구성하는 방법을 제안합니다.
모델의 핵심에 접근하기 위해 2가지 핵심 함수를 정의하면 다음과 같습니다.
조건부 결과 기대값 모델: \(Q(t, x) = \mathbb{E}[Y | T, X]\)
성향점수 모델: \(g(x) = P(T = 1|X=x)\)
이후 DragonNet 학습에 핵심이 되는 식만 확인해보면 다음과 같습니다 (Targeted Regularization 제외하고 작성):
\(\theta\): DragonNet 모델 전체의 매개변수 벡터입니다
\(Q^{\text{nn}}(t_i, x_i; \theta)\): 신경망으로 모델링된 조건부 결과 예측값입니다.
\(g^{\text{nn}}(x_i; \theta)\): 신경망으로 모델링된 성향점수 예측값입니다.
\(\alpha\): 두 손실 구성 요소의 균형을 맞추는 양의 하이퍼파라미터(\(\alpha \in \mathbb{R}_+\))입니다.
손실함수에서 조건부 결과 기대값 모델과 성향점수 모델을 활용하며, 두 모델 모두 공통의 파라미터 \(\theta\) 를 공유하고 있는 것을 확인할 수 있습니다. 이를 통해 DragonNet은 성향점수와 조건부 결과 모델을 하나의 과정으로 통합합니다.
p_model = ElasticNetPropensityModel()
p = p_model.fit_predict(X, treatment)
# ATE, CATE 모두 학습
s_learner = BaseSRegressor(LGBMRegressor(verbose=-1))
s_ate = s_learner.estimate_ate(X, treatment, y)[0]
s_cate = s_learner.fit_predict(X, treatment, y)

t_learner = BaseTRegressor(LGBMRegressor(verbose=-1))
t_ate = t_learner.estimate_ate(X, treatment, y)[0][0]
t_cate = t_learner.fit_predict(X, treatment, y)

x_learner = BaseXRegressor(LGBMRegressor(verbose=-1))
x_ate = x_learner.estimate_ate(X, treatment, y, p)[0][0]
x_cate = x_learner.fit_predict(X, treatment, y, p)

r_learner = BaseRRegressor(LGBMRegressor(verbose=-1))
r_ate = r_learner.estimate_ate(X, treatment, y, p)[0][0]
r_cate = r_learner.fit_predict(X, treatment, y, p)
dragon = DragonNet(neurons_per_layer=200, targeted_reg=True)
dragon_cate = dragon.fit_predict(X, treatment, y, return_components=False)
dragon_ate = dragon_cate.mean()
Epoch 1/30
10/10 ━━━━━━━━━━━━━━━━━━━━ 3s 38ms/step - binary_classification_loss: 38.8906 - loss: 1045.9442 - regression_loss: 496.6157 - track_epsilon: 0.0026 - treatment_accuracy: 0.8565 - val_binary_classification_loss: 32.4463 - val_loss: 330.8610 - val_regression_loss: 124.1708 - val_track_epsilon: 0.0029 - val_treatment_accuracy: 0.6600 - learning_rate: 0.0010
Epoch 2/30
10/10 ━━━━━━━━━━━━━━━━━━━━ 0s 8ms/step - binary_classification_loss: 29.9748 - loss: 311.2503 - regression_loss: 136.6996 - track_epsilon: 0.0029 - treatment_accuracy: 0.8545 - val_binary_classification_loss: 34.4365 - val_loss: 306.4351 - val_regression_loss: 109.4157 - val_track_epsilon: 0.0013 - val_treatment_accuracy: 0.6600 - learning_rate: 0.0010
Epoch 3/30
10/10 ━━━━━━━━━━━━━━━━━━━━ 0s 8ms/step - binary_classification_loss: 27.5612 - loss: 228.8221 - regression_loss: 97.4250 - track_epsilon: 0.0015 - treatment_accuracy: 0.8533 - val_binary_classification_loss: 39.5249 - val_loss: 276.7269 - val_regression_loss: 96.1091 - val_track_epsilon: 0.0032 - val_treatment_accuracy: 0.6600 - learning_rate: 0.0010
Epoch 4/30
10/10 ━━━━━━━━━━━━━━━━━━━━ 0s 8ms/step - binary_classification_loss: 26.1288 - loss: 201.3167 - regression_loss: 84.3170 - track_epsilon: 0.0033 - treatment_accuracy: 0.8576 - val_binary_classification_loss: 37.6661 - val_loss: 225.7903 - val_regression_loss: 76.3318 - val_track_epsilon: 0.0022 - val_treatment_accuracy: 0.6600 - learning_rate: 0.0010
Epoch 5/30
10/10 ━━━━━━━━━━━━━━━━━━━━ 0s 8ms/step - binary_classification_loss: 26.8660 - loss: 191.5686 - regression_loss: 79.1960 - track_epsilon: 0.0019 - treatment_accuracy: 0.8480 - val_binary_classification_loss: 37.3301 - val_loss: 229.9973 - val_regression_loss: 77.3211 - val_track_epsilon: 0.0020 - val_treatment_accuracy: 0.6600 - learning_rate: 0.0010
Epoch 6/30
10/10 ━━━━━━━━━━━━━━━━━━━━ 0s 8ms/step - binary_classification_loss: 25.1700 - loss: 194.9039 - regression_loss: 81.7031 - track_epsilon: 0.0020 - treatment_accuracy: 0.8591 - val_binary_classification_loss: 36.1045 - val_loss: 216.4850 - val_regression_loss: 72.9820 - val_track_epsilon: 0.0012 - val_treatment_accuracy: 0.6600 - learning_rate: 0.0010
Epoch 7/30
10/10 ━━━━━━━━━━━━━━━━━━━━ 0s 8ms/step - binary_classification_loss: 26.6318 - loss: 175.8050 - regression_loss: 71.6206 - track_epsilon: 0.0010 - treatment_accuracy: 0.8446 - val_binary_classification_loss: 36.2561 - val_loss: 210.7644 - val_regression_loss: 70.0139 - val_track_epsilon: 7.4851e-04 - val_treatment_accuracy: 0.6600 - learning_rate: 0.0010
Epoch 8/30
10/10 ━━━━━━━━━━━━━━━━━━━━ 0s 8ms/step - binary_classification_loss: 25.0320 - loss: 161.8783 - regression_loss: 65.5007 - track_epsilon: 5.7415e-04 - treatment_accuracy: 0.8595 - val_binary_classification_loss: 36.8202 - val_loss: 222.6556 - val_regression_loss: 73.8198 - val_track_epsilon: 1.1204e-05 - val_treatment_accuracy: 0.6600 - learning_rate: 0.0010
Epoch 9/30
10/10 ━━━━━━━━━━━━━━━━━━━━ 0s 8ms/step - binary_classification_loss: 25.2269 - loss: 166.6289 - regression_loss: 67.7366 - track_epsilon: 7.0926e-05 - treatment_accuracy: 0.8559 - val_binary_classification_loss: 36.4678 - val_loss: 201.0258 - val_regression_loss: 65.1497 - val_track_epsilon: 3.5465e-04 - val_treatment_accuracy: 0.6600 - learning_rate: 0.0010
Epoch 10/30
10/10 ━━━━━━━━━━━━━━━━━━━━ 0s 7ms/step - binary_classification_loss: 24.9552 - loss: 160.4624 - regression_loss: 64.8152 - track_epsilon: 5.0021e-04 - treatment_accuracy: 0.8581 - val_binary_classification_loss: 36.2046 - val_loss: 202.4180 - val_regression_loss: 65.2518 - val_track_epsilon: 5.5565e-04 - val_treatment_accuracy: 0.6600 - learning_rate: 0.0010
Epoch 11/30
10/10 ━━━━━━━━━━━━━━━━━━━━ 0s 8ms/step - binary_classification_loss: 24.8034 - loss: 166.6747 - regression_loss: 67.9463 - track_epsilon: 5.9733e-04 - treatment_accuracy: 0.8576 - val_binary_classification_loss: 35.1659 - val_loss: 229.9990 - val_regression_loss: 76.6490 - val_track_epsilon: 0.0014 - val_treatment_accuracy: 0.6600 - learning_rate: 0.0010
Epoch 1/100
10/10 ━━━━━━━━━━━━━━━━━━━━ 2s 37ms/step - binary_classification_loss: 24.4980 - loss: 158.9520 - regression_loss: 64.2760 - track_epsilon: 0.0020 - treatment_accuracy: 0.8588 - val_binary_classification_loss: 35.0918 - val_loss: 191.3827 - val_regression_loss: 61.7050 - val_track_epsilon: 0.0096 - val_treatment_accuracy: 0.6600 - learning_rate: 1.0000e-05
Epoch 2/100
10/10 ━━━━━━━━━━━━━━━━━━━━ 0s 7ms/step - binary_classification_loss: 24.3808 - loss: 143.6469 - regression_loss: 56.6747 - track_epsilon: 0.0106 - treatment_accuracy: 0.8589 - val_binary_classification_loss: 35.2116 - val_loss: 195.1198 - val_regression_loss: 63.0791 - val_track_epsilon: 0.0033 - val_treatment_accuracy: 0.6600 - learning_rate: 1.0000e-05
Epoch 3/100
10/10 ━━━━━━━━━━━━━━━━━━━━ 0s 8ms/step - binary_classification_loss: 24.7241 - loss: 143.9115 - regression_loss: 56.4802 - track_epsilon: 0.0029 - treatment_accuracy: 0.8512 - val_binary_classification_loss: 35.0788 - val_loss: 193.6483 - val_regression_loss: 62.2279 - val_track_epsilon: 0.0034 - val_treatment_accuracy: 0.6600 - learning_rate: 1.0000e-05
Epoch 4/100
10/10 ━━━━━━━━━━━━━━━━━━━━ 0s 8ms/step - binary_classification_loss: 23.6331 - loss: 146.4915 - regression_loss: 58.5213 - track_epsilon: 0.0023 - treatment_accuracy: 0.8628 - val_binary_classification_loss: 35.1773 - val_loss: 193.8194 - val_regression_loss: 62.6024 - val_track_epsilon: 0.0013 - val_treatment_accuracy: 0.6600 - learning_rate: 1.0000e-05
Epoch 5/100
10/10 ━━━━━━━━━━━━━━━━━━━━ 0s 7ms/step - binary_classification_loss: 24.2273 - loss: 139.5304 - regression_loss: 54.6600 - track_epsilon: 0.0039 - treatment_accuracy: 0.8621 - val_binary_classification_loss: 35.1423 - val_loss: 188.0599 - val_regression_loss: 60.0698 - val_track_epsilon: 0.0044 - val_treatment_accuracy: 0.6600 - learning_rate: 1.0000e-05
Epoch 6/100
10/10 ━━━━━━━━━━━━━━━━━━━━ 0s 7ms/step - binary_classification_loss: 24.3732 - loss: 137.5845 - regression_loss: 53.8015 - track_epsilon: 0.0033 - treatment_accuracy: 0.8603 - val_binary_classification_loss: 35.0841 - val_loss: 190.0379 - val_regression_loss: 61.0045 - val_track_epsilon: 0.0027 - val_treatment_accuracy: 0.6600 - learning_rate: 1.0000e-05
Epoch 7/100
10/10 ━━━━━━━━━━━━━━━━━━━━ 0s 7ms/step - binary_classification_loss: 24.0860 - loss: 141.5981 - regression_loss: 55.6967 - track_epsilon: 0.0017 - treatment_accuracy: 0.8605 - val_binary_classification_loss: 35.0182 - val_loss: 191.6184 - val_regression_loss: 61.3945 - val_track_epsilon: 0.0046 - val_treatment_accuracy: 0.6600 - learning_rate: 1.0000e-05
Epoch 8/100
10/10 ━━━━━━━━━━━━━━━━━━━━ 0s 8ms/step - binary_classification_loss: 24.2123 - loss: 140.5520 - regression_loss: 55.1680 - track_epsilon: 0.0067 - treatment_accuracy: 0.8572 - val_binary_classification_loss: 35.0245 - val_loss: 186.5452 - val_regression_loss: 59.8145 - val_track_epsilon: 0.0012 - val_treatment_accuracy: 0.6600 - learning_rate: 1.0000e-05
Epoch 9/100
10/10 ━━━━━━━━━━━━━━━━━━━━ 0s 7ms/step - binary_classification_loss: 26.5932 - loss: 156.1333 - regression_loss: 61.7626 - track_epsilon: 7.5489e-04 - treatment_accuracy: 0.8327 - val_binary_classification_loss: 35.0251 - val_loss: 189.3139 - val_regression_loss: 60.7792 - val_track_epsilon: 2.7119e-04 - val_treatment_accuracy: 0.6600 - learning_rate: 1.0000e-05
Epoch 10/100
10/10 ━━━━━━━━━━━━━━━━━━━━ 0s 7ms/step - binary_classification_loss: 23.3189 - loss: 143.1658 - regression_loss: 56.8826 - track_epsilon: 0.0022 - treatment_accuracy: 0.8641 - val_binary_classification_loss: 35.0370 - val_loss: 187.0264 - val_regression_loss: 59.7568 - val_track_epsilon: 0.0023 - val_treatment_accuracy: 0.6600 - learning_rate: 1.0000e-05
Epoch 11/100
 1/10 ━━━━━━━━━━━━━━━━━━━━ 0s 17ms/step - binary_classification_loss: 21.4816 - loss: 99.2698 - regression_loss: 36.5202 - track_epsilon: 0.0023 - treatment_accuracy: 0.8750
Epoch 11: ReduceLROnPlateau reducing learning rate to 4.999999873689376e-06.
10/10 ━━━━━━━━━━━━━━━━━━━━ 0s 7ms/step - binary_classification_loss: 24.7100 - loss: 141.8635 - regression_loss: 55.6284 - track_epsilon: 0.0023 - treatment_accuracy: 0.8527 - val_binary_classification_loss: 35.0239 - val_loss: 188.9475 - val_regression_loss: 60.5899 - val_track_epsilon: 0.0027 - val_treatment_accuracy: 0.6600 - learning_rate: 1.0000e-05
Epoch 12/100
10/10 ━━━━━━━━━━━━━━━━━━━━ 0s 7ms/step - binary_classification_loss: 23.2656 - loss: 140.3779 - regression_loss: 55.6008 - track_epsilon: 0.0032 - treatment_accuracy: 0.8663 - val_binary_classification_loss: 34.9584 - val_loss: 186.8442 - val_regression_loss: 59.6546 - val_track_epsilon: 0.0035 - val_treatment_accuracy: 0.6600 - learning_rate: 5.0000e-06
Epoch 13/100
10/10 ━━━━━━━━━━━━━━━━━━━━ 0s 7ms/step - binary_classification_loss: 27.8032 - loss: 155.1326 - regression_loss: 60.7678 - track_epsilon: 0.0032 - treatment_accuracy: 0.8259 - val_binary_classification_loss: 34.8197 - val_loss: 187.7223 - val_regression_loss: 60.2678 - val_track_epsilon: 0.0028 - val_treatment_accuracy: 0.6600 - learning_rate: 5.0000e-06
Epoch 14/100
10/10 ━━━━━━━━━━━━━━━━━━━━ 0s 7ms/step - binary_classification_loss: 23.9000 - loss: 144.3947 - regression_loss: 57.2941 - track_epsilon: 0.0037 - treatment_accuracy: 0.8652 - val_binary_classification_loss: 34.9176 - val_loss: 188.5710 - val_regression_loss: 60.4243 - val_track_epsilon: 0.0033 - val_treatment_accuracy: 0.6600 - learning_rate: 5.0000e-06
Epoch 15/100
10/10 ━━━━━━━━━━━━━━━━━━━━ 0s 7ms/step - binary_classification_loss: 24.8076 - loss: 136.3719 - regression_loss: 53.0721 - track_epsilon: 0.0031 - treatment_accuracy: 0.8535 - val_binary_classification_loss: 34.9030 - val_loss: 187.9622 - val_regression_loss: 60.3387 - val_track_epsilon: 0.0020 - val_treatment_accuracy: 0.6600 - learning_rate: 5.0000e-06
Epoch 16/100
10/10 ━━━━━━━━━━━━━━━━━━━━ 0s 8ms/step - binary_classification_loss: 24.2419 - loss: 139.7992 - regression_loss: 54.8528 - track_epsilon: 0.0018 - treatment_accuracy: 0.8564 - val_binary_classification_loss: 34.8842 - val_loss: 188.0038 - val_regression_loss: 60.3882 - val_track_epsilon: 0.0016 - val_treatment_accuracy: 0.6600 - learning_rate: 5.0000e-06
Epoch 17/100
10/10 ━━━━━━━━━━━━━━━━━━━━ 0s 7ms/step - binary_classification_loss: 25.4555 - loss: 138.2022 - regression_loss: 53.4446 - track_epsilon: 0.0019 - treatment_accuracy: 0.8474 - val_binary_classification_loss: 34.9000 - val_loss: 186.8883 - val_regression_loss: 59.7959 - val_track_epsilon: 0.0023 - val_treatment_accuracy: 0.6600 - learning_rate: 5.0000e-06
Epoch 18/100
10/10 ━━━━━━━━━━━━━━━━━━━━ 0s 7ms/step - binary_classification_loss: 25.4380 - loss: 137.5853 - regression_loss: 53.1633 - track_epsilon: 0.0027 - treatment_accuracy: 0.8497 - val_binary_classification_loss: 34.8922 - val_loss: 189.4339 - val_regression_loss: 60.7790 - val_track_epsilon: 0.0031 - val_treatment_accuracy: 0.6600 - learning_rate: 5.0000e-06
Epoch 19/100
10/10 ━━━━━━━━━━━━━━━━━━━━ 0s 7ms/step - binary_classification_loss: 25.5709 - loss: 138.8564 - regression_loss: 53.8704 - track_epsilon: 0.0031 - treatment_accuracy: 0.8464 - val_binary_classification_loss: 34.7804 - val_loss: 186.1421 - val_regression_loss: 59.6816 - val_track_epsilon: 0.0021 - val_treatment_accuracy: 0.6600 - learning_rate: 5.0000e-06
Epoch 20/100
 1/10 ━━━━━━━━━━━━━━━━━━━━ 0s 18ms/step - binary_classification_loss: 25.3204 - loss: 133.1541 - regression_loss: 51.6016 - track_epsilon: 0.0021 - treatment_accuracy: 0.8125
Epoch 20: ReduceLROnPlateau reducing learning rate to 2.499999936844688e-06.
10/10 ━━━━━━━━━━━━━━━━━━━━ 0s 7ms/step - binary_classification_loss: 25.0030 - loss: 138.2794 - regression_loss: 53.7011 - track_epsilon: 0.0023 - treatment_accuracy: 0.8455 - val_binary_classification_loss: 34.7991 - val_loss: 187.5217 - val_regression_loss: 60.1817 - val_track_epsilon: 0.0021 - val_treatment_accuracy: 0.6600 - learning_rate: 5.0000e-06
Epoch 21/100
10/10 ━━━━━━━━━━━━━━━━━━━━ 0s 7ms/step - binary_classification_loss: 25.3699 - loss: 146.6443 - regression_loss: 57.8397 - track_epsilon: 0.0015 - treatment_accuracy: 0.8424 - val_binary_classification_loss: 34.7928 - val_loss: 186.1373 - val_regression_loss: 59.8630 - val_track_epsilon: 0.0015 - val_treatment_accuracy: 0.6600 - learning_rate: 2.5000e-06
Epoch 22/100
10/10 ━━━━━━━━━━━━━━━━━━━━ 0s 7ms/step - binary_classification_loss: 25.1222 - loss: 146.9540 - regression_loss: 58.0607 - track_epsilon: 0.0018 - treatment_accuracy: 0.8500 - val_binary_classification_loss: 34.8027 - val_loss: 188.4026 - val_regression_loss: 60.6035 - val_track_epsilon: 0.0030 - val_treatment_accuracy: 0.6600 - learning_rate: 2.5000e-06
Epoch 23/100
10/10 ━━━━━━━━━━━━━━━━━━━━ 0s 7ms/step - binary_classification_loss: 25.5273 - loss: 128.1018 - regression_loss: 48.3751 - track_epsilon: 0.0035 - treatment_accuracy: 0.8464 - val_binary_classification_loss: 34.7450 - val_loss: 187.8200 - val_regression_loss: 60.2576 - val_track_epsilon: 0.0041 - val_treatment_accuracy: 0.6600 - learning_rate: 2.5000e-06
Epoch 24/100
10/10 ━━━━━━━━━━━━━━━━━━━━ 0s 7ms/step - binary_classification_loss: 22.6358 - loss: 134.5116 - regression_loss: 52.9223 - track_epsilon: 0.0039 - treatment_accuracy: 0.8742 - val_binary_classification_loss: 34.8256 - val_loss: 186.5610 - val_regression_loss: 59.6903 - val_track_epsilon: 0.0030 - val_treatment_accuracy: 0.6600 - learning_rate: 2.5000e-06
Epoch 25/100
 1/10 ━━━━━━━━━━━━━━━━━━━━ 0s 17ms/step - binary_classification_loss: 18.7227 - loss: 159.7252 - regression_loss: 68.1071 - track_epsilon: 0.0030 - treatment_accuracy: 0.8906
Epoch 25: ReduceLROnPlateau reducing learning rate to 1.249999968422344e-06.
10/10 ━━━━━━━━━━━━━━━━━━━━ 0s 7ms/step - binary_classification_loss: 25.4757 - loss: 147.5765 - regression_loss: 58.1493 - track_epsilon: 0.0026 - treatment_accuracy: 0.8421 - val_binary_classification_loss: 34.7849 - val_loss: 186.8231 - val_regression_loss: 59.9196 - val_track_epsilon: 0.0021 - val_treatment_accuracy: 0.6600 - learning_rate: 2.5000e-06
Epoch 26/100
10/10 ━━━━━━━━━━━━━━━━━━━━ 0s 7ms/step - binary_classification_loss: 25.9484 - loss: 151.2017 - regression_loss: 59.7051 - track_epsilon: 0.0023 - treatment_accuracy: 0.8413 - val_binary_classification_loss: 34.7949 - val_loss: 188.3563 - val_regression_loss: 60.4447 - val_track_epsilon: 0.0029 - val_treatment_accuracy: 0.6600 - learning_rate: 1.2500e-06
Epoch 27/100
10/10 ━━━━━━━━━━━━━━━━━━━━ 0s 7ms/step - binary_classification_loss: 26.7497 - loss: 144.5747 - regression_loss: 56.0167 - track_epsilon: 0.0030 - treatment_accuracy: 0.8346 - val_binary_classification_loss: 34.7545 - val_loss: 187.6957 - val_regression_loss: 60.2511 - val_track_epsilon: 0.0030 - val_treatment_accuracy: 0.6600 - learning_rate: 1.2500e-06
Epoch 28/100
10/10 ━━━━━━━━━━━━━━━━━━━━ 0s 7ms/step - binary_classification_loss: 22.8699 - loss: 144.9562 - regression_loss: 58.1082 - track_epsilon: 0.0031 - treatment_accuracy: 0.8724 - val_binary_classification_loss: 34.7797 - val_loss: 187.7472 - val_regression_loss: 60.2151 - val_track_epsilon: 0.0032 - val_treatment_accuracy: 0.6600 - learning_rate: 1.2500e-06
Epoch 29/100
10/10 ━━━━━━━━━━━━━━━━━━━━ 0s 7ms/step - binary_classification_loss: 25.7131 - loss: 139.3827 - regression_loss: 53.9119 - track_epsilon: 0.0030 - treatment_accuracy: 0.8408 - val_binary_classification_loss: 34.8102 - val_loss: 187.5173 - val_regression_loss: 60.1224 - val_track_epsilon: 0.0025 - val_treatment_accuracy: 0.6600 - learning_rate: 1.2500e-06
Epoch 30/100
 1/10 ━━━━━━━━━━━━━━━━━━━━ 0s 17ms/step - binary_classification_loss: 24.0362 - loss: 139.0613 - regression_loss: 55.1215 - track_epsilon: 0.0025 - treatment_accuracy: 0.8594
Epoch 30: ReduceLROnPlateau reducing learning rate to 6.24999984211172e-07.
10/10 ━━━━━━━━━━━━━━━━━━━━ 0s 7ms/step - binary_classification_loss: 24.4685 - loss: 145.2897 - regression_loss: 57.4073 - track_epsilon: 0.0025 - treatment_accuracy: 0.8553 - val_binary_classification_loss: 34.8101 - val_loss: 187.8838 - val_regression_loss: 60.2389 - val_track_epsilon: 0.0027 - val_treatment_accuracy: 0.6600 - learning_rate: 1.2500e-06
Epoch 31/100
10/10 ━━━━━━━━━━━━━━━━━━━━ 0s 7ms/step - binary_classification_loss: 25.8034 - loss: 140.0718 - regression_loss: 54.2198 - track_epsilon: 0.0027 - treatment_accuracy: 0.8381 - val_binary_classification_loss: 34.7995 - val_loss: 188.3135 - val_regression_loss: 60.4409 - val_track_epsilon: 0.0027 - val_treatment_accuracy: 0.6600 - learning_rate: 6.2500e-07
Epoch 32/100
10/10 ━━━━━━━━━━━━━━━━━━━━ 0s 7ms/step - binary_classification_loss: 25.1525 - loss: 130.0241 - regression_loss: 49.6135 - track_epsilon: 0.0027 - treatment_accuracy: 0.8538 - val_binary_classification_loss: 34.7890 - val_loss: 188.1193 - val_regression_loss: 60.3926 - val_track_epsilon: 0.0027 - val_treatment_accuracy: 0.6600 - learning_rate: 6.2500e-07
Epoch 33/100
10/10 ━━━━━━━━━━━━━━━━━━━━ 0s 7ms/step - binary_classification_loss: 25.5907 - loss: 147.2796 - regression_loss: 57.9523 - track_epsilon: 0.0027 - treatment_accuracy: 0.8409 - val_binary_classification_loss: 34.7825 - val_loss: 187.6183 - val_regression_loss: 60.1845 - val_track_epsilon: 0.0028 - val_treatment_accuracy: 0.6600 - learning_rate: 6.2500e-07
Epoch 34/100
10/10 ━━━━━━━━━━━━━━━━━━━━ 0s 7ms/step - binary_classification_loss: 24.5242 - loss: 139.6033 - regression_loss: 54.5526 - track_epsilon: 0.0028 - treatment_accuracy: 0.8576 - val_binary_classification_loss: 34.7819 - val_loss: 187.5185 - val_regression_loss: 60.1603 - val_track_epsilon: 0.0026 - val_treatment_accuracy: 0.6600 - learning_rate: 6.2500e-07
Epoch 35/100
 1/10 ━━━━━━━━━━━━━━━━━━━━ 0s 19ms/step - binary_classification_loss: 21.5774 - loss: 126.0081 - regression_loss: 49.8955 - track_epsilon: 0.0026 - treatment_accuracy: 0.9062
Epoch 35: ReduceLROnPlateau reducing learning rate to 3.12499992105586e-07.
10/10 ━━━━━━━━━━━━━━━━━━━━ 0s 7ms/step - binary_classification_loss: 25.2463 - loss: 140.1434 - regression_loss: 54.4833 - track_epsilon: 0.0026 - treatment_accuracy: 0.8515 - val_binary_classification_loss: 34.7786 - val_loss: 187.2883 - val_regression_loss: 60.0791 - val_track_epsilon: 0.0026 - val_treatment_accuracy: 0.6600 - learning_rate: 6.2500e-07
Epoch 36/100
10/10 ━━━━━━━━━━━━━━━━━━━━ 0s 7ms/step - binary_classification_loss: 24.7398 - loss: 142.4549 - regression_loss: 55.8361 - track_epsilon: 0.0026 - treatment_accuracy: 0.8503 - val_binary_classification_loss: 34.7726 - val_loss: 187.4140 - val_regression_loss: 60.1279 - val_track_epsilon: 0.0027 - val_treatment_accuracy: 0.6600 - learning_rate: 3.1250e-07
Epoch 37/100
10/10 ━━━━━━━━━━━━━━━━━━━━ 0s 7ms/step - binary_classification_loss: 23.4822 - loss: 144.0297 - regression_loss: 57.2327 - track_epsilon: 0.0027 - treatment_accuracy: 0.8654 - val_binary_classification_loss: 34.7825 - val_loss: 187.7382 - val_regression_loss: 60.2532 - val_track_epsilon: 0.0026 - val_treatment_accuracy: 0.6600 - learning_rate: 3.1250e-07
Epoch 38/100
10/10 ━━━━━━━━━━━━━━━━━━━━ 0s 8ms/step - binary_classification_loss: 24.5076 - loss: 144.9143 - regression_loss: 57.2103 - track_epsilon: 0.0026 - treatment_accuracy: 0.8561 - val_binary_classification_loss: 34.7791 - val_loss: 187.5579 - val_regression_loss: 60.1800 - val_track_epsilon: 0.0027 - val_treatment_accuracy: 0.6600 - learning_rate: 3.1250e-07
Epoch 39/100
10/10 ━━━━━━━━━━━━━━━━━━━━ 0s 7ms/step - binary_classification_loss: 25.6274 - loss: 138.8798 - regression_loss: 53.6918 - track_epsilon: 0.0026 - treatment_accuracy: 0.8395 - val_binary_classification_loss: 34.7802 - val_loss: 187.6791 - val_regression_loss: 60.2303 - val_track_epsilon: 0.0026 - val_treatment_accuracy: 0.6600 - learning_rate: 3.1250e-07
Epoch 40/100
10/10 ━━━━━━━━━━━━━━━━━━━━ 0s 7ms/step - binary_classification_loss: 25.2078 - loss: 148.7974 - regression_loss: 58.9622 - track_epsilon: 0.0026 - treatment_accuracy: 0.8500 - val_binary_classification_loss: 34.7827 - val_loss: 187.5798 - val_regression_loss: 60.1830 - val_track_epsilon: 0.0026 - val_treatment_accuracy: 0.6600 - learning_rate: 3.1250e-07
Epoch 41/100
10/10 ━━━━━━━━━━━━━━━━━━━━ 0s 7ms/step - binary_classification_loss: 24.3138 - loss: 133.1260 - regression_loss: 51.5553 - track_epsilon: 0.0026 - treatment_accuracy: 0.8514 - val_binary_classification_loss: 34.7822 - val_loss: 187.6092 - val_regression_loss: 60.1928 - val_track_epsilon: 0.0026 - val_treatment_accuracy: 0.6600 - learning_rate: 3.1250e-07
Epoch 42/100
10/10 ━━━━━━━━━━━━━━━━━━━━ 0s 7ms/step - binary_classification_loss: 25.3131 - loss: 144.7697 - regression_loss: 56.9369 - track_epsilon: 0.0026 - treatment_accuracy: 0.8502 - val_binary_classification_loss: 34.7846 - val_loss: 187.6221 - val_regression_loss: 60.1941 - val_track_epsilon: 0.0026 - val_treatment_accuracy: 0.6600 - learning_rate: 3.1250e-07
Epoch 43/100
10/10 ━━━━━━━━━━━━━━━━━━━━ 0s 7ms/step - binary_classification_loss: 26.2768 - loss: 148.8574 - regression_loss: 58.4494 - track_epsilon: 0.0026 - treatment_accuracy: 0.8389 - val_binary_classification_loss: 34.7798 - val_loss: 187.6562 - val_regression_loss: 60.2178 - val_track_epsilon: 0.0026 - val_treatment_accuracy: 0.6600 - learning_rate: 3.1250e-07
Epoch 44/100
10/10 ━━━━━━━━━━━━━━━━━━━━ 0s 8ms/step - binary_classification_loss: 24.8930 - loss: 143.8273 - regression_loss: 56.5760 - track_epsilon: 0.0026 - treatment_accuracy: 0.8521 - val_binary_classification_loss: 34.7842 - val_loss: 187.8663 - val_regression_loss: 60.2844 - val_track_epsilon: 0.0027 - val_treatment_accuracy: 0.6600 - learning_rate: 3.1250e-07
Epoch 45/100
10/10 ━━━━━━━━━━━━━━━━━━━━ 0s 7ms/step - binary_classification_loss: 24.4419 - loss: 138.5775 - regression_loss: 54.1605 - track_epsilon: 0.0027 - treatment_accuracy: 0.8532 - val_binary_classification_loss: 34.7776 - val_loss: 187.7103 - val_regression_loss: 60.2290 - val_track_epsilon: 0.0027 - val_treatment_accuracy: 0.6600 - learning_rate: 3.1250e-07
Epoch 46/100
10/10 ━━━━━━━━━━━━━━━━━━━━ 0s 7ms/step - binary_classification_loss: 24.4046 - loss: 130.9614 - regression_loss: 50.3174 - track_epsilon: 0.0027 - treatment_accuracy: 0.8562 - val_binary_classification_loss: 34.7786 - val_loss: 187.5651 - val_regression_loss: 60.1773 - val_track_epsilon: 0.0027 - val_treatment_accuracy: 0.6600 - learning_rate: 3.1250e-07
Epoch 47/100
 1/10 ━━━━━━━━━━━━━━━━━━━━ 0s 17ms/step - binary_classification_loss: 23.8146 - loss: 135.6529 - regression_loss: 53.5604 - track_epsilon: 0.0027 - treatment_accuracy: 0.8594
Epoch 47: ReduceLROnPlateau reducing learning rate to 1.56249996052793e-07.
10/10 ━━━━━━━━━━━━━━━━━━━━ 0s 7ms/step - binary_classification_loss: 24.7528 - loss: 138.1523 - regression_loss: 53.7688 - track_epsilon: 0.0026 - treatment_accuracy: 0.8501 - val_binary_classification_loss: 34.7757 - val_loss: 187.6216 - val_regression_loss: 60.2046 - val_track_epsilon: 0.0026 - val_treatment_accuracy: 0.6600 - learning_rate: 3.1250e-07
Epoch 48/100
10/10 ━━━━━━━━━━━━━━━━━━━━ 0s 7ms/step - binary_classification_loss: 25.3645 - loss: 143.4071 - regression_loss: 56.1377 - track_epsilon: 0.0026 - treatment_accuracy: 0.8457 - val_binary_classification_loss: 34.7785 - val_loss: 187.6418 - val_regression_loss: 60.2046 - val_track_epsilon: 0.0027 - val_treatment_accuracy: 0.6600 - learning_rate: 1.5625e-07
Epoch 49/100
10/10 ━━━━━━━━━━━━━━━━━━━━ 0s 7ms/step - binary_classification_loss: 25.5301 - loss: 137.7317 - regression_loss: 53.1371 - track_epsilon: 0.0027 - treatment_accuracy: 0.8447 - val_binary_classification_loss: 34.7783 - val_loss: 187.5739 - val_regression_loss: 60.1796 - val_track_epsilon: 0.0026 - val_treatment_accuracy: 0.6600 - learning_rate: 1.5625e-07
Epoch 50/100
10/10 ━━━━━━━━━━━━━━━━━━━━ 0s 8ms/step - binary_classification_loss: 27.3254 - loss: 146.6487 - regression_loss: 56.7810 - track_epsilon: 0.0026 - treatment_accuracy: 0.8294 - val_binary_classification_loss: 34.7810 - val_loss: 187.6270 - val_regression_loss: 60.1975 - val_track_epsilon: 0.0026 - val_treatment_accuracy: 0.6600 - learning_rate: 1.5625e-07
Epoch 51/100
10/10 ━━━━━━━━━━━━━━━━━━━━ 0s 7ms/step - binary_classification_loss: 24.9671 - loss: 145.3769 - regression_loss: 57.1598 - track_epsilon: 0.0026 - treatment_accuracy: 0.8488 - val_binary_classification_loss: 34.7772 - val_loss: 187.5700 - val_regression_loss: 60.1796 - val_track_epsilon: 0.0026 - val_treatment_accuracy: 0.6600 - learning_rate: 1.5625e-07
Epoch 52/100
 1/10 ━━━━━━━━━━━━━━━━━━━━ 0s 17ms/step - binary_classification_loss: 17.1951 - loss: 118.9898 - regression_loss: 48.4751 - track_epsilon: 0.0026 - treatment_accuracy: 0.9219
Epoch 52: ReduceLROnPlateau reducing learning rate to 7.81249980263965e-08.
10/10 ━━━━━━━━━━━━━━━━━━━━ 0s 7ms/step - binary_classification_loss: 23.4069 - loss: 134.6707 - regression_loss: 52.7760 - track_epsilon: 0.0026 - treatment_accuracy: 0.8643 - val_binary_classification_loss: 34.7801 - val_loss: 187.5614 - val_regression_loss: 60.1716 - val_track_epsilon: 0.0026 - val_treatment_accuracy: 0.6600 - learning_rate: 1.5625e-07
Epoch 53/100
10/10 ━━━━━━━━━━━━━━━━━━━━ 0s 7ms/step - binary_classification_loss: 24.0682 - loss: 137.4814 - regression_loss: 53.6498 - track_epsilon: 0.0026 - treatment_accuracy: 0.8569 - val_binary_classification_loss: 34.7815 - val_loss: 187.6227 - val_regression_loss: 60.1905 - val_track_epsilon: 0.0026 - val_treatment_accuracy: 0.6600 - learning_rate: 7.8125e-08
Epoch 54/100
10/10 ━━━━━━━━━━━━━━━━━━━━ 0s 7ms/step - binary_classification_loss: 24.1104 - loss: 136.7161 - regression_loss: 53.2499 - track_epsilon: 0.0026 - treatment_accuracy: 0.8650 - val_binary_classification_loss: 34.7813 - val_loss: 187.6559 - val_regression_loss: 60.2043 - val_track_epsilon: 0.0026 - val_treatment_accuracy: 0.6600 - learning_rate: 7.8125e-08
Epoch 55/100
10/10 ━━━━━━━━━━━━━━━━━━━━ 0s 7ms/step - binary_classification_loss: 24.8477 - loss: 142.0036 - regression_loss: 55.6052 - track_epsilon: 0.0027 - treatment_accuracy: 0.8518 - val_binary_classification_loss: 34.7809 - val_loss: 187.6609 - val_regression_loss: 60.2071 - val_track_epsilon: 0.0027 - val_treatment_accuracy: 0.6600 - learning_rate: 7.8125e-08
Epoch 56/100
10/10 ━━━━━━━━━━━━━━━━━━━━ 0s 7ms/step - binary_classification_loss: 24.8333 - loss: 144.8292 - regression_loss: 57.0159 - track_epsilon: 0.0027 - treatment_accuracy: 0.8500 - val_binary_classification_loss: 34.7808 - val_loss: 187.6165 - val_regression_loss: 60.1897 - val_track_epsilon: 0.0026 - val_treatment_accuracy: 0.6600 - learning_rate: 7.8125e-08
Epoch 57/100
 1/10 ━━━━━━━━━━━━━━━━━━━━ 0s 17ms/step - binary_classification_loss: 26.0216 - loss: 159.9350 - regression_loss: 64.6162 - track_epsilon: 0.0026 - treatment_accuracy: 0.8438
Epoch 57: ReduceLROnPlateau reducing learning rate to 3.906249901319825e-08.
10/10 ━━━━━━━━━━━━━━━━━━━━ 0s 7ms/step - binary_classification_loss: 25.6576 - loss: 142.9959 - regression_loss: 55.7551 - track_epsilon: 0.0026 - treatment_accuracy: 0.8446 - val_binary_classification_loss: 34.7805 - val_loss: 187.6262 - val_regression_loss: 60.1934 - val_track_epsilon: 0.0026 - val_treatment_accuracy: 0.6600 - learning_rate: 7.8125e-08
Epoch 58/100
10/10 ━━━━━━━━━━━━━━━━━━━━ 0s 7ms/step - binary_classification_loss: 24.0631 - loss: 144.1507 - regression_loss: 57.1101 - track_epsilon: 0.0026 - treatment_accuracy: 0.8580 - val_binary_classification_loss: 34.7794 - val_loss: 187.6227 - val_regression_loss: 60.1950 - val_track_epsilon: 0.0026 - val_treatment_accuracy: 0.6600 - learning_rate: 3.9062e-08
Epoch 59/100
10/10 ━━━━━━━━━━━━━━━━━━━━ 0s 7ms/step - binary_classification_loss: 24.2842 - loss: 147.8044 - regression_loss: 58.8211 - track_epsilon: 0.0026 - treatment_accuracy: 0.8587 - val_binary_classification_loss: 34.7802 - val_loss: 187.6470 - val_regression_loss: 60.2028 - val_track_epsilon: 0.0026 - val_treatment_accuracy: 0.6600 - learning_rate: 3.9062e-08
Epoch 60/100
10/10 ━━━━━━━━━━━━━━━━━━━━ 0s 7ms/step - binary_classification_loss: 23.7316 - loss: 148.1470 - regression_loss: 59.2679 - track_epsilon: 0.0026 - treatment_accuracy: 0.8577 - val_binary_classification_loss: 34.7803 - val_loss: 187.6546 - val_regression_loss: 60.2064 - val_track_epsilon: 0.0026 - val_treatment_accuracy: 0.6600 - learning_rate: 3.9062e-08
Epoch 61/100
10/10 ━━━━━━━━━━━━━━━━━━━━ 0s 7ms/step - binary_classification_loss: 24.2784 - loss: 138.8113 - regression_loss: 54.3540 - track_epsilon: 0.0026 - treatment_accuracy: 0.8583 - val_binary_classification_loss: 34.7796 - val_loss: 187.6364 - val_regression_loss: 60.1991 - val_track_epsilon: 0.0026 - val_treatment_accuracy: 0.6600 - learning_rate: 3.9062e-08
24/24 ━━━━━━━━━━━━━━━━━━━━ 0s 4ms/step
df_preds = pd.DataFrame([s_cate.ravel(),
                          t_cate.ravel(),
                          x_cate.ravel(),
                          r_cate.ravel(),
                          dragon_cate.ravel(),
                          tau.ravel(),
                          treatment.ravel(),
                          y.ravel()],
                       index=['S','T','X','R','dragonnet','tau','w','y']).T

df_preds = df_preds.apply(pd.to_numeric, errors='coerce')
df_cumgain = get_cumgain(df_preds)
df_result = pd.DataFrame([s_ate, t_ate, x_ate, r_ate, dragon_ate, tau.mean()],
                     index=['S','T','X','R','dragonnet','actual'], columns=['ATE'])
df_result['MAE'] = [mean_absolute_error(t,p) for t,p in zip([s_cate, t_cate, x_cate, r_cate, dragon_cate],
                                                            [tau.values.reshape(-1,1)]*5 )
                ] + [None]
df_result['AUUC'] = auuc_score(df_preds)
df_result
| ATE | MAE | AUUC | |
|---|---|---|---|
| S | 3.931390 | 1.031916 | 0.562590 |
| T | 3.968422 | 1.007734 | 0.566385 |
| X | 4.016707 | 1.151655 | 0.545269 |
| R | 3.797722 | 1.740358 | 0.546678 |
| dragonnet | 3.946424 | 1.119996 | 0.538780 |
| actual | 4.029661 | NaN | NaN |
plot_gain(df_preds)
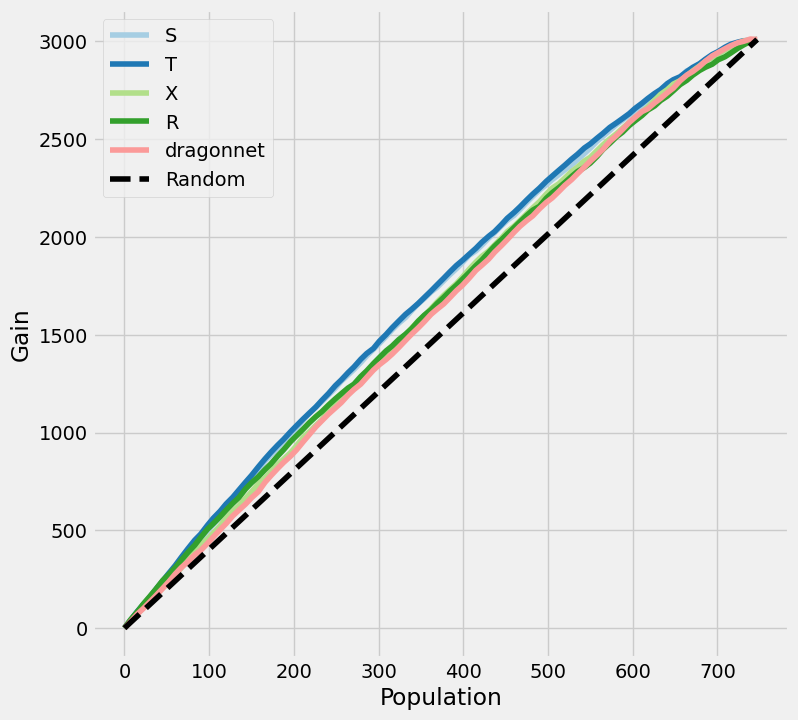
DragonNet 논문에 따르면 아래와 같은 상황에서 적용하기 더 좋다고 알려져 있습니다. 특히 논문에서는 성향점수 모델이 빠진 TARNET가 비교를 하고 있습니다:
DragonNet은 처치 (\(T\))에는 무관하고 결과값 (\(Y\))에만 관련 있는 데이터를 제거하는 데에 효과적입니다.
성향 점수를 예측하는 Head는 단순한 Logisitic Regression을 권장합니다. 이를 통해 표현층(\(Z\))이 성향 점수 정보에 강하게 결합되도록 강제하게 됩니다.
모델 훈련과 최종 효과 추정에 Data Spliting 없이 사용하는 것을 권장합니다.
CEVAE#
전통적인 인과 추론은 모든 교란 변수가 관측되었다는 강력한 가정(조건부 교환 가능성)에 의존하지만, 현실적으로 관측되지 않은 교란 요인은 추정 결과에 Bias를 야기합니다.
CEVAE는 VAE의 잠재 공간을 활용하여 관측 데이터 내에 숨겨진 잠재 교란 변수를 추론하고 그 영향을 모델링함으로써, 관측되지 않은 교란 요인이 존재하는 상황에서도 Treatment가 Outcome에 미치는 인과 효과를 더욱 견고하고 정확하게 추정할 수 있게 해주는 접근법입니다.
df = pd.DataFrame()
for i in range(1, 10):
    data = pd.read_csv('/content/ihdp_npci_' + str(i) + '.csv', header=None)
    df = pd.concat([data, df])
cols =  ["treatment", "y_factual", "y_cfactual", "mu0", "mu1"] + [i for i in range(25)]
df.columns = cols
print(df.shape)
(6723, 30)
# causalml의 CEVAE는 내부적으로 feature index를 기준으로 첫 N개는 Bernoulli decoder,
# 나머지는 Gaussian decoder로 처리하도록 설계되어 있어 이산/연속형에 대해 미리 구분을 해야함.

binfeats = [6, 7, 8, 9, 10, 11, 12, 13, 14, 15, 16, 17, 18, 19, 20, 21, 22, 23, 24]
contfeats = [i for i in range(25) if i not in binfeats]

perm = binfeats + contfeats
X = df[perm].values
treatment = df['treatment'].values
y = df['y_factual'].values
y_cf = df['y_cfactual'].values
tau = df.apply(lambda d: d['y_factual'] - d['y_cfactual'] if d['treatment']==1
               else d['y_cfactual'] - d['y_factual'],
               axis=1)
mu_0 = df['mu0'].values
mu_1 = df['mu1'].values
X = X.values if hasattr(X, 'values') else X
treatment = treatment.values if hasattr(treatment, 'values') else treatment
y = y.values if hasattr(y, 'values') else y
y_cf = y_cf.values if hasattr(y_cf, 'values') else y_cf
tau = tau.values if hasattr(tau, 'values') else tau
mu_0 = mu_0.values if hasattr(mu_0, 'values') else mu_0
mu_1 = mu_1.values if hasattr(mu_1, 'values') else mu_1

# split
itr, ite = train_test_split(np.arange(X.shape[0]), test_size=0.2, random_state=42)

X_train, treatment_train, y_train, y_cf_train, tau_train, mu_0_train, mu_1_train = \
    X[itr], treatment[itr], y[itr], y_cf[itr], tau[itr], mu_0[itr], mu_1[itr]

X_val, treatment_val, y_val, y_cf_val, tau_val, mu_0_val, mu_1_val = \
    X[ite], treatment[ite], y[ite], y_cf[ite], tau[ite], mu_0[ite], mu_1[ite]

# y 정규화

scaler_y = StandardScaler()

y_train_scaled = scaler_y.fit_transform(y_train.reshape(-1, 1)).ravel()
y_val_scaled = scaler_y.transform(y_val.reshape(-1, 1)).ravel()
# cevae model settings
outcome_dist = "normal"
latent_dim = 5
hidden_dim = 20
num_epochs = 100
batch_size = 64
learning_rate = 0.001
learning_rate_decay = 0.01
num_layers = 2
cevae = CEVAE(outcome_dist=outcome_dist,
              latent_dim=latent_dim,
              hidden_dim=hidden_dim,
              num_epochs=num_epochs,
              batch_size=batch_size,
              learning_rate=learning_rate,
              learning_rate_decay=learning_rate_decay,
              num_layers=num_layers)
losses = cevae.fit(
    X=torch.tensor(X_train, dtype=torch.float32),
    treatment=torch.tensor(treatment_train, dtype=torch.float32),
    y=torch.tensor(y_train_scaled, dtype=torch.float32)
)
INFO:pyro.contrib.cevae:Training with 85 minibatches per epoch
DEBUG:pyro.contrib.cevae:step     0 loss = 48.9639
DEBUG:pyro.contrib.cevae:step   100 loss = 48.2005
DEBUG:pyro.contrib.cevae:step   200 loss = 48.5548
DEBUG:pyro.contrib.cevae:step   300 loss = 48.1859
DEBUG:pyro.contrib.cevae:step   400 loss = 49.0292
DEBUG:pyro.contrib.cevae:step   500 loss = 48.1738
DEBUG:pyro.contrib.cevae:step   600 loss = 47.1798
DEBUG:pyro.contrib.cevae:step   700 loss = 46.9456
DEBUG:pyro.contrib.cevae:step   800 loss = 45.4172
DEBUG:pyro.contrib.cevae:step   900 loss = 48.0815
DEBUG:pyro.contrib.cevae:step  1000 loss = 45.4943
DEBUG:pyro.contrib.cevae:step  1100 loss = 46.7149
DEBUG:pyro.contrib.cevae:step  1200 loss = 47.0703
DEBUG:pyro.contrib.cevae:step  1300 loss = 44.947
DEBUG:pyro.contrib.cevae:step  1400 loss = 50.664
DEBUG:pyro.contrib.cevae:step  1500 loss = 46.9402
DEBUG:pyro.contrib.cevae:step  1600 loss = 45.0927
DEBUG:pyro.contrib.cevae:step  1700 loss = 47.943
DEBUG:pyro.contrib.cevae:step  1800 loss = 45.6877
DEBUG:pyro.contrib.cevae:step  1900 loss = 46.5921
DEBUG:pyro.contrib.cevae:step  2000 loss = 48.3146
DEBUG:pyro.contrib.cevae:step  2100 loss = 47.2067
DEBUG:pyro.contrib.cevae:step  2200 loss = 48.9974
DEBUG:pyro.contrib.cevae:step  2300 loss = 49.3944
DEBUG:pyro.contrib.cevae:step  2400 loss = 47.7533
DEBUG:pyro.contrib.cevae:step  2500 loss = 51.3043
DEBUG:pyro.contrib.cevae:step  2600 loss = 44.9621
DEBUG:pyro.contrib.cevae:step  2700 loss = 48.4485
DEBUG:pyro.contrib.cevae:step  2800 loss = 45.3515
DEBUG:pyro.contrib.cevae:step  2900 loss = 47.9119
DEBUG:pyro.contrib.cevae:step  3000 loss = 44.5366
DEBUG:pyro.contrib.cevae:step  3100 loss = 48.96
DEBUG:pyro.contrib.cevae:step  3200 loss = 45.5534
DEBUG:pyro.contrib.cevae:step  3300 loss = 45.5195
DEBUG:pyro.contrib.cevae:step  3400 loss = 44.9232
DEBUG:pyro.contrib.cevae:step  3500 loss = 45.1546
DEBUG:pyro.contrib.cevae:step  3600 loss = 46.3106
DEBUG:pyro.contrib.cevae:step  3700 loss = 45.3824
DEBUG:pyro.contrib.cevae:step  3800 loss = 48.0546
DEBUG:pyro.contrib.cevae:step  3900 loss = 47.4294
DEBUG:pyro.contrib.cevae:step  4000 loss = 44.866
DEBUG:pyro.contrib.cevae:step  4100 loss = 45.7986
DEBUG:pyro.contrib.cevae:step  4200 loss = 48.183
DEBUG:pyro.contrib.cevae:step  4300 loss = 45.878
DEBUG:pyro.contrib.cevae:step  4400 loss = 45.7324
DEBUG:pyro.contrib.cevae:step  4500 loss = 45.7699
DEBUG:pyro.contrib.cevae:step  4600 loss = 46.8059
DEBUG:pyro.contrib.cevae:step  4700 loss = 47.7014
DEBUG:pyro.contrib.cevae:step  4800 loss = 47.4923
DEBUG:pyro.contrib.cevae:step  4900 loss = 46.2966
DEBUG:pyro.contrib.cevae:step  5000 loss = 51.3186
DEBUG:pyro.contrib.cevae:step  5100 loss = 46.3053
DEBUG:pyro.contrib.cevae:step  5200 loss = 46.3786
DEBUG:pyro.contrib.cevae:step  5300 loss = 47.5462
DEBUG:pyro.contrib.cevae:step  5400 loss = 47.6125
DEBUG:pyro.contrib.cevae:step  5500 loss = 47.2126
DEBUG:pyro.contrib.cevae:step  5600 loss = 44.6161
DEBUG:pyro.contrib.cevae:step  5700 loss = 46.9545
DEBUG:pyro.contrib.cevae:step  5800 loss = 45.693
DEBUG:pyro.contrib.cevae:step  5900 loss = 46.5535
DEBUG:pyro.contrib.cevae:step  6000 loss = 48.4958
DEBUG:pyro.contrib.cevae:step  6100 loss = 46.2013
DEBUG:pyro.contrib.cevae:step  6200 loss = 45.8973
DEBUG:pyro.contrib.cevae:step  6300 loss = 45.1023
DEBUG:pyro.contrib.cevae:step  6400 loss = 49.1543
DEBUG:pyro.contrib.cevae:step  6500 loss = 44.5502
DEBUG:pyro.contrib.cevae:step  6600 loss = 45.5036
DEBUG:pyro.contrib.cevae:step  6700 loss = 47.7773
DEBUG:pyro.contrib.cevae:step  6800 loss = 48.0571
DEBUG:pyro.contrib.cevae:step  6900 loss = 48.8767
DEBUG:pyro.contrib.cevae:step  7000 loss = 48.1062
DEBUG:pyro.contrib.cevae:step  7100 loss = 46.9228
DEBUG:pyro.contrib.cevae:step  7200 loss = 47.6911
DEBUG:pyro.contrib.cevae:step  7300 loss = 46.6638
DEBUG:pyro.contrib.cevae:step  7400 loss = 44.4855
DEBUG:pyro.contrib.cevae:step  7500 loss = 46.9936
DEBUG:pyro.contrib.cevae:step  7600 loss = 46.0181
DEBUG:pyro.contrib.cevae:step  7700 loss = 46.6819
DEBUG:pyro.contrib.cevae:step  7800 loss = 46.8038
DEBUG:pyro.contrib.cevae:step  7900 loss = 43.0979
DEBUG:pyro.contrib.cevae:step  8000 loss = 47.2424
DEBUG:pyro.contrib.cevae:step  8100 loss = 48.7632
DEBUG:pyro.contrib.cevae:step  8200 loss = 49.0808
DEBUG:pyro.contrib.cevae:step  8300 loss = 46.9398
DEBUG:pyro.contrib.cevae:step  8400 loss = 48.7155
ite_train_scaled = cevae.predict(X_train)
ite_train = ite_train_scaled * scaler_y.scale_[0]

ite_val_scaled = cevae.predict(X_val)
ite_val = ite_val_scaled * scaler_y.scale_[0]
INFO:pyro.contrib.cevae:Evaluating 85 minibatches
DEBUG:pyro.contrib.cevae:batch ate = 0.0357613
DEBUG:pyro.contrib.cevae:batch ate = 0.0431543
DEBUG:pyro.contrib.cevae:batch ate = 0.0411953
DEBUG:pyro.contrib.cevae:batch ate = 0.0267529
DEBUG:pyro.contrib.cevae:batch ate = 0.0360293
DEBUG:pyro.contrib.cevae:batch ate = 0.0390199
DEBUG:pyro.contrib.cevae:batch ate = 0.0334115
DEBUG:pyro.contrib.cevae:batch ate = 0.0323909
DEBUG:pyro.contrib.cevae:batch ate = 0.0371927
DEBUG:pyro.contrib.cevae:batch ate = 0.0270396
DEBUG:pyro.contrib.cevae:batch ate = 0.0345171
DEBUG:pyro.contrib.cevae:batch ate = 0.0325494
DEBUG:pyro.contrib.cevae:batch ate = 0.0299351
DEBUG:pyro.contrib.cevae:batch ate = 0.0324487
DEBUG:pyro.contrib.cevae:batch ate = 0.0360658
DEBUG:pyro.contrib.cevae:batch ate = 0.0309952
DEBUG:pyro.contrib.cevae:batch ate = 0.0380256
DEBUG:pyro.contrib.cevae:batch ate = 0.0398062
DEBUG:pyro.contrib.cevae:batch ate = 0.0440953
DEBUG:pyro.contrib.cevae:batch ate = 0.0322515
DEBUG:pyro.contrib.cevae:batch ate = 0.0329532
DEBUG:pyro.contrib.cevae:batch ate = 0.0257642
DEBUG:pyro.contrib.cevae:batch ate = 0.0431713
DEBUG:pyro.contrib.cevae:batch ate = 0.0327507
DEBUG:pyro.contrib.cevae:batch ate = 0.0308641
DEBUG:pyro.contrib.cevae:batch ate = 0.0343633
DEBUG:pyro.contrib.cevae:batch ate = 0.0299913
DEBUG:pyro.contrib.cevae:batch ate = 0.0317643
DEBUG:pyro.contrib.cevae:batch ate = 0.0457623
DEBUG:pyro.contrib.cevae:batch ate = 0.0361862
DEBUG:pyro.contrib.cevae:batch ate = 0.0328797
DEBUG:pyro.contrib.cevae:batch ate = 0.030466
DEBUG:pyro.contrib.cevae:batch ate = 0.035318
DEBUG:pyro.contrib.cevae:batch ate = 0.0268161
DEBUG:pyro.contrib.cevae:batch ate = 0.0394214
DEBUG:pyro.contrib.cevae:batch ate = 0.0374702
DEBUG:pyro.contrib.cevae:batch ate = 0.0437437
DEBUG:pyro.contrib.cevae:batch ate = 0.0365419
DEBUG:pyro.contrib.cevae:batch ate = 0.0315699
DEBUG:pyro.contrib.cevae:batch ate = 0.0305505
DEBUG:pyro.contrib.cevae:batch ate = 0.0300822
DEBUG:pyro.contrib.cevae:batch ate = 0.0369294
DEBUG:pyro.contrib.cevae:batch ate = 0.0286461
DEBUG:pyro.contrib.cevae:batch ate = 0.0327973
DEBUG:pyro.contrib.cevae:batch ate = 0.0314062
DEBUG:pyro.contrib.cevae:batch ate = 0.0400608
DEBUG:pyro.contrib.cevae:batch ate = 0.0448318
DEBUG:pyro.contrib.cevae:batch ate = 0.0393494
DEBUG:pyro.contrib.cevae:batch ate = 0.0299567
DEBUG:pyro.contrib.cevae:batch ate = 0.0314643
DEBUG:pyro.contrib.cevae:batch ate = 0.0305959
DEBUG:pyro.contrib.cevae:batch ate = 0.0369254
DEBUG:pyro.contrib.cevae:batch ate = 0.0313504
DEBUG:pyro.contrib.cevae:batch ate = 0.0336109
DEBUG:pyro.contrib.cevae:batch ate = 0.0340122
DEBUG:pyro.contrib.cevae:batch ate = 0.033707
DEBUG:pyro.contrib.cevae:batch ate = 0.0279474
DEBUG:pyro.contrib.cevae:batch ate = 0.029306
DEBUG:pyro.contrib.cevae:batch ate = 0.0437996
DEBUG:pyro.contrib.cevae:batch ate = 0.0363425
DEBUG:pyro.contrib.cevae:batch ate = 0.0385123
DEBUG:pyro.contrib.cevae:batch ate = 0.041306
DEBUG:pyro.contrib.cevae:batch ate = 0.0378742
DEBUG:pyro.contrib.cevae:batch ate = 0.0329952
DEBUG:pyro.contrib.cevae:batch ate = 0.0233462
DEBUG:pyro.contrib.cevae:batch ate = 0.024675
DEBUG:pyro.contrib.cevae:batch ate = 0.0346281
DEBUG:pyro.contrib.cevae:batch ate = 0.0355335
DEBUG:pyro.contrib.cevae:batch ate = 0.0413309
DEBUG:pyro.contrib.cevae:batch ate = 0.0341045
DEBUG:pyro.contrib.cevae:batch ate = 0.0340933
DEBUG:pyro.contrib.cevae:batch ate = 0.044108
DEBUG:pyro.contrib.cevae:batch ate = 0.0327005
DEBUG:pyro.contrib.cevae:batch ate = 0.0343668
DEBUG:pyro.contrib.cevae:batch ate = 0.0404688
DEBUG:pyro.contrib.cevae:batch ate = 0.0385802
DEBUG:pyro.contrib.cevae:batch ate = 0.0405106
DEBUG:pyro.contrib.cevae:batch ate = 0.0385111
DEBUG:pyro.contrib.cevae:batch ate = 0.0358223
DEBUG:pyro.contrib.cevae:batch ate = 0.0316603
DEBUG:pyro.contrib.cevae:batch ate = 0.0337678
DEBUG:pyro.contrib.cevae:batch ate = 0.0263058
DEBUG:pyro.contrib.cevae:batch ate = 0.0428746
DEBUG:pyro.contrib.cevae:batch ate = 0.0364403
DEBUG:pyro.contrib.cevae:batch ate = 0.0261105
INFO:pyro.contrib.cevae:Evaluating 22 minibatches
DEBUG:pyro.contrib.cevae:batch ate = 0.0399138
DEBUG:pyro.contrib.cevae:batch ate = 0.0279827
DEBUG:pyro.contrib.cevae:batch ate = 0.0238013
DEBUG:pyro.contrib.cevae:batch ate = 0.0298008
DEBUG:pyro.contrib.cevae:batch ate = 0.037025
DEBUG:pyro.contrib.cevae:batch ate = 0.039021
DEBUG:pyro.contrib.cevae:batch ate = 0.0398782
DEBUG:pyro.contrib.cevae:batch ate = 0.0380361
DEBUG:pyro.contrib.cevae:batch ate = 0.0437849
DEBUG:pyro.contrib.cevae:batch ate = 0.0349003
DEBUG:pyro.contrib.cevae:batch ate = 0.0380873
DEBUG:pyro.contrib.cevae:batch ate = 0.0473408
DEBUG:pyro.contrib.cevae:batch ate = 0.0342671
DEBUG:pyro.contrib.cevae:batch ate = 0.0305362
DEBUG:pyro.contrib.cevae:batch ate = 0.0449585
DEBUG:pyro.contrib.cevae:batch ate = 0.0413622
DEBUG:pyro.contrib.cevae:batch ate = 0.0342032
DEBUG:pyro.contrib.cevae:batch ate = 0.0289496
DEBUG:pyro.contrib.cevae:batch ate = 0.0315949
DEBUG:pyro.contrib.cevae:batch ate = 0.0281932
DEBUG:pyro.contrib.cevae:batch ate = 0.0346994
DEBUG:pyro.contrib.cevae:batch ate = -0.0343999
ate_val = np.mean(ite_val)
ate_train = np.mean(ite_train)
print(ate_val, ate_train)
0.4848224821601096 0.4749895049499244
# fit propensity model
p_model = ElasticNetPropensityModel()
p_train = p_model.fit_predict(X_train, treatment_train)
p_val = p_model.fit_predict(X_val, treatment_val)
s_learner = BaseSRegressor(LGBMRegressor())
s_ate = s_learner.estimate_ate(X_train, treatment_train, y_train_scaled)[0]
s_ite_train = s_learner.fit_predict(X_train, treatment_train, y_train_scaled)
s_ite_val = s_learner.predict(X_val)

t_learner = BaseTRegressor(LGBMRegressor())
t_ate = t_learner.estimate_ate(X_train, treatment_train, y_train_scaled)[0][0]
t_ite_train = t_learner.fit_predict(X_train, treatment_train, y_train_scaled)
t_ite_val = t_learner.predict(X_val, treatment_val, y_val_scaled)

x_learner = BaseXRegressor(LGBMRegressor())
x_ate = x_learner.estimate_ate(X_train, treatment_train, y_train_scaled, p_train)[0][0]
x_ite_train = x_learner.fit_predict(X_train, treatment_train, y_train_scaled, p_train)
x_ite_val = x_learner.predict(X_val, treatment_val, y_val_scaled, p_val)

r_learner = BaseRRegressor(LGBMRegressor())
r_ate = r_learner.estimate_ate(X_train, treatment_train, y_train_scaled, p_train)[0][0]
r_ite_train = r_learner.fit_predict(X_train, treatment_train, y_train_scaled, p_train)
r_ite_val = r_learner.predict(X_val)

std_y = scaler_y.scale_[0]

s_ite_train = s_ite_train * std_y
s_ite_val = s_ite_val * std_y

t_ite_train = t_ite_train * std_y
t_ite_val = t_ite_val * std_y

x_ite_train = x_ite_train * std_y
x_ite_val = x_ite_val * std_y

r_ite_train = r_ite_train * std_y
r_ite_val = r_ite_val * std_y

s_ate *= std_y
t_ate *= std_y
x_ate *= std_y
r_ate *= std_y
df_preds_train = pd.DataFrame([s_ite_train.ravel(),
                               t_ite_train.ravel(),
                               x_ite_train.ravel(),
                               r_ite_train.ravel(),
                               ite_train.ravel(),
                               tau_train.ravel(),
                               y_train.ravel()],
                               index=['S','T','X','R','CEVAE','tau','y']).T

df_cumgain_train = get_cumgain(df_preds_train)
df_result_train = pd.DataFrame([s_ate, t_ate, x_ate, r_ate, ate_train, tau_train.mean()],
                               index=['S','T','X','R','CEVAE','actual'], columns=['ATE'])
df_result_train['MAE'] = [
    mean_absolute_error(t, tau_train.reshape(-1,1))
    for t in [s_ite_train, t_ite_train, x_ite_train, r_ite_train, ite_train]
] + [None]


df_result_train['AUUC'] = auuc_score(df_preds_train)
df_result_train
| ATE | MAE | AUUC | |
|---|---|---|---|
| S | 4.433617 | 4.336056 | 0.657926 |
| T | 4.544041 | 4.918016 | 0.635457 |
| X | 4.548524 | 4.485819 | 0.643203 |
| R | 1.003279 | 5.649068 | 0.533841 |
| CEVAE | 0.474990 | 5.768563 | 0.517121 |
| actual | 4.729731 | NaN | NaN |
plot_gain(df_preds_train)
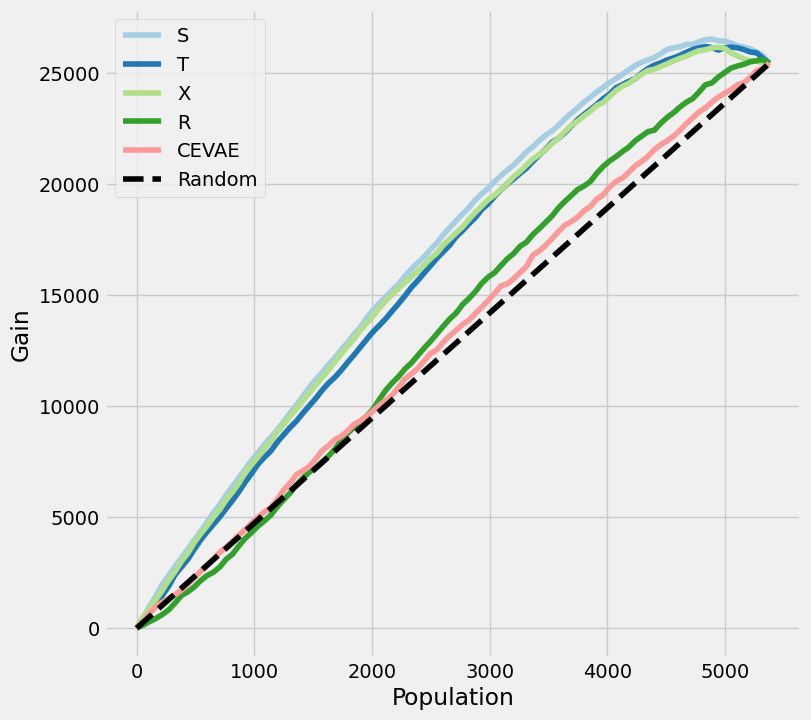
df_preds_val = pd.DataFrame([s_ite_val.ravel(),
                             t_ite_val.ravel(),
                             x_ite_val.ravel(),
                             r_ite_val.ravel(),
                             ite_val.ravel(),
                             tau_val.ravel(),
                             y_val.ravel()],
                             index=['S','T','X','R','CEVAE','tau','y']).T

df_cumgain_val = get_cumgain(df_preds_val)
df_result_val = pd.DataFrame([s_ite_val.mean(), t_ite_val.mean(), x_ite_val.mean(), r_ite_val.mean(), ate_val, tau_val.mean()],
                              index=['S','T','X','R','CEVAE','actual'], columns=['ATE'])
df_result_val['MAE'] = [
    mean_absolute_error(t, tau_val.reshape(-1,1))
    for t in [s_ite_val, t_ite_val, x_ite_val, r_ite_val, ite_val]
] + [None]

df_result_val['AUUC'] = auuc_score(df_preds_val)
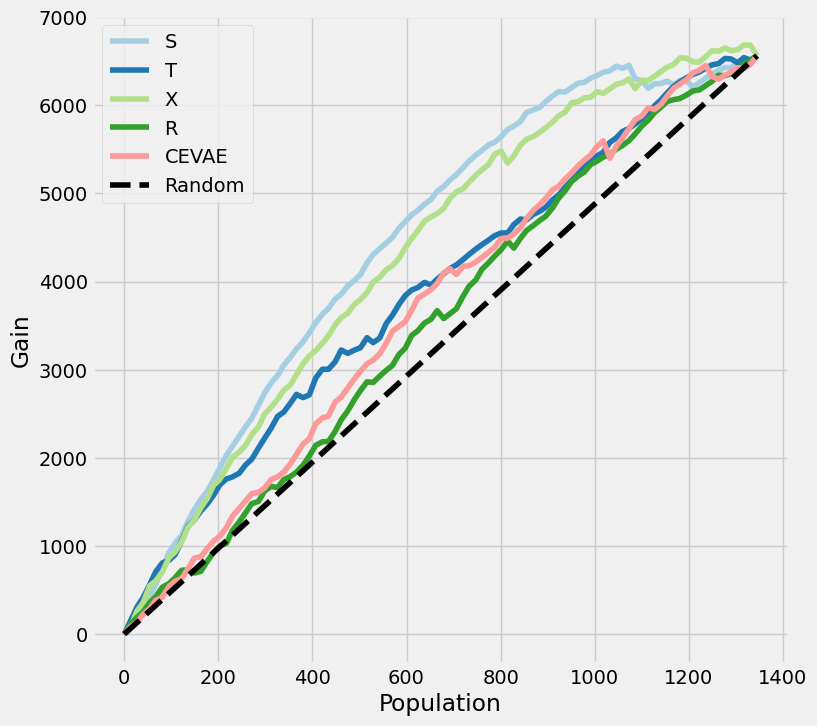
df_result_val
| ATE | MAE | AUUC | |
|---|---|---|---|
| S | 4.413251 | 5.258480 | 0.677223 |
| T | 4.526510 | 5.993292 | 0.591087 |
| X | 4.528593 | 5.327572 | 0.656417 |
| R | 2.134540 | 6.632477 | 0.537254 |
| CEVAE | 0.484822 | 6.668624 | 0.560306 |
| actual | 4.879625 | NaN | NaN |
plot_gain(df_preds_val)