Difference-in-Difference (DiD)#
출처
실무로 통하는 인과추론 with 파이썬
!pip install toolz
!pip install lightgbm
!pip install doubleml
가상환경 정보#
!python --version
!pip freeze
패키지 불러오기#
import warnings, logging
import numpy as np
import pandas as pd

import statsmodels.api as sm
import statsmodels.formula.api as smf
from scipy.stats import norm

from lightgbm import LGBMRegressor, LGBMClassifier


from doubleml import DoubleMLData, DoubleMLDID


from toolz import *

import matplotlib
from matplotlib import pyplot as plt
import seaborn as sns
from cycler import cycler
import matplotlib.ticker as plticker


color = ['0.0', '0.4', '0.8']
default_cycler = cycler(color=color)
linestyle = ['-', '--', ':', '-.']
marker = ['o', 'v', 'd', 'p']

plt.rc('axes', prop_cycle=default_cycler)


warnings.filterwarnings("ignore")
logging.getLogger('matplotlib.category').setLevel(logging.ERROR)
데이터 불러오기#
mkt_data = (pd.read_csv("../data/matheus_data/short_offline_mkt_south.csv")
           .astype({"date":"datetime64[ns]"}))


mkt_data.head()
| date | city | region | treated | tau | downloads | post | |
|---|---|---|---|---|---|---|---|
| 0 | 2021-05-01 | 5 | S | 0 | 0.0 | 51.0 | 0 |
| 1 | 2021-05-02 | 5 | S | 0 | 0.0 | 51.0 | 0 |
| 2 | 2021-05-03 | 5 | S | 0 | 0.0 | 51.0 | 0 |
| 3 | 2021-05-04 | 5 | S | 0 | 0.0 | 50.0 | 0 |
| 4 | 2021-05-05 | 5 | S | 0 | 0.0 | 49.0 | 0 |
위 데이터는 남부 지역에서 온라인 마케팅 캠페인을 집행했을 때, 사용자가 실제로 해당 광고를 보고 앱을 다운로드했는지를 관찰한 자료입니다. 일반적으로 마케팅 업계에서는 이러한 지역 단위 실험(Regional Experiment) 설계를 자주 활용합니다. 즉, 일부 지역(실험군, treatment group)에서는 마케팅 캠페인을 진행하고, 다른 지역(통제군, control group)에서는 캠페인을 진행하지 않은 채로 두 집단의 변화를 비교하는 방식입니다.
이런 설계는 단순히 시점별 평균 차이만 비교하는 것보다 더 엄밀하게 마케팅의 실제 효과(causal effect) 를 추정할 수 있습니다. 특히 패널 데이터(panel data) 를 활용하면, 같은 지역의 처치 전(before treatment) 과 처치 후(after treatment) 변화를 모두 관측할 수 있기 때문에, 지역별 고유한 특성(예: 인구 규모, 경제 수준 등)을 통제하면서 시점별 변화만을 비교할 수 있습니다.
이때 주로 사용하는 분석 방법이 차분의 차분(Difference-in-Differences, DiD) 입니다. DiD는 “처치 지역에서의 전후 변화 - 비처치 지역에서의 전후 변화”를 계산함으로써, 단순한 시간 효과나 지역 차이를 제거하고 마케팅 캠페인 자체의 순수한 효과를 추정할 수 있게 해줍니다.
그럼 DiD를 추정하는 다양한 관점 및 방법에 대해 알아보도록 하겠습니다.
처치 개입 전후 기간 확인
(mkt_data
 .assign(w = lambda d: d["treated"]*d["post"])
 .groupby(["w"])
 .agg({"date":[min, max]}))
| date | ||
|---|---|---|
| min | max | |
| w | ||
| 0 | 2021-05-01 | 2021-06-01 |
| 1 | 2021-05-15 | 2021-06-01 |
처치 개입전 기간은 2021-05-01~2021-05-15이며 처치 후 기간은 2021-05-15~2021-06-01입니다.
did_data = (mkt_data
            .groupby(["treated", "post"])
            .agg({"downloads":"mean", "date": "min"}))

did_data
| downloads | date | ||
|---|---|---|---|
| treated | post | ||
| 0 | 0 | 50.335034 | 2021-05-01 |
| 1 | 50.556878 | 2021-05-15 | |
| 1 | 0 | 50.944444 | 2021-05-01 |
| 1 | 51.858025 | 2021-05-15 |
DiD#

이중 차분법에 대한 접근법 4가지#
평균을 이용한 이중 차분법 (Basic DID 2x2)
시간에 따른 결과 변화 값을 이용한 이중차분법
선형회귀를 이용한 이중차분법(Regression DID)
3.1 데이터 집계 방식
3.2 Basic DiD
3.3 TWFE DID
3.4 DID with covariates (Control DID: 추가 통제 포함)
머신 러닝을 이용한 이중차분법(DoubleML)
1. 평균을 이용한 이중 차분법(Basic DID 2x2)#
처치 그룹/대조 그룹, 처치 전/후 두 시점의 평균 차이의 차이를 직접 계산하는 방법입니다.
가장 직관적이고 기본적인 DiD 개념입니다.
다중 시점 데이터나 추가적인 교란 변수를 통제하기 어렵습니다. 통계적 유의성 검정이 별도의 과정이 필요합니다.
복잡한 데이터와 더 견고한 통계적 추론을 위해 회귀 분석 기반의 접근법이 필요하게 됩니다.
y0_est = (did_data.loc[1].loc[0, "downloads"] # treated baseline
          # control evolution
          + did_data.loc[0].diff().loc[1, "downloads"])

att = did_data.loc[1].loc[1, "downloads"] - y0_est
att
np.float64(0.6917359536407233)
mkt_data.query("post==1").query("treated==1")["tau"].mean()
np.float64(0.7660316402518457)
2. 시간에 따른 결과 변화 값을 이용한 이중차분법#
각 개별 단위(예: 도시)의 처치 전후 결과값 평균의 차이(\(\Delta Y_i\))를 직접 계산하여, 이 단위별 변화 값(\(\Delta Y_i\))을 사용하는 방법입니다.
DiD의 ‘변화 속의 변화’를 직관적으로 이해하고, 단위의 시간 불변 특성을 자동 통제합니다.
Basic DiD와 동일한 결과를 회귀식으로 도출하며 통계적 유의성 확인이 용이합니다.
더 복잡한 DiD(TWFE)로 나아가기 위한 개념적 디딤돌입니다.
두 시점 외 복잡한 다중 시점 데이터 처리나 시간에 따라 변하는 외부 교란 요인을 직접 통제하기 어렵습니다.
pre = mkt_data.query("post==0").groupby("city")["downloads"].mean()
post = mkt_data.query("post==1").groupby("city")["downloads"].mean()

delta_y = ((post - pre)
           .rename("delta_y")
           .to_frame()
           # add the treatment dummy
           .join(mkt_data.groupby("city")["treated"].max()))

delta_y.tail()
| delta_y | treated | |
|---|---|---|
| city | ||
| 192 | 0.555556 | 0 |
| 193 | 0.166667 | 0 |
| 195 | 0.420635 | 0 |
| 196 | 0.119048 | 0 |
| 197 | 1.595238 | 1 |
(delta_y.query("treated==1")["delta_y"].mean()
 - delta_y.query("treated==0")["delta_y"].mean())
np.float64(0.6917359536407155)
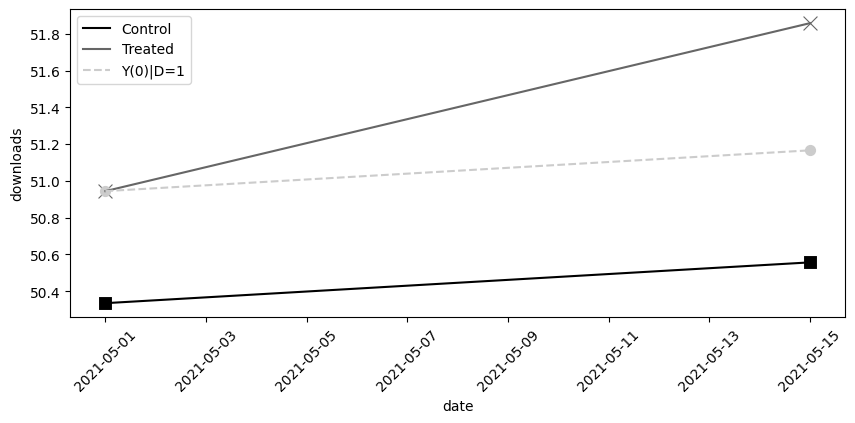
DID 모형에 따른 실험군과 대조군의 추세 및 실험군의 가상적(반사실적) 추세
did_data
| downloads | date | ||
|---|---|---|---|
| treated | post | ||
| 0 | 0 | 50.335034 | 2021-05-01 |
| 1 | 50.556878 | 2021-05-15 | |
| 1 | 0 | 50.944444 | 2021-05-01 |
| 1 | 51.858025 | 2021-05-15 |
<matplotlib.legend.Legend at 0x177893fd0>
3. 선형회귀를 이용한 이중차분법(Regression DID)#
DiD를 회귀식으로 표현하여 통계적 엄밀성을 확보하는 방법입니다. 데이터 집계 방식에 따라 두 가지 접근법이 있습니다.
먼저 Canonical DID를 추정할 때 두 가지 데이터 집계 방식이 사용될 수 있습니다.
개입 전/후 기간을 하나의 블록으로 집계한 데이터
각 개별 시점의 데이터를 그대로 사용
핵심은 어떤 데이터를 수집하더라도 분석에 사용할 최종 데이터 형태가 블록디자인을 따르면 된다는 것입니다.
블록 디자인이란?
동일한 시점에 처치를 받는 단위들을 하나의 블록으로 묶고 그 블록과 처치를 받지 않는 블록(control)을 비교하는 구조
3. 1 데이터 집계 방식 1: 개입 전/후 기간을 하나의 블록으로 집계한 데이터 (data set : did data)#
그룹(처치/대조)별로 처치 전 평균과 처치 후 평균을 구한 후, 이를 바탕으로 회귀 모델을 만드는 방식입니다.
Basic DID (2x2)와 동일한 결과값을 얻으면서 통계적 유의성을 쉽게 확인할 수 있습니다.
다만,개별 관측치 수준의 정보 손실이 있고, 다중 시점의 미시 데이터를 직접 활용하지 못합니다.
did_data = (mkt_data
            .groupby(["city", "post"])
            .agg({"downloads":"mean", "date": "min", "treated": "max"})
            .reset_index())

did_data.head()
| city | post | downloads | date | treated | |
|---|---|---|---|---|---|
| 0 | 5 | 0 | 50.642857 | 2021-05-01 | 0 |
| 1 | 5 | 1 | 50.166667 | 2021-05-15 | 0 |
| 2 | 15 | 0 | 49.142857 | 2021-05-01 | 0 |
| 3 | 15 | 1 | 49.166667 | 2021-05-15 | 0 |
| 4 | 20 | 0 | 48.785714 | 2021-05-01 | 0 |
smf.ols(
    'downloads ~ treated*post', data=did_data
).fit().params["treated:post"]
np.float64(0.6917359536407082)
3. 1 데이터 집계 방식 2: 각 개별 시점의 데이터를 그대로 사용 (data set : mkt data)#
DID를 추정할때 처치 전후로 각 값들을 그룹화하여 하지 않고 각 시점의 데이터를 모두 활용하는 방법입니다.
데이터 집계 방식 1보다 훨씬 강력하며, 단위 고정 효과와 시간 고정 효과를 포함할 수 있는 기반이 됩니다.
또, 데이터 집계 방식 1과 달리 개별 관측치 정보를 최대한 활용합니다. 또한 사전 평행 추세를 검정할 수 있다는 장점이 있습니다.
다만, 여전히 시간에 따라 변하는 관측되지 않은 교란 요인을 완전히 제거할 수는 없습니다.
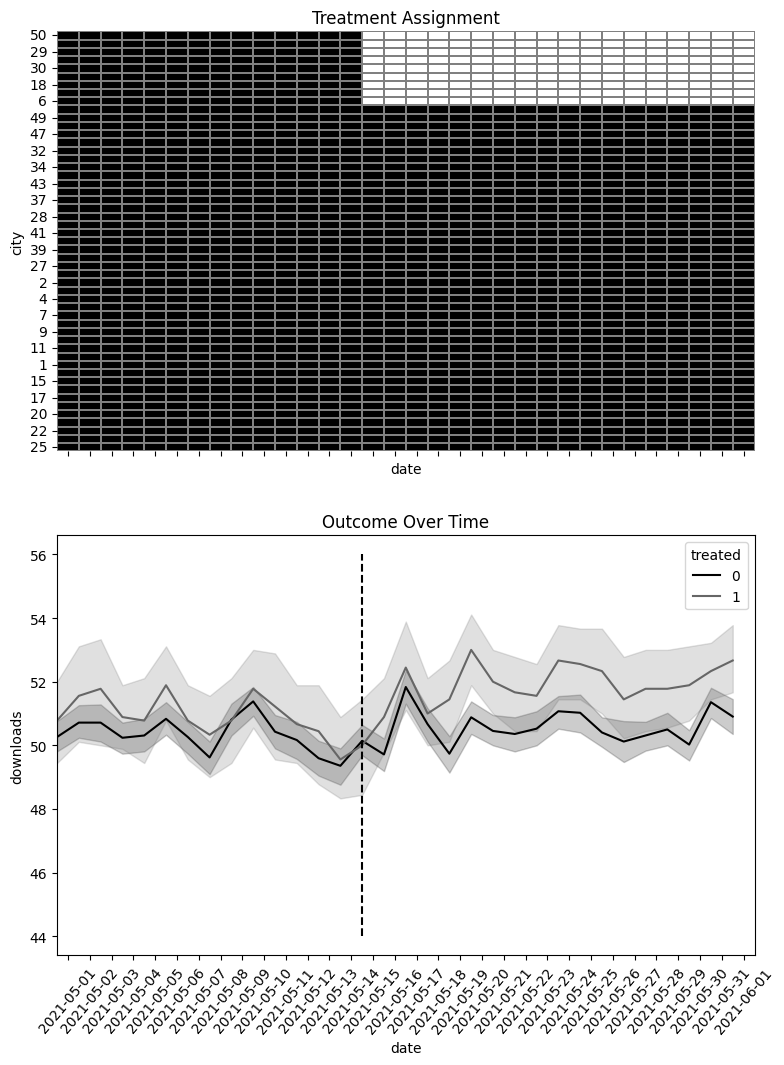
mkt_data
| date | city | region | treated | tau | downloads | post | |
|---|---|---|---|---|---|---|---|
| 0 | 2021-05-01 | 5 | S | 0 | 0.000000 | 51.0 | 0 |
| 1 | 2021-05-02 | 5 | S | 0 | 0.000000 | 51.0 | 0 |
| 2 | 2021-05-03 | 5 | S | 0 | 0.000000 | 51.0 | 0 |
| 3 | 2021-05-04 | 5 | S | 0 | 0.000000 | 50.0 | 0 |
| 4 | 2021-05-05 | 5 | S | 0 | 0.000000 | 49.0 | 0 |
| ... | ... | ... | ... | ... | ... | ... | ... |
| 1627 | 2021-05-28 | 197 | S | 1 | 1.771233 | 53.0 | 1 |
| 1628 | 2021-05-29 | 197 | S | 1 | 1.771233 | 52.0 | 1 |
| 1629 | 2021-05-30 | 197 | S | 1 | 1.771233 | 54.0 | 1 |
| 1630 | 2021-05-31 | 197 | S | 1 | 1.771233 | 53.0 | 1 |
| 1631 | 2021-06-01 | 197 | S | 1 | 1.771233 | 55.0 | 1 |
1632 rows × 7 columns
3.2 Basic DID#
가장 기본적인 회귀 DiD 모델이며, DiD 효과(\(\beta\))와 함께 각 그룹의 처치 전후 베이스라인 차이 등을 동시에 추정합니다.
통계적 추론(표준 오차, p-값)을 쉽게 제공합니다.
DiD 효과를 통계적으로 더 견고하게 추정하며, 이후 TWFE DiD 등 더 발전된 모델로 확장하기 위한 직접적인 기반이 됩니다.
아직 단위/시간 고정 효과를 명시적으로 통제하지 않으므로, 관측되지 않은 시간에 따른 교란 요인에 의한 편향 가능성이 있습니다.
m = smf.ols('downloads ~ treated*post', data=mkt_data).fit()

m.params["treated:post"]
np.float64(0.6917359536406855)
추론#
기준 표준 오차 (Homoskedastic Standard Error)
오차가 독립적이며 동일 분산을 가진다고 가정합니다.
다만 동일 단위 내 관측치 간 상관관계를 무시하여, 표준 오차가 과소평가(실제보다 작게)될 수 있습니다.
이로 인해 유의하지 않은 결과도 유의하다고 잘못 판단할 위험이 있습니다.
기준 표준오차는 단순한 가정에 기반하여 종종 과소추정을 초래하므로, 패널 데이터에서는 군집 표준오차를 사용하여 동일 단위 내 상관관계를 반영하는 것이 일반적입니다.
군집 표준 오차 (Clustered Standard Error)
특정 군집(예: city_id) 내에서는 오차 상관관계를 허용하지만, 군집 간에는 독립적이라고 가정합니다. 이분산성에도 강건합니다.
패널 데이터의 군집 내 상관관계를 반영하여, 보통 기준 표준 오차보다 더 크게(보수적으로) 추정됩니다.
기준 표준 오차의 과소평가 문제를 해결하여, 통계적 유의성 판단의 신뢰성을 높여줍니다. DiD 분석 시 권장됩니다.
다만, 군집 표준오차도 군집 수가 적거나 오차 구조가 복잡할 경우 신뢰성이 떨어질 수 있습니다. 이런 한계를 보완하기 위해 사용하는 방법이 바로 군집 부트스트랩입니다.
군집 부트스트랩 (Block Bootstrap)
개별 관측치가 아닌, 시계열이나 패널 데이터의 ‘군집’ 전체를 재표본 추출하여 표준 오차를 추정하는 비모수적(non-parametric) 방식입니다.
동일 단위 내 관측치 간의 복잡한 오차 상관관계 및 이분산성(heteroskedasticity) 문제를 효과적으로 해결하여, 모델 가정에 대한 의존도를 낮춥니다.
특히 Diff-in-Diff(DID) 분석처럼 표준 오차 계산 방식이 불분명할 때, 더욱 보수적이고 신뢰성 높은 통계적 유의성 판단을 가능하게 합니다.
기존 표준 오차 기반
m = smf.ols(
    'downloads ~ treated*post', data=mkt_data
).fit()
print("ATT:", m.params["treated:post"])
m.conf_int().loc["treated:post"]
ATT: 0.6917359536406855
0    0.213969
1    1.169503
Name: treated:post, dtype: float64
군집 기반 표준 오차 기반
m = smf.ols(
    'downloads ~ treated*post', data=mkt_data
).fit(cov_type='cluster', cov_kwds={'groups': mkt_data['city']})

print("ATT:", m.params["treated:post"])
m.conf_int().loc["treated:post"]
ATT: 0.6917359536406855
0    0.305820
1    1.077652
Name: treated:post, dtype: float64
군집 부트스트랩 방법
def block_sample(df, unit_col):
    units = df[unit_col].unique()
    sample = np.random.choice(units, size=len(units), replace=True)
    return (df
    .set_index(unit_col)
    .loc[sample]
    .reset_index(level=[unit_col]))
from joblib import Parallel, delayed

def block_bootstrap(data, est_fn, unit_col,
    rounds=200, seed=123, pcts=[2.5, 97.5]):
    np.random.seed(seed)
    stats = Parallel(n_jobs=4)(
    delayed(est_fn)(block_sample(data, unit_col=unit_col))
    for _ in range(rounds))
    return np.percentile(stats, pcts)
def est_fn(df):
    m = smf.ols('downloads ~ treated:post + C(city) + C(date)',
    data=df).fit()
    return m.params["treated:post"]
block_bootstrap(mkt_data, est_fn, "city")
array([0.23162214, 1.14002646])
3.3 2WFE did (시간 -대상 고정효과 모델)#
회귀 모델에 단위 고정 효과(\(\alpha_i\))와 시간 고정 효과(\(\gamma_t\))를 동시에 추가하여 분석하는 방법입니다.
단위별 고유 특성(시간 불변)과 모든 단위에 공통된 시간 트렌드를 통제하여 교란 요인을 더 효과적으로 제거합니다.
내생성 문제를 완화하고, 다중 시점 데이터를 유연하게 처리할 수 있습니다.
시간에 따라 변하는 관측되지 않은 교란 요인이나, 처치 효과가 이질적인 경우(heterogeneous effects) 편향될 수 있습니다.
m = smf.ols('downloads ~ treated:post + C(city) + C(date)',
            data=mkt_data).fit()

coef=m.params["treated:post"]

print("DID estimate:", coef)
DID estimate: 0.6917359536407248
데이터 집계 방식에 따른 추론 비교#
집계 방식 1: 단순한 2x2 테이블의 회귀 버전이며, 고정 효과를 적용하기 어렵습니다.
집계 방식 2: 패널 데이터의 장점을 활용할 수 있는 표준적인 접근법입니다.
1-1 집계방식 1: 기존 표준 오차 기반
m = smf.ols('downloads ~ treated:post + C(city) + C(date)',
            data=did_data).fit()

print("ATT:", m.params["treated:post"])
m.conf_int().loc["treated:post"]
ATT: 0.6917359536407064
0    0.409916
1    0.973556
Name: treated:post, dtype: float64
1-2 집계방식 1:군집 표준 오차 기반
m = smf.ols(
    'downloads ~ treated:post + C(city) + C(date)', data=did_data
).fit(cov_type='cluster', cov_kwds={'groups': did_data['city']})

print("ATT:", m.params["treated:post"])
m.conf_int().loc["treated:post"]
ATT: 0.6917359536407064
0    0.138188
1    1.245284
Name: treated:post, dtype: float64
2-1 집계방식 2: 기존 표준오차 기반
m = smf.ols('downloads ~ treated:post + C(city) + C(date)',
            data=mkt_data).fit()

print("ATT:", m.params["treated:post"])
m.conf_int().loc["treated:post"]
ATT: 0.6917359536407248
0    0.478014
1    0.905457
Name: treated:post, dtype: float64
2-2 집계방식 2: 군집 표준 오차 기반
m = smf.ols(
    'downloads ~ treated:post + C(city) + C(date)', data=mkt_data
).fit(cov_type='cluster', cov_kwds={'groups': mkt_data['city']})

print("ATT:", m.params["treated:post"])
m.conf_int().loc["treated:post"]
ATT: 0.6917359536407248
0    0.296101
1    1.087370
Name: treated:post, dtype: float64
추정된 ATT는 동일한데 왜 데이터 집계 방식에 따라 왜 신뢰구간 추정이 달라지는가?#
\begin{array}{lcc} \textbf{구분} & \textbf{기존 표준오차 (nonrobust)} & \textbf{군집 표준오차 (cluster-robust)} \ \hline 집계방식 1 (pre/post 평균형) & [0.4099 , 0.9736] & [0.1382 , 1.2453] \ 집계방식 2 (개별 시점형) & [0.5152 , 0.8683] & [0.4693 , 0.9142] \ \end{array}
두 방식의 신뢰구간이 달라지는 이유는 데이터의 집계 수준이 다르기 때문입니다.
집계형 방식(집계 방식 1)은 정보량이 적고 자유도가 작아 표준오차가 커지기 쉬워 신뢰구간이 넓어질 가능성이 높고,
개별 시점형 방식(집계 방식2)은 더 많은 표본과 변동을 활용하므로 표준오차가 작아져 신뢰구간이 오히려 더 좁게 나올 수 있습니다.
3.4 DID with covariates#
시간에 따라 변하는 관측 가능한 공변량(\(X_{it}\))을 추가하는 방식입니다. 예) TWFE모델에 공변량 추가하기 $\(Y_{it} = \alpha_i + \gamma_t + \beta (\text{Treated}_i \times \text{Post}_t) + \delta'X_{it} + \epsilon_{it}\)$
시간에 따라 그룹 간 다르게 변화하는 관측 가능한 교란 요인을 통제함으로써 평행 추세 가정을 더욱 만족할 수 있습니다.
추정치의 정밀도를 높이고, 관측 가능한 교란 요인으로 인한 편향을 줄입니다.
어떤 공변량을 포함할지 신중하게 선택해야 하며, 여전히 관측되지 않은 교란 요인에 의한 편향 가능성은 남아 있습니다.
아래 데이터는 기존 mkt_data에 처치 전의 공변량(지역)이 추가 된 데이터 입니다. 즉, 자금까지는 서부지역에 국한하여 처치효과를 알아봤다면 이번엔 전체 지역에 확장하여 알아보겠습니다.
mkt_data_all = (pd.read_csv("../data/matheus_data/short_offline_mkt_all_regions.csv")
                .astype({"date":"datetime64[ns]"}))
mkt_data_all["region"].unique()
array(['W', 'N', 'S', 'E'], dtype=object)
plt.figure(figsize=(15,6))
sns.lineplot(data=mkt_data_all.groupby(["date", "region", "treated"])[["downloads"]].mean().reset_index(),
             x="date", y="downloads", hue="region", style="treated", palette="gray")

plt.vlines(pd.to_datetime("2021-05-15"), 15, 55, ls="dotted", label="Intervention")
plt.legend(fontsize=14)

plt.xticks(rotation=25)
(array([18748., 18752., 18756., 18760., 18764., 18768., 18772., 18776.,
        18779.]),
 [Text(18748.0, 0, '2021-05-01'),
  Text(18752.0, 0, '2021-05-05'),
  Text(18756.0, 0, '2021-05-09'),
  Text(18760.0, 0, '2021-05-13'),
  Text(18764.0, 0, '2021-05-17'),
  Text(18768.0, 0, '2021-05-21'),
  Text(18772.0, 0, '2021-05-25'),
  Text(18776.0, 0, '2021-05-29'),
  Text(18779.0, 0, '2021-06-01')])
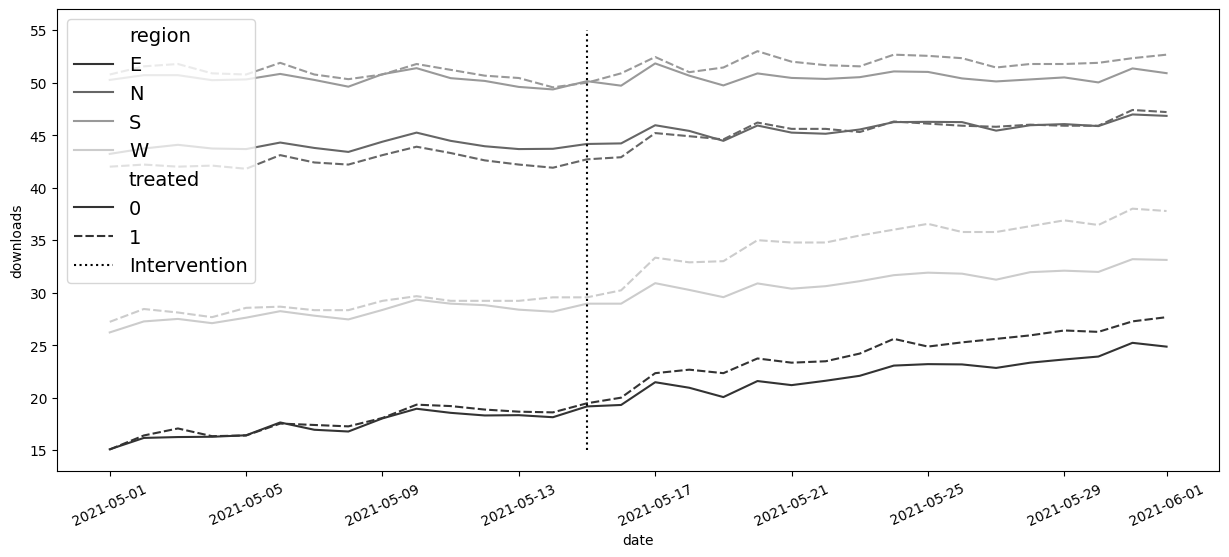
처치 이전 추세의 경우 지역내에서는 평행하지만 지역 간에는 평행하지 않은 것으로 보입니다. 이러한 상황해서 단순히 이원고정효과모델을 적용하면 ATT에 대해 편향된 추정값을 얻게되죠.
print("True ATT: ", mkt_data_all.query("treated*post==1")["tau"].mean())

m = smf.ols('downloads ~ treated:post + C(city) + C(date)',
            data=mkt_data_all).fit()

print("Estimated ATT:", m.params["treated:post"])
True ATT:  1.7208921056102682
Estimated ATT: 2.0683919842562752
따라서 이 문제를 해결하기 위해선 각 지역별로 서로 다른 추세가 있다는 것을 반드시 고려해야합니다.
그럼 어떻게 지역별로 서로 다른 추세가 있다는 것을 모델에 반영할 수 있을까요? 바로 모델에 처치전의 공변량(covariates)을 포함하는 것입니다.
공변량을 모델에 반영하여 ATT추정하는 방법은 대표적으로 2가지 방법이 있습니다.
각 지역별로 별도의 DID 회귀 모델 적용하고 ATT 가중평균하여 구하기
지역 변수와 처치 후 더미 변수와 상호작용하기
1. 각 지역별로 별도의 DID 회귀 모델 적용하고 ATT 가중평균(\(\hat\theta=\sum_r w_r \widehat{ATT}_r\))하여 구하기#
m_saturated = smf.ols('downloads ~ (post*treated)*C(region)',
                      data=mkt_data_all).fit()

atts = m_saturated.params[m_saturated.params.index.str.contains("post:treated")]
atts
post:treated                   1.676808
post:treated:C(region)[T.N]   -0.343667
post:treated:C(region)[T.S]   -0.985072
post:treated:C(region)[T.W]    1.369363
dtype: float64
추정#
# (1) region size (가중치 계산)
reg_size = (mkt_data_all.groupby("region").size()
            / len(mkt_data_all["date"].unique()))

# (2) saturated DID 결과 계수
atts = m_saturated.params[m_saturated.params.index.str.contains("post:treated")]
cov = m_saturated.cov_params()  # 분산-공분산 행렬

# (3) base (= region baseline ATT, 보통 첫 지역)
base = atts.iloc[0]

# (4) 선형 조합 벡터 만들기
weights = [reg_size.iloc[0]] + list(reg_size.iloc[1:])
coefs = [base] + list(atts.iloc[1:] + base)

theta = np.dot(weights, coefs) / reg_size.sum()

# (5) 대응되는 선형 조합 벡터 정의 (계수 개수만큼)
# 인덱스 맞추기
att_idx = atts.index
w = np.zeros(len(m_saturated.params))

# baseline
w[m_saturated.params.index.get_loc(att_idx[0])] = reg_size.iloc[0]

# 나머지 region 효과들
for att_name, size in zip(att_idx[1:], reg_size.iloc[1:]):
    w[m_saturated.params.index.get_loc(att_idx[0])] += size   # baseline part
    w[m_saturated.params.index.get_loc(att_name)] += size     # interaction part

# normalize
w = w / reg_size.sum()

# (6) 분산 계산
theta_var = w @ cov @ w
theta_se = np.sqrt(theta_var)

# (7) 신뢰구간
alpha = 0.05
z = norm.ppf(1 - alpha/2)

ci_lower = theta - z * theta_se
ci_upper = theta + z * theta_se

print("Weighted ATT:", theta)
print("95% CI:", (ci_lower, ci_upper))
Weighted ATT: 1.6940400451471986
95% CI: (np.float64(1.3897593237876618), np.float64(1.9983207665067355))
2. 지역변수와 처치 후 더미변수와 상호작용하기#
m = smf.ols('downloads ~ post*(treated + C(region))',
            data=mkt_data_all).fit()

m.summary().tables[1]
| coef | std err | t | P>|t| | [0.025 | 0.975] | |
|---|---|---|---|---|---|---|
| Intercept | 17.3522 | 0.101 | 172.218 | 0.000 | 17.155 | 17.550 |
| C(region)[T.N] | 26.2770 | 0.137 | 191.739 | 0.000 | 26.008 | 26.546 |
| C(region)[T.S] | 33.0815 | 0.135 | 245.772 | 0.000 | 32.818 | 33.345 |
| C(region)[T.W] | 10.7118 | 0.135 | 79.581 | 0.000 | 10.448 | 10.976 |
| post | 4.9807 | 0.134 | 37.074 | 0.000 | 4.717 | 5.244 |
| post:C(region)[T.N] | -3.3458 | 0.183 | -18.310 | 0.000 | -3.704 | -2.988 |
| post:C(region)[T.S] | -4.9334 | 0.179 | -27.489 | 0.000 | -5.285 | -4.582 |
| post:C(region)[T.W] | -1.5408 | 0.179 | -8.585 | 0.000 | -1.893 | -1.189 |
| treated | 0.0503 | 0.117 | 0.429 | 0.668 | -0.179 | 0.280 |
| post:treated | 1.6811 | 0.156 | 10.758 | 0.000 | 1.375 | 1.987 |
post:treated에 대한 매개 변수를 ATT로 해석합니다.
추정#
print("ATT:", m.params["post:treated"])
m.conf_int().loc["post:treated"]
ATT: 1.6810982546487103
0    1.374772
1    1.987424
Name: post:treated, dtype: float64
3.5 Doubly Robust Diff-in-Diff (DRDiD)#
DRDID는 기존 DiD 분석(Difference-in-Differences, DiD)의 확장된 형태로,
조건부 평행 추세 가정을 만족시키기 위해 처치 전 정보와 시간에 따라 변하지 않는 공변량을 결합하는 방법입니다.
성향 점수 모델(Propensity Score Model)과 결과 모델(Delta Outcome Model)이라는 두 가지 모델을 동시에 사용하여 공변량(covariates)을 조정하며, 이 두 모델 중 하나만 올바르게 지정되어도 편향 없는(unbiased) 추정치를 얻을 수 있어 신뢰성이 높습니다.
Step1: Propensity Score Model#
ATT에만 관심이 있으므로 대조군을 바탕으로 실험군을 재구성하는 단계입니다.
import warnings
warnings.filterwarnings('ignore')
unit_df = (mkt_data_all
           # keep only the first date
           .astype({"date": str})
           .query(f"date=='{mkt_data_all['date'].astype(str).min()}'")
           .drop(columns=["date"])) # just to avoid confusion

ps_model = smf.logit("treated~C(region)", data=unit_df).fit(disp=0)
Step 2 Delta Outcome Model#
DiD는 결과 변화량인 \(\Delta y\)와 관련되어 있습니다. 따라서 기본 결과 모델 대신 시간에 따른 델타 결과 모델을 구하는 단계입니다.
delta_y = (
    mkt_data_all.query("post==1").groupby("city")["downloads"].mean()
    - mkt_data_all.query("post==0").groupby("city")["downloads"].mean()
)


df_delta_y = (unit_df
              .set_index("city")
              .join(delta_y.rename("delta_y")))

outcome_model = smf.ols("delta_y ~ C(region)", data=df_delta_y).fit()
Step 3 성향 점수 및 결과 모델을 결합하는 단계#
df_dr = (df_delta_y
         .assign(y_hat = lambda d: outcome_model.predict(d))
         .assign(ps = lambda d: ps_model.predict(d)))

df_dr.head()
| region | treated | tau | downloads | post | delta_y | y_hat | ps | |
|---|---|---|---|---|---|---|---|---|
| city | ||||||||
| 1 | W | 0 | 0.0 | 27.0 | 0 | 3.087302 | 3.736539 | 0.176471 |
| 2 | N | 0 | 0.0 | 40.0 | 0 | 1.436508 | 1.992570 | 0.212766 |
| 3 | W | 0 | 0.0 | 30.0 | 0 | 2.761905 | 3.736539 | 0.176471 |
| 4 | W | 0 | 0.0 | 26.0 | 0 | 3.396825 | 3.736539 | 0.176471 |
| 5 | S | 0 | 0.0 | 51.0 | 0 | -0.476190 | 0.343915 | 0.176471 |
tr = df_dr.query("treated==1")
co = df_dr.query("treated==0")

dy1_treat = (tr["delta_y"] - tr["y_hat"]).mean()

w_cont = co["ps"]/(1-co["ps"])
dy0_treat = np.average(co["delta_y"] - co["y_hat"], weights=w_cont)

print("ATT:", dy1_treat - dy0_treat)
ATT: 1.6773180394442853
mkt_data["region"].unique()
array(['S'], dtype=object)
지금까지는 블록 디자인을 기반으로 즉, 동일 시점에 처치 받은 대상과 받지 않은 대상이 존재하는 데이터로 여러 DiD 분석을 수행했습니다.
그런데 실험 대상이 서로 다른 시점에 처치를 받을 수 있습니다. 이런 경우는 어떻게 해야할까요?
이 경우 Staggered DiD을 사용합니다.
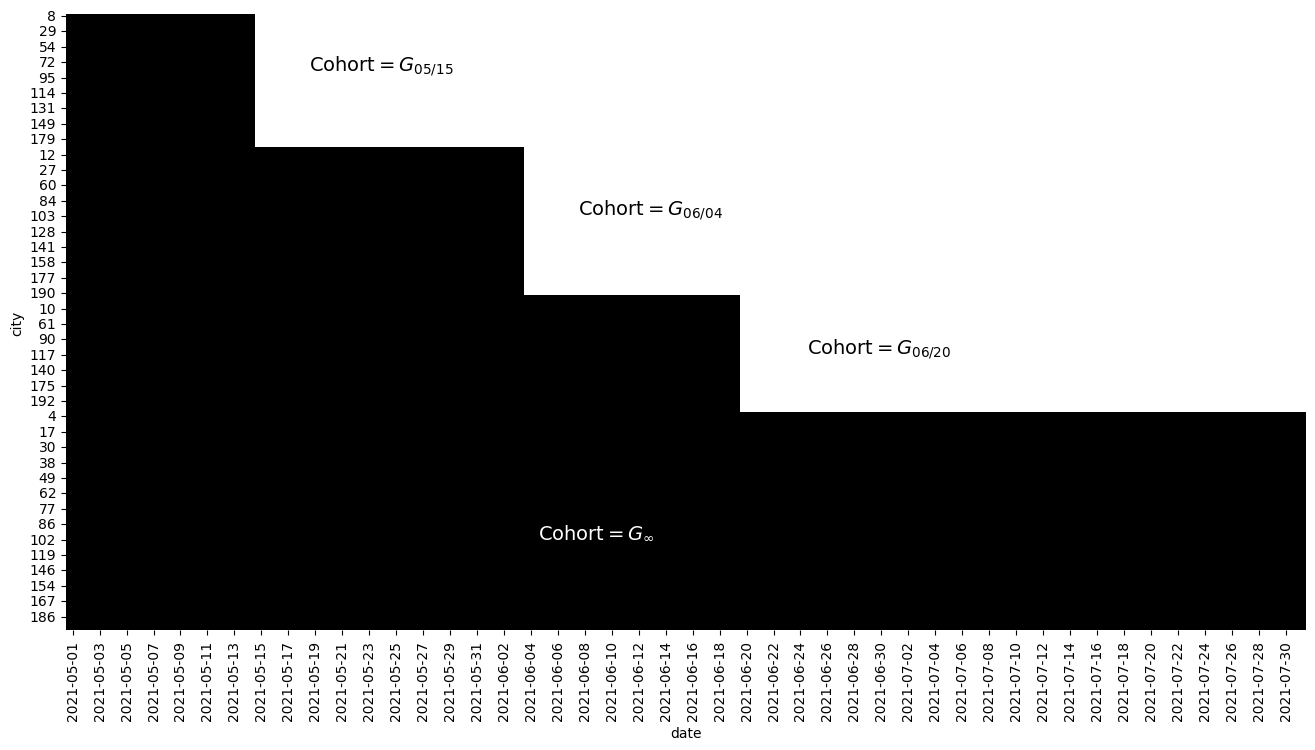
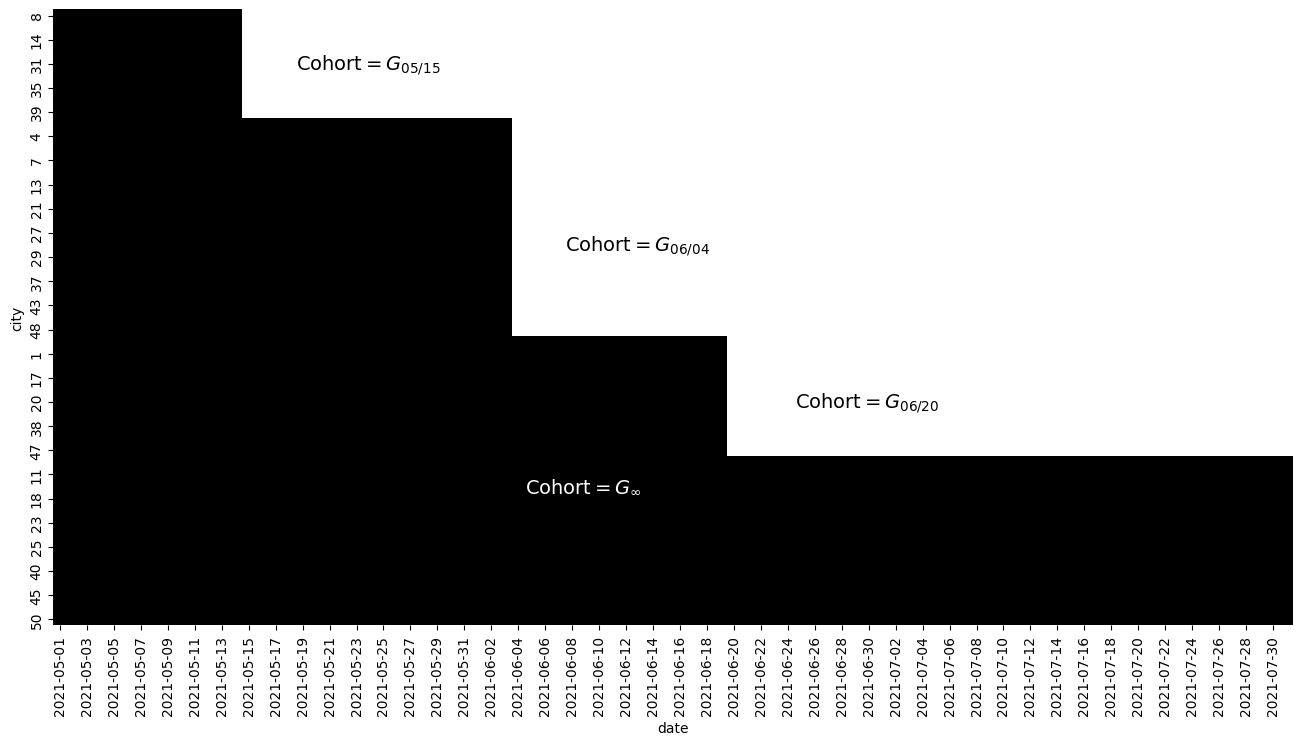
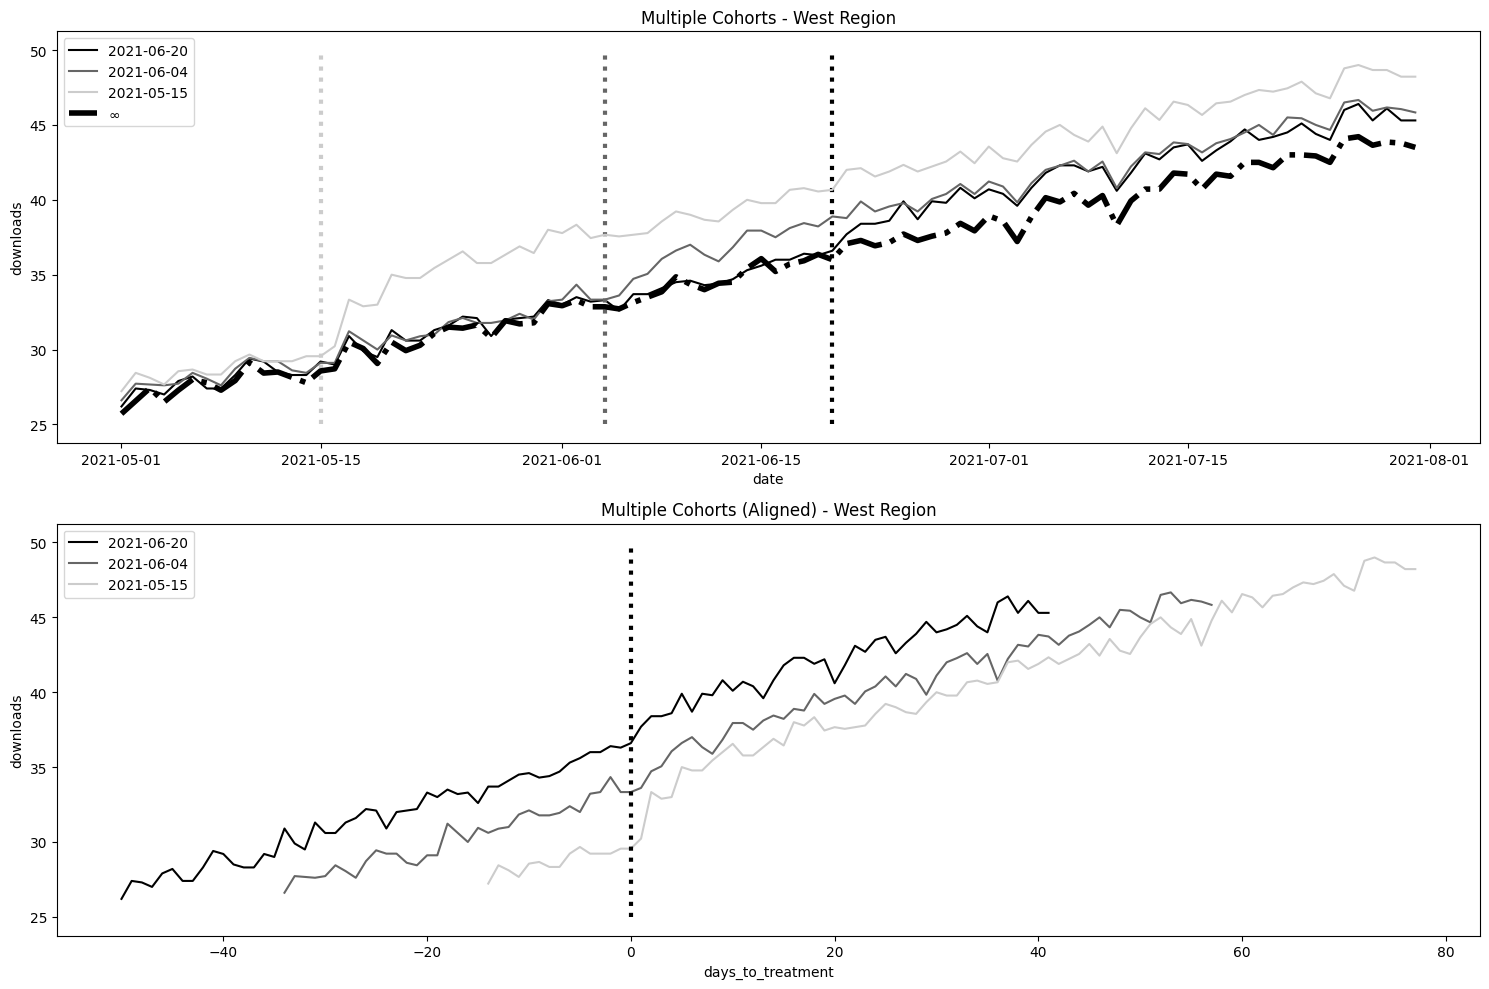
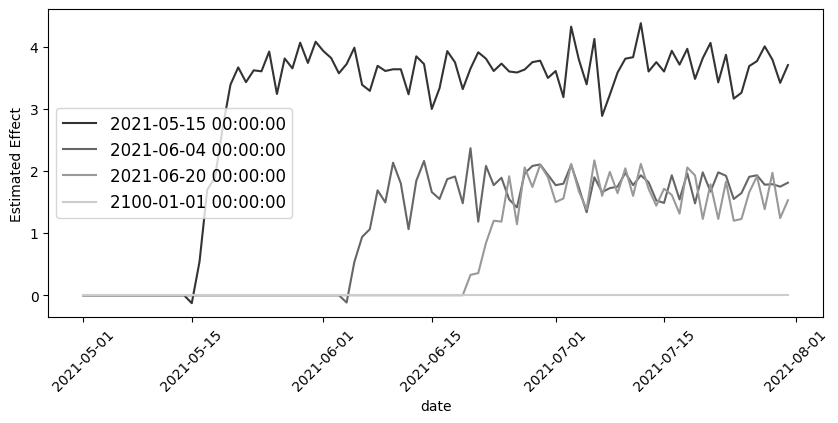
먼저 처치에 대해 시차 도입설계를 하여 데이터를 구성합니다. 즉, 처치 받는 시점이 그룹을 구분하는 기준이 됩니다.이때 구분된 그룹들을 일반적으로 코호트라고 부릅니다. 또한 시간에 걸쳐 효과가 동일하다는 가정도 추가되어야 합니다. 그러나 우리가 사용할 데이터에서는 해당 가정이 충족되지 않습니다. 효과가 나타나기 전까진 어능정도 시간이 걸리므로 처치 직후에는 낮고 이후에 점차 증가하기 떄문입니다. 이런 시간에 따른 효과 변동때문에 ATT추정값에 편향이 생기게 되는데요. 이를 해결하는 방법으로
TWFE(이원고정효과모델)을 사용할 때 상호작용하는 더미변수 사용
문제를 여러 개의 2x2(basic) DiD으로 나누고 각각을 개별적으로 계산한 후 결과를 합치는 것
이때 처치를 전혀 받지 않은 그룹을 대조군으로 사용하여 각 코호트에 대해 하나의 DiD모델을 추정함
이 있습니다.
이전에는 처치를 받는 혹은 받지 않는 2개의 코호트로 이루어진 데이터를 사용했다면 이번엔 날짜를 확장하여 2021-07-31까지의 모든 지역의 도시에 대한 데이터가 포함되어있는 코호트가 3개 이상인 경우인 데이터를 다루겠습니다.
3.6 Staggered DiD#
Staggered DiD: Canonical vs Dynamic View
구분 |
Canonical View |
Dynamic (Event-study) View |
|---|---|---|
핵심 아이디어 |
Staggered DiD는 canonical DiD의 확장형, 여러 시점과 그룹에 반복 적용된 2×2 DiD 구조 |
Staggered DiD를 event-time 기준으로 재정렬하여 시점별 효과 \(\beta_k\) 추정 (Dynamic DID 형태) |
초점 |
평균 처치 효과 (ATT) |
시간에 따른 처치 효과 변화 (dynamic ATT) |
처치 시점 |
모든 단위의 개입 시점 동일하거나, 시점별 DiD 반복 |
단위별로 상이한 개입 시점 (staggered adoption) |
대표 모형 |
\(Y_{it} = \alpha_i + \lambda_t + \beta D_{it} + \epsilon_{it}\) |
\(Y_{it} = \alpha_i + \lambda_t + \sum_k \beta_k \cdot 1\{t - G_i = k\} + \epsilon_{it}\) |
요약 |
구조적으로는 canonical DID의 반복적 적용 |
추정 관점에서는 event-study 기반 Dynamic DID로 해석 가능 |
⇒ 따라서 Staggered DiD는 canonical DID의 확장형이면서도, event-study 기반 Dynamic DID로 해석될 수 있습니다.
mkt_data_cohorts = (pd.read_csv("../data/matheus_data/offline_mkt_staggered.csv")
                    .astype({
                        "date":"datetime64[ns]",
                        "cohort":"datetime64[ns]"}))

mkt_data_cohorts.head()
| date | city | region | cohort | treated | tau | downloads | post | |
|---|---|---|---|---|---|---|---|---|
| 0 | 2021-05-01 | 1 | W | 2021-06-20 | 1 | 0.0 | 27.0 | 0 |
| 1 | 2021-05-02 | 1 | W | 2021-06-20 | 1 | 0.0 | 28.0 | 0 |
| 2 | 2021-05-03 | 1 | W | 2021-06-20 | 1 | 0.0 | 28.0 | 0 |
| 3 | 2021-05-04 | 1 | W | 2021-06-20 | 1 | 0.0 | 26.0 | 0 |
| 4 | 2021-05-05 | 1 | W | 2021-06-20 | 1 | 0.0 | 28.0 | 0 |
mkt_data_cohorts.loc[mkt_data_cohorts["region"]=="W"]["city"].unique()
array([  1,   3,   4,   6,   7,  10,  13,  17,  21,  26,  35,  38,  50,
        53,  54,  56,  61,  65,  66,  67,  68,  70,  77,  79,  82,  84,
        85,  90,  94,  98, 103, 114, 122, 128, 129, 132, 133, 136, 138,
       140, 143, 144, 155, 156, 169, 172, 176, 182, 184, 198, 200])
plt_data = (mkt_data_cohorts
            .astype({"date":"str"})
            .assign(treated_post = lambda d: d["treated"]*(d["date"]>=d["cohort"]))
          .pivot(index="city", columns="date", values="treated_post")
            .reset_index()
            .sort_values(list(sorted(mkt_data_cohorts.query("cohort!='2100-01-01'")["cohort"].astype("str").unique())), ascending=False)
            .reset_index()
            .drop(columns=["city"])
            .rename(columns={"index":"city"})
            .set_index("city"))


plt.figure(figsize=(16,8))

sns.heatmap(plt_data, cmap="gray",cbar=False)
plt.text(18, 18, "Cohort$=G_{05/15}$", size=14)
plt.text(38, 65, "Cohort$=G_{06/04}$", size=14)
plt.text(55, 110, "Cohort$=G_{06/20}$", size=14)
plt.text(35, 170, "Cohort$=G_{\\infty}$", color="white", size=14, weight=3);
서부지역에 한하여 먼저 이원고정효과 모델을 적용해보도록 하겠습니다.
mkt_data_cohorts_w = mkt_data_cohorts.query("region=='W'")
plt_data = (mkt_data_cohorts_w
            .astype({"date":"str"})
            .assign(treated_post = lambda d: d["treated"]*(d["date"]>=d["cohort"]))
          .pivot(index="city", columns="date", values="treated_post")
            .reset_index()
            .sort_values(list(sorted(mkt_data_cohorts_w.query("cohort!='2100-01-01'")["cohort"].astype("str").unique())), ascending=False)
            .reset_index()
            .drop(columns=["city"])
            .rename(columns={"index":"city"})
            .set_index("city"))


plt.figure(figsize=(16,8))

sns.heatmap(plt_data, cmap="gray",cbar=False)
plt.text(18, 5, "Cohort$=G_{05/15}$", size=14)
plt.text(38, 20, "Cohort$=G_{06/04}$", size=14)
plt.text(55, 33, "Cohort$=G_{06/20}$", size=14)
plt.text(35, 40, "Cohort$=G_{\\infty}$", color="white", size=14, weight=3);
fig, (ax1, ax2) = plt.subplots(2, 1, figsize=(15, 10))

plt_data = (mkt_data_cohorts_w
            .groupby(["date", "cohort"])
            [["downloads"]]
            .mean()
            .reset_index()
)


for color, cohort in zip(["C0", "C1", "C2", "C3"], mkt_data_cohorts_w.query("cohort!='2100-01-01'")["cohort"].unique()):
    df_cohort = plt_data.query("cohort==@cohort")
    sns.lineplot(data=df_cohort, x="date", y="downloads",
                 label=pd.to_datetime(cohort).strftime('%Y-%m-%d'), ax=ax1)
    ax1.vlines(x=cohort, ymin=25, ymax=50, color=color, ls="dotted", lw=3)


sns.lineplot(data=plt_data.query("cohort=='2100-01-01'"), x="date", y="downloads", label="$\infty$", lw=4, ls="-.", ax=ax1)

ax1.legend()
ax1.set_title("Multiple Cohorts - West Region");


plt_data = (mkt_data_cohorts_w
            .assign(days_to_treatment = lambda d: (pd.to_datetime(d["date"])-pd.to_datetime(d["cohort"])).dt.days)
            .groupby(["date", "cohort"])
            [["downloads", "days_to_treatment"]]
            .mean()
            .reset_index()
)


for color, cohort in zip(["C0", "C1", "C2", "C3"], mkt_data_cohorts_w.query("cohort!='2100-01-01'")["cohort"].unique()):
    df_cohort = plt_data.query("cohort==@cohort")
    sns.lineplot(data=df_cohort, x="days_to_treatment", y="downloads",
                 label=pd.to_datetime(cohort).strftime('%Y-%m-%d'), ax=ax2)

ax2.vlines(x=0, ymin=25, ymax=50, color="black", ls="dotted", lw=3)

ax2.set_title("Multiple Cohorts (Aligned) - West Region")
ax2.legend();

plt.tight_layout()
mkt_data_cohorts_w['date'] = mkt_data_cohorts_w['date'].dt.strftime('%Y-%m-%d')
mkt_data_cohorts_w['cohort'] = mkt_data_cohorts_w['cohort'].astype(str)
TWFE(이원고정효과모델)을 사용할 때 상호작용하는 더미변수 사용 -> treated:post:C(cohort):C(date)
만약 실험 대상인 도시들과 날싸를 상호작용하는 더미변수로 사용하는 경우 표본 수와 같은 파라메터를 얻게 됩니다. 이렇게 되면 OLS가 실행이 되지 않을 수 있습니다. 따라서 코호트를 통해 실험 대상을 그룹화 하여 코호트 별로 효과를 추정하는 것으로 문제를 바꾸어 생각할 수 있습니다.
formula = "downloads ~ treated:post:C(cohort):C(date) + C(city) + C(date)"

twfe_model = smf.ols(formula, data=mkt_data_cohorts_w.astype({"date":str, "cohort": str})).fit()

effects = (twfe_model.params[twfe_model.params.index.str.contains("treated")]
           .reset_index()
           .rename(columns={0:"param"})
           .assign(cohort=lambda d: d["index"].str.extract(r'C\(cohort\)\[(.*)\]:'))
           .assign(date=lambda d: d["index"].str.extract(r':C\(date\)\[(.*)\]'))
           .assign(date=lambda d: pd.to_datetime(d["date"]), cohort=lambda d: pd.to_datetime(d["cohort"])))

plt.figure(figsize=(10,4))
sns.lineplot(data=effects, x="date", y="param", hue="cohort", palette="gray")
plt.xticks(rotation=45)
plt.ylabel("Estimated Effect")
plt.legend(fontsize=12)

df_pred = (
    mkt_data_cohorts_w
    .query("post==1 & treated==1")
    .assign(date=lambda d: d['date'].astype(str))  # Convert to string
    .assign(y_hat_0=lambda d: twfe_model.predict(d.assign(treated=0)))
    .assign(effect_hat=lambda d: d["downloads"] - d["y_hat_0"])
)

print("Number of param.:", len(twfe_model.params))
print("True Effect: ", df_pred["tau"].mean())
print("Pred. Effect: ", df_pred["effect_hat"].mean())
Number of param.: 510
True Effect:  2.2625252108176266
Pred. Effect:  2.259766144684955
여러 개의 2x2 DiD으로 나누고 각각을 개별적으로 계산한 후 결과 합치기
cohorts = sorted(mkt_data_cohorts_w["cohort"].unique())

treated_G = cohorts[:-1]
nvr_treated = cohorts[-1]

def did_g_vs_nvr_treated(df: pd.DataFrame,
                         cohort: str,
                         nvr_treated: str,
                         cohort_col: str = "cohort",
                         date_col: str = "date",
                         y_col: str = "downloads"):
    did_g = (
        df
        .loc[lambda d:(d[cohort_col] == cohort)|
                      (d[cohort_col] == nvr_treated)]
        .assign(treated = lambda d: (d[cohort_col] == cohort)*1)
        .assign(post = lambda d:(pd.to_datetime(d[date_col])>=cohort)*1)
    )

    att_g = smf.ols(f"{y_col} ~ treated*post",
                    data=did_g).fit().params["treated:post"]
    size = len(did_g.query("treated==1 & post==1"))
    return {"att_g": att_g, "size": size}


atts = pd.DataFrame(
    [did_g_vs_nvr_treated(mkt_data_cohorts_w, cohort, nvr_treated)
     for cohort in treated_G]
)

atts
| att_g | size | |
|---|---|---|
| 0 | 3.455535 | 702 |
| 1 | 1.659068 | 1044 |
| 2 | 1.573687 | 420 |
결과
가충치인 각 코호트의 표본 크기(\(T*N\))을 고려하여 위 결과를 가중평균하여 ATT를 구해보겠습니다.
(atts["att_g"]*atts["size"]).sum()/atts["size"].sum()
np.float64(2.2247467740558933)
공변량 추가하기
위 두 가지 방법을 통해 서부지역의 TWFE의 편향문제를 해결했습니다.
이제 공변량으로 시간과 지역이 상호작용하는 항을 추가하여 전체지역에 대한 처치효과를 알아보도록 하겠습니다.
이 때 방법은 여러 매개변수의 개별 효과를 평균낸 후 ATT를 구하도록 하겠습니다.
formula = """
downloads ~ treated:post:C(cohort):C(date)
+ C(date):C(region) + C(city) + C(date)"""

twfe_model = smf.ols(formula, data=mkt_data_cohorts).fit()
df_pred = (
    mkt_data_cohorts
    .query("post==1 & treated==1")
    .assign(y_hat_0=lambda d: twfe_model.predict(d.assign(treated=0)))
    .assign(effect_hat=lambda d: d["downloads"] - d["y_hat_0"])
)

print("Number of param.:", len(twfe_model.params))
print("True Effect: ",  df_pred["tau"].mean())
print("Pred. Effect: ", df_pred["effect_hat"].mean())
Number of param.: 935
True Effect:  2.078397729895905
Pred. Effect:  2.0435092760332583
3.7 DDD(Triple Difference,Difference-in-Difference-in-Differences)#
예) \(Y_{itd} = \alpha + \delta_1 \text{Treated}_i + \delta_2 \text{Post}_t + \delta_3 \text{Region}_d+\delta_4 (\text{Treated}_i \times \text{Post}_t)+\delta_5 (\text{Treated}_i \times \text{Region}_d) \\ +\delta_6 (\text{Post}_t \times \text{Region}_d) +\color{blue}{\beta (\text{Treated}_i \times \text{Post}_t \times \text{Region}_d)} + \varepsilon_{itd}\)
DID는 처치 전후 변화의 차이를 비교합니다. 즉 (처치그룹 변화) − (비처치그룹 변화)를 나타냅니다. DDD는 여기에 차분을 한번 더 추가하여 지역 또는 집단 차이를 봅니다.
즉 기존 DID로 추정한 정책 효과(처치 효과) 가 지역이나 집단에 따라 얼마나 다르게 나타나는지(이질적 효과, heterogeneous effect) 를 추가적으로 식별합니다.
import statsmodels.formula.api as smf

# Triple Difference 모형
formula = "downloads ~ treated * post * C(region)"

ddd_model = smf.ols(formula, data=mkt_data_all).fit(
    cov_type="cluster", cov_kwds={"groups": mkt_data_all["city"]}
)

print(ddd_model.summary())

# Triple Difference 추정치 (핵심 효과)
ddd_term = [p for p in ddd_model.params.index if "treated:post:C(region)" in p]
for term in ddd_term:
    print(term, ":", ddd_model.params[term])
                            OLS Regression Results
==============================================================================
Dep. Variable:              downloads   R-squared:                       0.960
Model:                            OLS   Adj. R-squared:                  0.959
Method:                 Least Squares   F-statistic:                     1853.
Date:                Sun, 09 Nov 2025   Prob (F-statistic):          1.10e-204
Time:                        14:10:24   Log-Likelihood:                -14902.
No. Observations:                6400   AIC:                         2.984e+04
Df Residuals:                    6384   BIC:                         2.995e+04
Df Model:                          15
Covariance Type:              cluster
===============================================================================================
                                  coef    std err          z      P>|z|      [0.025      0.975]
-----------------------------------------------------------------------------------------------
Intercept                      17.2758      0.381     45.381      0.000      16.530      18.022
C(region)[T.N]                 26.6759      0.551     48.414      0.000      25.596      27.756
C(region)[T.S]                 33.0592      0.451     73.224      0.000      32.174      33.944
C(region)[T.W]                 10.6681      0.479     22.267      0.000       9.729      11.607
treated                         0.3099      0.593      0.523      0.601      -0.852       1.472
treated:C(region)[T.N]         -1.7759      0.970     -1.831      0.067      -3.677       0.126
treated:C(region)[T.S]          0.2995      0.913      0.328      0.743      -1.490       2.089
treated:C(region)[T.W]          0.4208      1.157      0.364      0.716      -1.846       2.688
post                            4.9819      0.044    113.583      0.000       4.896       5.068
post:C(region)[T.N]            -3.2730      0.064    -51.271      0.000      -3.398      -3.148
post:C(region)[T.S]            -4.7601      0.066    -72.092      0.000      -4.889      -4.631
post:C(region)[T.W]            -1.7829      0.064    -27.806      0.000      -1.909      -1.657
treated:post                    1.6768      0.270      6.217      0.000       1.148       2.205
treated:post:C(region)[T.N]    -0.3437      0.426     -0.806      0.420      -1.179       0.492
treated:post:C(region)[T.S]    -0.9851      0.333     -2.957      0.003      -1.638      -0.332
treated:post:C(region)[T.W]     1.3694      0.717      1.911      0.056      -0.035       2.774
==============================================================================
Omnibus:                       24.370   Durbin-Watson:                   0.414
Prob(Omnibus):                  0.000   Jarque-Bera (JB):               31.120
Skew:                           0.050   Prob(JB):                     1.75e-07
Kurtosis:                       3.326   Cond. No.                         32.1
==============================================================================

Notes:
[1] Standard Errors are robust to cluster correlation (cluster)
treated:post:C(region)[T.N] : -0.343667477000822
treated:post:C(region)[T.S] : -0.98507180650041
treated:post:C(region)[T.W] : 1.369362559838747
effects = pd.DataFrame({
    "Region": ["Baseline", "N", "S", "W"],
    "ATT": [1.68, 1.34, 0.70, 3.05]
})

plt.figure(figsize=(6,4))
plt.bar(effects["Region"], effects["ATT"], color=["gray","skyblue","salmon","lightgreen"])
plt.title("Region-specific Policy Effects (DDD)")
plt.ylabel("Estimated ATT")
plt.axhline(0, color='black', linestyle='--')
plt.show()
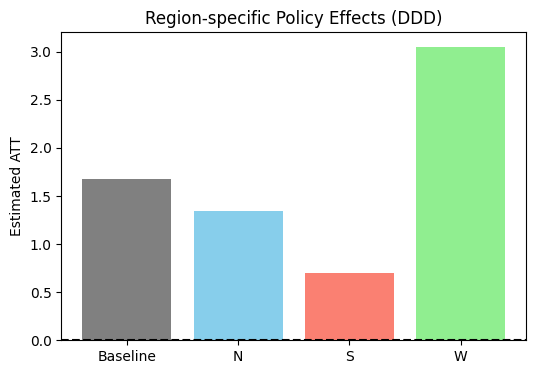
분석 결과 정책 시행 이후 baseline 지역에서는 downloads가 평균 1.68 증가하였습니다.
그러나 지역별로 효과는 상이하게 나타났으며, S 지역에서는 효과가 0.98 감소(유의), W 지역에서는 1.37 증가(한계적 유의) 하였습니다.
이는 정책 효과가 지역적 특성에 따라 다르게 나타난다는 점을 보여줍니다.
3.8 Dynamic DiD - Event study#
예) \(Y_{it} = \alpha_i + \gamma_t + \beta_t \, (\text{Treated}_i \times \text{Post}_{it}) + \varepsilon_{it}\)
Event Study(이벤트 스터디) 는 처치가 발생한 시점을 기준으로 시간 축(event time)을 설정해, 처치 전후의 효과를 시점별로 추정하는 방법입니다.
일반적으로 처치 시점을 0으로 두고, 그 이전은 –1, –2, 이후는 +1, +2와 같이 표현합니다. 각 시점별로 처치군과 대조군의 차이를 계산해 시점별 효과(βₜ)를 추정하며, 이를 통해 처치 이후 효과가 시간에 따라 커지거나 작아지는지, 혹은 처치 이전부터 이미 차이가 존재했는지를 확인할 수 있습니다.
이 방법은 세 가지 측면에서 중요합니다.
첫째, 처치 이전 구간의 계수 βₜ가 0에 가깝다면 평행추세(Parallel Trends) 가정이 충족됨을 의미합니다.
둘째, 처치 이후 구간의 βₜ를 통해 동적 효과(Dynamic Treatment Effect) 를 확인할 수 있습니다.
셋째, 정책이나 프로그램의 시차 효과(lag effect) 를 평가할 수 있어 단기적·장기적 처치 효과를 함께 분석할 수 있습니다.
def did_date(df, date):
    df_date = (df
               .query("date==@date | post==0")
               .query("date <= @date")
               .assign(post = lambda d: (d["date"]==date).astype(int)))

    m = smf.ols(
        'downloads ~ I(treated*post) + C(city) + C(date)', data=df_date
    ).fit(cov_type='cluster', cov_kwds={'groups': df_date['city']})

    att = m.params["I(treated * post)"]
    ci = m.conf_int().loc["I(treated * post)"]

    return pd.DataFrame({"att": att, "ci_low": ci[0], "ci_up": ci[1]},
                        index=[date])


post_dates = sorted(mkt_data["date"].unique())[1:]

atts = pd.concat([did_date(mkt_data, date)
                  for date in post_dates])

atts.head()
| att | ci_low | ci_up | |
|---|---|---|---|
| 2021-05-02 | 0.325397 | -0.491741 | 1.142534 |
| 2021-05-03 | 0.384921 | -0.388389 | 1.158231 |
| 2021-05-04 | -0.156085 | -1.247491 | 0.935321 |
| 2021-05-05 | -0.299603 | -0.949935 | 0.350729 |
| 2021-05-06 | 0.347619 | 0.013115 | 0.682123 |
print("처치가 시작된 날:",mkt_data_all.loc[mkt_data_all["post"]==1].min()["date"] )
처치가 시작된 날: 2021-05-15 00:00:00
def event_study(df, treatment_date='2021-05-15'):
    """
    Event study analysis for difference-in-differences

    Parameters:
    - df: DataFrame with columns [date, city, treated, downloads, post]
    - treatment_date: The event date when treatment starts (default: '2021-05-15')
    """
    df_es = df.copy()

    # Convert date to datetime if needed
    if not pd.api.types.is_datetime64_any_dtype(df_es['date']):
        df_es['date'] = pd.to_datetime(df_es['date'])

    treatment_date = pd.Timestamp(treatment_date)

    # Create relative time (days from treatment date)
    df_es['rel_time'] = (df_es['date'] - treatment_date).dt.days

    # Set reference period as -1 (2021-05-14, day before treatment)
    reference_period = -1

    # Create dummy variables for each relative time period (excluding reference)
    time_dummies = pd.get_dummies(df_es['rel_time'], prefix='t', dtype=int)

    if f't_{reference_period}' in time_dummies.columns:
        time_dummies = time_dummies.drop(f't_{reference_period}', axis=1)

    # Interact time dummies with treatment status
    # Use Q() to escape variable names with special characters
    for col in time_dummies.columns:
        # Create interaction variable in dataframe
        var_name = f'treated_x_{col}'
        df_es[var_name] = df_es['treated'] * time_dummies[col]

    # Build formula using Q() for variable names with negative numbers
    interaction_terms = []
    for col in time_dummies.columns:
        var_name = f'treated_x_{col}'
        # Use Q() to quote variable names
        interaction_terms.append(f'Q("{var_name}")')

    formula = f"downloads ~ {' + '.join(interaction_terms)} + C(city) + C(date)"

    # Fit model with clustered standard errors
    model = smf.ols(formula, data=df_es).fit(
        cov_type='cluster',
        cov_kwds={'groups': df_es['city']}
    )

    # Extract results
    results = []
    for param_name in model.params.index:
        if param_name.startswith('Q("treated_x_t_'):
            # Extract rel_time from parameter name
            rel_time_str = param_name.replace('Q("treated_x_t_', '').replace('")', '')
            rel_time = int(rel_time_str)
            ci = model.conf_int().loc[param_name]

            results.append({
                'rel_time': rel_time,
                'att': model.params[param_name],
                'ci_low': ci[0],
                'ci_up': ci[1],
                'se': model.bse[param_name],
                'pvalue': model.pvalues[param_name]
            })

    # Add reference period (normalized to 0)
    results.append({
        'rel_time': reference_period,
        'att': 0.0,
        'ci_low': 0.0,
        'ci_up': 0.0,
        'se': 0.0,
        'pvalue': np.nan
    })

    results_df = pd.DataFrame(results).sort_values('rel_time').reset_index(drop=True)

    return results_df, model


results_df, model = event_study(mkt_data, treatment_date='2021-05-15')


# 결과 확인
print("=== Pre-treatment periods (2021-05-01 ~ 2021-05-14) ===")
print(results_df[results_df['rel_time'] < 0])

print("\n=== Post-treatment periods (2021-05-15 onwards) ===")
print(results_df[results_df['rel_time'] >= 0])


def plot_event_study(results_df, treatment_date='2021-05-15', alpha_level=0.05):
    fig, ax = plt.subplots(figsize=(14, 7))

    # Reference lines
    ax.axhline(y=0, color='gray', linestyle='--', linewidth=1, alpha=0.7)
    ax.axvline(x=-0.5, color='red', linestyle='--', linewidth=2,
               label=f'Treatment Start ({treatment_date})', alpha=0.7)

    # Split by significance
    pre_treat = results_df[results_df['rel_time'] < 0].copy()
    post_treat = results_df[results_df['rel_time'] >= 0].copy()

    # Pre-treatment - significant vs non-significant
    pre_sig = pre_treat[pre_treat['pvalue'] > alpha_level]
    pre_nonsig = pre_treat[pre_treat['pvalue'] <= alpha_level]

    # Post-treatment - significant vs non-significant
    post_sig = post_treat[post_treat['pvalue'] < alpha_level]
    post_nonsig = post_treat[post_treat['pvalue'] >= alpha_level]

    # Plot non-significant (lighter color, hollow markers)
    if len(pre_nonsig) > 0:
        ax.errorbar(pre_nonsig['rel_time'], pre_nonsig['att'],
                    yerr=[pre_nonsig['att'] - pre_nonsig['ci_low'],
                          pre_nonsig['ci_up'] - pre_nonsig['att']],
                    fmt='o-', color='lightblue', capsize=4, capthick=1.5,
                    markersize=5, alpha=0.5, linewidth=1,
                    markerfacecolor='white', markeredgewidth=1.5)

    if len(post_nonsig) > 0:
        ax.errorbar(post_nonsig['rel_time'], post_nonsig['att'],
                    yerr=[post_nonsig['att'] - post_nonsig['ci_low'],
                          post_nonsig['ci_up'] - post_nonsig['att']],
                    fmt='o-', color='lightcoral', capsize=4, capthick=1.5,
                    markersize=5, alpha=0.5, linewidth=1,
                    markerfacecolor='white', markeredgewidth=1.5)

    # Plot significant (solid color, filled markers)
    if len(pre_sig) > 0:
        ax.errorbar(pre_sig['rel_time'], pre_sig['att'],
                    yerr=[pre_sig['att'] - pre_sig['ci_low'],
                          pre_sig['ci_up'] - pre_sig['att']],
                    fmt='o-', color='blue', capsize=4, capthick=1.5,
                    label='Pre-treatment (p<0.1)', markersize=6, alpha=0.9,
                    linewidth=2)

    if len(post_sig) > 0:
        ax.errorbar(post_sig['rel_time'], post_sig['att'],
                    yerr=[post_sig['att'] - post_sig['ci_low'],
                          post_sig['ci_up'] - post_sig['att']],
                    fmt='o-', color='red', capsize=4, capthick=1.5,
                    label='Post-treatment (p<0.1)', markersize=6, alpha=0.9,
                    linewidth=2)

    # Add gray background for significant post-treatment periods
    if len(post_sig) > 0:
        for _, row in post_sig.iterrows():
            ax.axvspan(row['rel_time']-0.4, row['rel_time']+0.4,
                      alpha=0.1, color='gray', zorder=0)

    # Legend
    from matplotlib.patches import Patch
    custom_lines = [
        plt.Line2D([0], [0], color='blue', marker='o', linewidth=2,
                   markersize=6, label='Pre-treatment (p<0.1)'),
        plt.Line2D([0], [0], color='red', marker='o', linewidth=2,
                   markersize=6, label='Post-treatment (p<0.1)'),
        plt.Line2D([0], [0], color='gray', marker='o', linewidth=1,
                   markersize=5, markerfacecolor='white', markeredgewidth=1.5,
                   label='Not significant (p≥0.1)', alpha=0.5),
        Patch(facecolor='gray', alpha=0.1, label='Significant period')
    ]
    ax.legend(handles=custom_lines, fontsize=10, loc='upper left')

    ax.set_xlabel('Days Relative to Treatment (2021-05-15)', fontsize=12)
    ax.set_ylabel('Treatment Effect on Downloads', fontsize=12)
    ax.set_title('Event Study: Dynamic Treatment Effects (Significance Highlighted)',
                 fontsize=14, fontweight='bold')
    ax.grid(True, alpha=0.3)

    plt.tight_layout()
    plt.show()

    # Print summary
    print(f"\n=== Significance Summary ===")
    print(f"Pre-treatment significant: {len(pre_sig)}/{len(pre_treat)}")
    print(f"Post-treatment significant: {len(post_sig)}/{len(post_treat)}")

plot_event_study(results_df, treatment_date='2021-05-15')
=== Pre-treatment periods (2021-05-01 ~ 2021-05-14) ===
    rel_time       att    ci_low     ci_up        se    pvalue
0        -14  0.317460 -0.445648  1.080569  0.389348  0.414864
1        -13  0.642857 -0.005605  1.291320  0.330854  0.052014
2        -12  0.865079 -0.025911  1.756070  0.454595  0.057045
3        -11  0.452381 -0.329286  1.234048  0.398817  0.256666
4        -10  0.269841 -0.642655  1.182337  0.465568  0.562187
5         -9  0.857143  0.296929  1.417357  0.285829  0.002710
6         -8  0.317460 -0.647464  1.282385  0.492317  0.519038
7         -7  0.515873 -0.480732  1.512478  0.508481  0.310327
8         -6 -0.230159 -1.277911  0.817594  0.534577  0.666800
9         -5  0.198413 -0.494862  0.891687  0.353718  0.574842
10        -4  0.595238 -0.505375  1.695851  0.561548  0.289147
11        -3  0.301587 -0.393374  0.996548  0.354578  0.395018
12        -2  0.650794 -0.120146  1.421733  0.393344  0.098023
13        -1  0.000000  0.000000  0.000000  0.000000       NaN

=== Post-treatment periods (2021-05-15 onwards) ===
    rel_time       att    ci_low     ci_up        se    pvalue
14         0 -0.341270 -0.933429  0.250889  0.302127  0.258663
15         1  0.976190  0.372599  1.579782  0.307961  0.001525
16         2  0.412698 -0.199118  1.024515  0.312157  0.186140
17         3  0.134921 -0.615384  0.885226  0.382816  0.724506
18         4  1.507937  0.700961  2.314912  0.411730  0.000250
19         5  1.920635  1.035289  2.805981  0.451716  0.000021
20         6  1.349206  0.793304  1.905109  0.283629  0.000002
21         7  1.111111  0.101001  2.121221  0.515372  0.031088
22         8  0.833333  0.095824  1.570842  0.376287  0.026786
23         9  1.396825  0.386041  2.407610  0.515716  0.006758
24        10  1.333333  0.583795  2.082871  0.382424  0.000489
25        11  1.730159  0.828178  2.632139  0.460203  0.000170
26        12  1.126984  0.586388  1.667580  0.275819  0.000044
27        13  1.269841  0.558016  1.981666  0.363183  0.000472
28        14  1.079365  0.372182  1.786548  0.360814  0.002776
29        15  1.666667  0.675656  2.657678  0.505627  0.000980
30        16  0.777778 -0.300925  1.856481  0.550369  0.157599
31        17  1.563492  0.618211  2.508773  0.482295  0.001188
=== Significance Summary ===
Pre-treatment significant: 12/14
Post-treatment significant: 14/18
def test_pretrend(model, results_df):
    """
    F-test for pre-treatment parallel trends
    Tests joint hypothesis that all pre-treatment coefficients = 0
    """
    # Get pre-treatment interaction terms
    pre_periods = results_df[results_df['rel_time'] < 0]['rel_time'].values

    # Build hypothesis string for F-test
    hypotheses = []
    for rel_time in pre_periods:
        if rel_time != -1:  # Exclude reference period
            param_name = f'Q("treated_x_t_{rel_time}")'
            hypotheses.append(f'{param_name} = 0')

    hypothesis_str = ', '.join(hypotheses)

    # Conduct F-test
    f_test = model.f_test(hypothesis_str)

    print("=" * 60)
    print("PRE-TREATMENT PARALLEL TRENDS TEST (F-test)")
    print("=" * 60)
    print(f"H0: All pre-treatment effects = 0")
    print(f"Number of pre-treatment periods tested: {len(hypotheses)}")
    print(f"\nF-statistic: {f_test.fvalue:.4f}")  # 인덱싱 제거
    print(f"p-value: {f_test.pvalue:.4f}")

    if f_test.pvalue > 0.05:
        print(f"\n✓ Cannot reject H0 (p={f_test.pvalue:.4f} > 0.05)")
        print("  → Pre-treatment parallel trends assumption is satisfied")
    else:
        print(f"\n✗ Reject H0 (p={f_test.pvalue:.4f} < 0.05)")
        print("  → Pre-treatment parallel trends assumption is violated")
    print("=" * 60)

    return f_test


# 사용
results_df, model = event_study(mkt_data, treatment_date='2021-05-15')
f_test_result = test_pretrend(model, results_df)

# 개별 계수도 확인
print("\n=== Individual Pre-treatment Coefficients ===")
pre_results = results_df[results_df['rel_time'] < 0].copy()
print(pre_results[['rel_time', 'att', 'pvalue']].to_string(index=False))
============================================================
PRE-TREATMENT PARALLEL TRENDS TEST (F-test)
============================================================
H0: All pre-treatment effects = 0
Number of pre-treatment periods tested: 13

F-statistic: 4.7658
p-value: 0.0000

✗ Reject H0 (p=0.0000 < 0.05)
  → Pre-treatment parallel trends assumption is violated
============================================================

=== Individual Pre-treatment Coefficients ===
 rel_time       att   pvalue
      -14  0.317460 0.414864
      -13  0.642857 0.052014
      -12  0.865079 0.057045
      -11  0.452381 0.256666
      -10  0.269841 0.562187
       -9  0.857143 0.002710
       -8  0.317460 0.519038
       -7  0.515873 0.310327
       -6 -0.230159 0.666800
       -5  0.198413 0.574842
       -4  0.595238 0.289147
       -3  0.301587 0.395018
       -2  0.650794 0.098023
       -1  0.000000      NaN
Event Study 결과 해석#
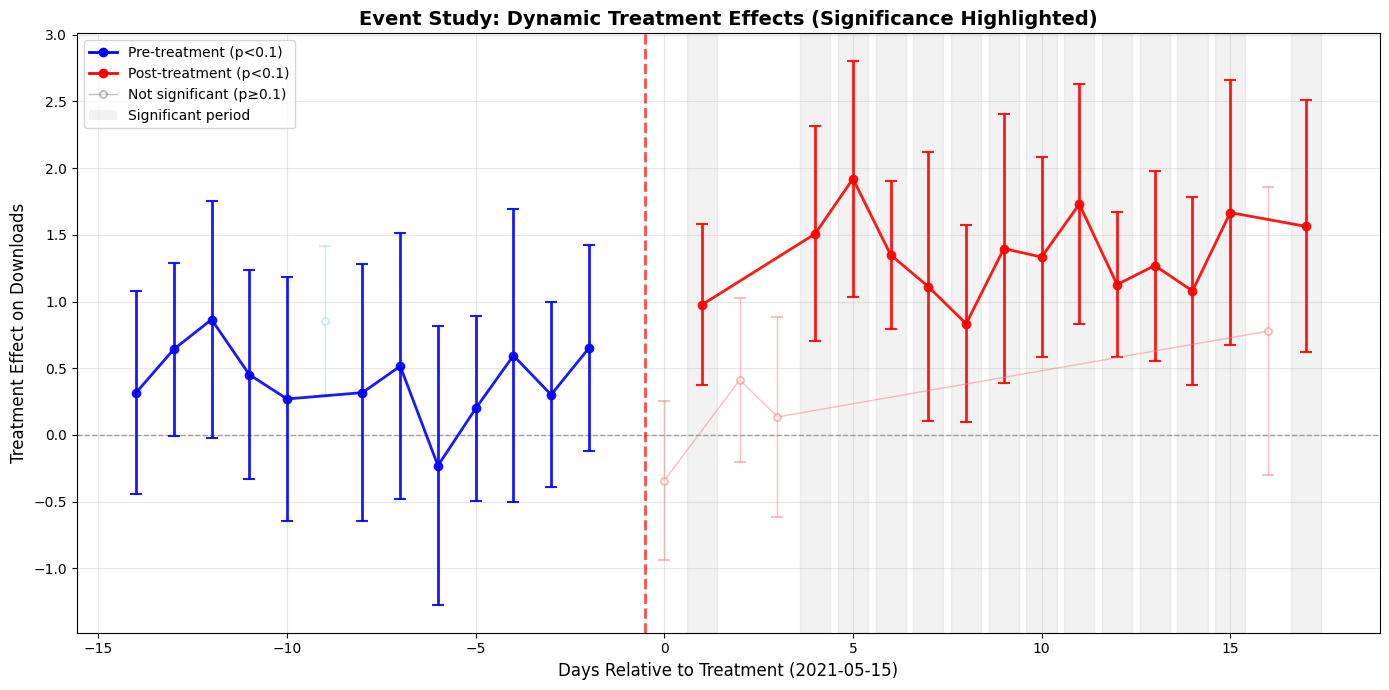
T-검정 결과, 처치 이전 기간(Day –14 ~ –1)의 대부분 시점에서 처치 효과의 신뢰구간이 0을 포함하였으나 t=-9에서는 그렇지 않은 모습을 볼 수 있습니다. 이를 통해 평행추세 가정(parallel trends assumption) 이 충족되지 않은 것을 볼 수 있습니다.
처치 효과는 즉각적으로 나타나지 않았습니다. 처치 직후(Day 0–3)에는 대부분의 시점에서 신뢰구간이 0을 포함해 통계적으로 유의하지 않았으나, 약 4일 후부터 유의한 양(+)의 효과가 발생하기 시작했습니다. 이는 정책이 인지되고 확산되는 데 일정한 시차가 존재함을 시사합니다. Day 4 이후에는 대부분의 시점에서 통계적으로 유의한 효과가 지속적으로 관찰되었으며, 평균적으로 다운로드 수를 약 1.2 ~ 1.5건 증가시키는 것으로 나타났습니다.
결론적으로, 처치는 다운로드 증가에 통계적으로 유의하고 실질적인 인과효과를 가지며, 그 효과는 일시적이지 않고 지속적으로 유지되었습니다. 다만 효과가 발현되기까지 약 4일의 시차가 존재하므로, 정책 평가 시에는 충분한 관찰 기간을 확보하는 것이 필요합니다.
또한 F-검정 결과, 사전 13개 시점의 처치효과를 동시에 검정한 결과 F 통계량은 4.77, p-값은 0.0001 미만으로 나타나 평행추세 가정이 통계적으로 유의하게 위배되었습니다.
4. DML을 이용한 DID#
공변량과 결과 변수, 공변량과 처치 변수 간의 복잡한 비선형 관계를 머신러닝 모델로 예측한 후, 이 잔차(residuals)를 사용하여 DiD 효과를 추정하는 방법입니다.
고차원적인 공변량을 유연하게 처리하고, 머신러닝의 예측력을 활용하여 잠재적인 편향을 줄입니다. 특히 이질적인 처치 효과를 다루는 데 강점이 있습니다.
다만, 모델 복잡성이 증가하고, 구현 및 해석이 어려울 수 있습니다.
Canonical DML-DiD 추정#
# Part 1: 전체 ATT 추정 (Canonical DML-DiD)

# 0) 준비
from doubleml.data import DoubleMLPanelData
from doubleml import DoubleMLDID
from sklearn.ensemble import RandomForestRegressor, RandomForestClassifier

print("=" * 70)
print("Part 1: 전체 ATT 추정 (Canonical DML-DiD)")
print("=" * 70)

# 1) 원본에서 시작 (id/time 더미화 금지!)
df = mkt_data_all.copy()

# date가 datetime이 아니면 변환
df['date'] = pd.to_datetime(df['date'])

# 2) 정수형 시점 인덱스 t 만들기 (정렬된 고유 날짜 기준 0,1,2,...)
unique_dates = sorted(df['date'].unique())
t_map = {d: i for i, d in enumerate(unique_dates)}
df['t'] = df['date'].map(t_map).astype(int)

# 3) 공변량 선택

#    - 결과/처치/식별자/시점/보조열(post, tau 등) 제외
drop_cols = {'downloads', 'treated', 'region', 'date', 't', 'post', 'tau'}
x_cols = [c for c in df.columns if c not in drop_cols]

print(f"공변량 개수: {len(x_cols)}",f"선택된 공변량 : {x_cols}")

print(f"샘플 크기: {len(df)}")
print(f"유닛 수(region): {df['region'].nunique()}, 시점 수: {df['t'].nunique()}")
print(f"처치 관측 수(1): {(df['treated']==1).sum()}, 대조 관측 수(0): {(df['treated']==0).sum()}")

# 4) DoubleMLPanelData 구성
mkt_dml_data = DoubleMLPanelData(
    data=df,
    y_col='downloads',   # 종속변수
    d_cols='treated',    # 시점별 처치여부(0/1) -> canonical DML-DiD
    id_col='region',     # 유닛 식별자 (더미화 금지)
    t_col='t',           # 정수형 시점
    x_cols=x_cols        # 사전 통제변수
    # 정수 t를 쓰므로 datetime_unit 생략 (date를 t_col로 쓸 때만 'd','M' 등 지정)
)

# 5) Learners (canonical DML-DiD)
ml_g = RandomForestRegressor(max_depth=5, n_estimators=200, random_state=42)
ml_m = RandomForestClassifier(max_depth=3, n_estimators=200, random_state=42)

# 6) Canonical DML-DiD (전체 ATT)
dml_did = DoubleMLDID(
    obj_dml_data=mkt_dml_data,
    ml_g=ml_g,
    ml_m=ml_m,
    score='observational'
)
# 7) 추정 실행
dml_did.fit()

# 8) 결과 출력
print("\n" + "=" * 70)
print("추정 결과 (Canonical DML-DiD)")
print("=" * 70)
print(dml_did.summary)

att = float(dml_did.coef[0])
se  = float(dml_did.se[0])
confint = dml_did.confint(level=0.95)

print(f"\nATT:        {att:.4f}")
print(f"표준오차:    {se:.4f}")
print(f"95% CI:     [{confint['2.5 %'].iloc[0]:.4f}, {confint['97.5 %'].iloc[0]:.4f}]")

#  True ATT와 비교
if {'tau', 'post', 'treated'}.issubset(df.columns):
    true_att = df.loc[(df['treated'] == 1) & (df['post'] == 1), 'tau'].mean()
    print(f"\nTrue ATT:   {true_att:.4f}")
    print(f"Bias:       {att - true_att:.4f}")
======================================================================
Part 1: 전체 ATT 추정 (Canonical DML-DiD)
======================================================================
공변량 개수: 1 선택된 공변량 : ['city']
샘플 크기: 6400
유닛 수(region): 4, 시점 수: 32
처치 관측 수(1): 1376, 대조 관측 수(0): 5024

======================================================================
추정 결과 (Canonical DML-DiD)
======================================================================
             coef   std err         t     P>|t|     2.5 %    97.5 %
treated  1.041638  0.410002  2.540567  0.011067  0.238049  1.845228

ATT:        1.0416
표준오차:    0.4100
95% CI:     [0.2380, 1.8452]

True ATT:   1.7209
Bias:       -0.6793
Dynamic DML-DiD#
먼저 DML-DiD를 구하기 위해 DoubleMLPanelData 객체를 생성하기 전, 데이터를 DoubleML이 인식 가능한 형태로 변환을 하도록 하겠습니다.
DoubleMLPanelData는 t_col(시간)과 d_cols(처치시점)이 숫자형이어야 합니다.
ex) 날짜(2021-06-20)를 하이픈 제거 후 20210620.0 형식의 float 값으로 변환.
never-treated 집단(2100-01-01) 은 실제 존재하지 않는 미래 시점이므로 np.inf로 치환해 “끝까지 처치받지 않은 집단”으로 구분하도록 하겠습니다.
# Set values for treatment group indicator for never-treated to np.inf
dynamic_df = mkt_data_cohorts.copy(deep=True)

# 날짜와 코호트를 숫자로 변환 (하이픈 제거)
dynamic_df["date_num"] = dynamic_df["date"].astype(str).str.replace("-", "").astype(float)
dynamic_df["cohort_num"] = dynamic_df["cohort"].astype(str).str.replace("-", "")
dynamic_df["cohort_num"] = dynamic_df["cohort_num"].replace("21000101", np.inf).astype(float)
범주형 지역 코드를 숫자로 변환 (W→1, N→2, S→3, E→4) 하여 ML 기반 머신러닝(RandomForest 등)에 입력 가능하도록 하겠습니다.
dynamic_df["region_numeric"] = dynamic_df["region"].map({
    "W": 1,
    "N": 2,
    "S": 3,
    "E": 4
})


dml_data = DoubleMLPanelData(
    data=dynamic_df,
    y_col="downloads",
    d_cols="cohort_num",
    id_col="city",
    t_col="date_num",
    x_cols=['region_numeric']
)
print(dml_data)
================== DoubleMLPanelData Object ==================

------------------ Data summary      ------------------
Outcome variable: downloads
Treatment variable(s): ['cohort_num']
Covariates: ['region_numeric']
Instrument variable(s): None
Time variable: date_num
Id variable: city
No. Unique Ids: 200
No. Observations: 18400

------------------ DataFrame info    ------------------
<class 'pandas.core.frame.DataFrame'>
RangeIndex: 18400 entries, 0 to 18399
Columns: 11 entries, date to region_numeric
dtypes: datetime64[ns](2), float64(4), int64(4), object(1)
memory usage: 1.5+ MB
from doubleml.did import DoubleMLDIDMulti


dml_obj = DoubleMLDIDMulti(
    obj_dml_data=dml_data,
    ml_g=RandomForestRegressor(max_depth=3, n_estimators=100, random_state=42),
    ml_m=RandomForestClassifier(max_depth=3, n_estimators=100, random_state=42),
    control_group="not_yet_treated",
    n_folds=5
)
dml_obj.fit()


print(dml_obj.summary)
                                           coef   std err         t  \
ATT(20210515.0,20210501.0,20210502.0)  0.113462  0.187135  0.606311
ATT(20210515.0,20210502.0,20210503.0)  0.047835  0.203737  0.234788
ATT(20210515.0,20210503.0,20210504.0) -0.208695  0.207279 -1.006830
ATT(20210515.0,20210504.0,20210505.0) -0.004091  0.178870 -0.022869
ATT(20210515.0,20210505.0,20210506.0)  0.169350  0.183566  0.922553
...                                         ...       ...       ...
ATT(20210620.0,20210619.0,20210727.0)  3.083385  0.554611  5.559548
ATT(20210620.0,20210619.0,20210728.0)  3.000912  0.526801  5.696476
ATT(20210620.0,20210619.0,20210729.0)  2.814900  0.526585  5.345581
ATT(20210620.0,20210619.0,20210730.0)  2.512955  0.578867  4.341164
ATT(20210620.0,20210619.0,20210731.0)  2.628038  0.587708  4.471672

                                              P>|t|     2.5 %    97.5 %
ATT(20210515.0,20210501.0,20210502.0)  5.443082e-01 -0.253316  0.480240
ATT(20210515.0,20210502.0,20210503.0)  8.143729e-01 -0.351482  0.447152
ATT(20210515.0,20210503.0,20210504.0)  3.140164e-01 -0.614955  0.197565
ATT(20210515.0,20210504.0,20210505.0)  9.817549e-01 -0.354670  0.346488
ATT(20210515.0,20210505.0,20210506.0)  3.562401e-01 -0.190434  0.529133
...                                             ...       ...       ...
ATT(20210620.0,20210619.0,20210727.0)  2.704741e-08  1.996368  4.170402
ATT(20210620.0,20210619.0,20210728.0)  1.223090e-08  1.968400  4.033424
ATT(20210620.0,20210619.0,20210729.0)  9.012772e-08  1.782813  3.846987
ATT(20210620.0,20210619.0,20210730.0)  1.417298e-05  1.378397  3.647512
ATT(20210620.0,20210619.0,20210731.0)  7.761038e-06  1.476151  3.779924

[273 rows x 6 columns]
Dynamic DiD 신뢰구간 계산
level = 0.95

ci = dml_obj.confint(level=level)
dml_obj.bootstrap(n_rep_boot=5000)
ci_joint = dml_obj.confint(level=level, joint=True)
print(ci_joint)
                                          2.5 %    97.5 %
ATT(20210515.0,20210501.0,20210502.0) -0.553618  0.780542
ATT(20210515.0,20210502.0,20210503.0) -0.678425  0.774095
ATT(20210515.0,20210503.0,20210504.0) -0.947583  0.530193
ATT(20210515.0,20210504.0,20210505.0) -0.641708  0.633527
ATT(20210515.0,20210505.0,20210506.0) -0.485008  0.823707
...                                         ...       ...
ATT(20210620.0,20210619.0,20210727.0)  1.106367  5.060404
ATT(20210620.0,20210619.0,20210728.0)  1.123025  4.878799
ATT(20210620.0,20210619.0,20210729.0)  0.937786  4.692014
ATT(20210620.0,20210619.0,20210730.0)  0.449472  4.576438
ATT(20210620.0,20210619.0,20210731.0)  0.533037  4.723038

[273 rows x 2 columns]
# 데이터 파싱
parsed_data = []
for idx in ci_joint.index:
    parts = idx.replace('ATT(', '').replace(')', '').split(',')
    treatment_date = int(float(parts[0]))
    eval_date = int(float(parts[2]))

    parsed_data.append({
        'treatment': treatment_date,
        'eval_date': eval_date,
        'ci_lower': ci_joint.loc[idx, '2.5 %'],
        'ci_upper': ci_joint.loc[idx, '97.5 %']
    })

df_parsed = pd.DataFrame(parsed_data)

# 처치 시점별 그룹
treatment_groups = df_parsed['treatment'].unique()
treatment_groups.sort()


fig, axes = plt.subplots(len(treatment_groups), 1, figsize=(12, 4*len(treatment_groups)))
if len(treatment_groups) == 1:
    axes = [axes]

# 그룹별 그래프그리기
for idx, treatment in enumerate(treatment_groups):
    ax = axes[idx]
    group_data = df_parsed[df_parsed['treatment'] == treatment].sort_values('eval_date')

    x = np.arange(len(group_data))

    # ATT 중심값 (신뢰구간 중점)
    att_center = (group_data['ci_lower'] + group_data['ci_upper']) / 2

    # 처치시점 세로선
    treatment_idx = np.where(group_data['eval_date'].values >= treatment)[0]
    if len(treatment_idx) > 0:
        treatment_x = treatment_idx[0]
        ax.axvline(x=treatment_x, color='red', linestyle='--', alpha=0.5)

    # --------------------------
    # Pre-treatment (파란색)
    # --------------------------
    pre_mask = group_data['eval_date'] < treatment
    if pre_mask.any():
        pre_x = x[pre_mask]

        pre_lower = group_data.loc[pre_mask, 'ci_lower'].values
        pre_upper = group_data.loc[pre_mask, 'ci_upper'].values
        pre_center = att_center[pre_mask].values

        # Matplotlib용 yerr = 편차
        pre_err_lower = pre_center - pre_lower   # ≥ 0
        pre_err_upper = pre_upper - pre_center   # ≥ 0

        ax.errorbar(
            pre_x, pre_center,
            yerr=[pre_err_lower, pre_err_upper],
            fmt='o', color='blue', alpha=0.7, capsize=3,
            label='Pre-treatment'
        )

    # --------------------------
    # Post-treatment (주황색)
    # --------------------------
    post_mask = group_data['eval_date'] >= treatment
    if post_mask.any():
        post_x = x[post_mask]

        post_lower = group_data.loc[post_mask, 'ci_lower'].values
        post_upper = group_data.loc[post_mask, 'ci_upper'].values
        post_center = att_center[post_mask].values

        # Matplotlib용 yerr = 편차
        post_err_lower = post_center - post_lower
        post_err_upper = post_upper - post_center

        ax.errorbar(
            post_x, post_center,
            yerr=[post_err_lower, post_err_upper],
            fmt='o', color='orange', alpha=0.7, capsize=3,
            label='Post-treatment'
        )

    # 제로 라인
    ax.axhline(y=0, color='gray', linestyle='--', alpha=0.5)

    # x축 레이블
    step = max(1, len(group_data) // 10)
    xtick_positions = x[::step]
    xtick_labels = [str(d) for d in group_data['eval_date'].values[::step]]
    ax.set_xticks(xtick_positions)
    ax.set_xticklabels(xtick_labels, rotation=45, ha='right')

    ax.set_xlabel('Evaluation Period')
    ax.set_ylabel('Effect')
    ax.set_title(f'First Treated: {treatment}')
    ax.legend()
    ax.grid(True, alpha=0.3)

plt.tight_layout()
plt.show()
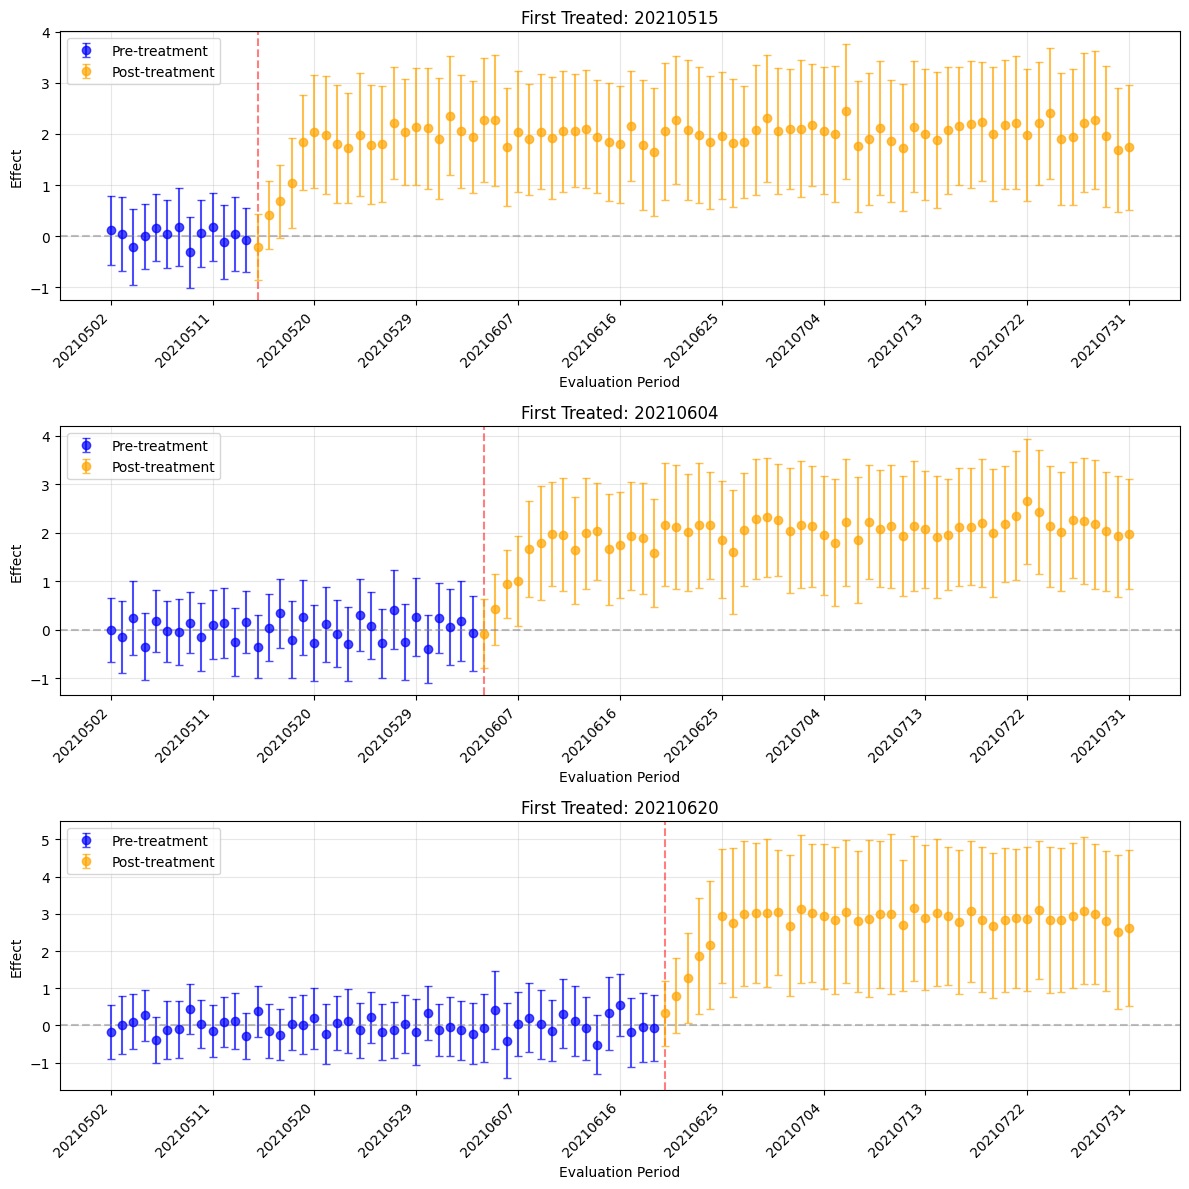
분석 결과, 모든 코호트에서 처치 이전의 신뢰구간이 0을 포함하고 있어, 평행 추세 가정이 충족됨을 확인할 수 있습니다.
또한 처치 이후에만 유의한 효과가 나타났으며 효과가 한 번 발현된 이후에는 그 크기가 일정하게 유지되는 경향을 보였습니다.
이는 마케팅 효과가 노출 직후 즉각적으로 발생하며 일정 기간 동안 지속적으로 유지됨을 나타냅니다.
Event Study Aggregation
Staggered DiD구조에서는 각 집단이 서로 다른 시점에 처치를 받기 때문에, 단순히 하나의 평균 ATT(평균 처치효과)만으로는 정책 효과의 시간적 변화를 해석하기 어렵습니다. 따라서 DoubleML에서는 did-R 패키지(Callaway & Sant’Anna, 2021)의 구조를 따라, aggregate(“eventstudy”) 옵션을 통해 Dynamic DiD시점으로 데이터를 바라봐 각 코호트의 결과를 처치 시점을 기준으로 재정렬하여 “처치 전·후 상대적 시점(exposure time)”별로 평균화하는 기능을 제공합니다.
이를 통해 정책 효과가 시점에 따라 어떻게 변화하는지를 직관적으로 확인할 수 있습니다.
# rerun bootstrap for valid simultaneous inference (as values are not saved)
dml_obj.bootstrap(n_rep_boot=5000)
aggregated_eventstudy = dml_obj.aggregate("eventstudy")
# run bootstrap to obtain simultaneous confidence intervals
aggregated_eventstudy.aggregated_frameworks.bootstrap()
print(aggregated_eventstudy)
fig, ax = aggregated_eventstudy.plot_effects()

ax.set_title("Event-Study Aggregated Treatment Effects", fontsize=14)
ax.set_xlabel("Periods Relative to Treatment", fontsize=12)
ax.set_ylabel("Average Treatment Effect on Treated (ATT)", fontsize=12)

# 1️⃣ 현재 xticks 불러오기
xticks = ax.get_xticks()

# 2️⃣ 0 포함하면서 간격 조정 (예: 10 간격마다 표시)
xticks_to_show = sorted(set([0] + list(xticks[::10])))
ax.set_xticks(xticks_to_show)
ax.tick_params(axis='x', rotation=45)

# 3️⃣ 처치 시점(0) 강조선 추가
ax.axvline(10.8*6, color='red', linestyle='--', linewidth=1.5)
ax.text(9*5, ax.get_ylim()[1]*0.9, "Treatment Start", color='red', fontsize=10)

# 4️⃣ 시각적 여백 및 격자
ax.margins(x=0.02)
ax.grid(alpha=0.3)
fig.tight_layout()


plt.show()
================== DoubleMLDIDAggregation Object ==================
 Event Study Aggregation

------------------ Overall Aggregated Effects ------------------
    coef  std err         t  P>|t|    2.5 %   97.5 %
2.133237 0.194685 10.957394    0.0 1.751662 2.514812
------------------ Aggregated Effects         ------------------
            coef   std err          t         P>|t|     2.5 %    97.5 %
-118.0 -0.175253  0.203902  -0.859496  3.900672e-01 -0.574894  0.224388
-117.0  0.003577  0.218976   0.016334  9.869683e-01 -0.425609  0.432762
-116.0  0.104438  0.207202   0.504040  6.142335e-01 -0.301670  0.510546
-115.0  0.269178  0.192924   1.395258  1.629382e-01 -0.108945  0.647302
-114.0 -0.400133  0.173853  -2.301564  2.135979e-02 -0.740878 -0.059388
-113.0 -0.124440  0.216674  -0.574320  5.657515e-01 -0.549112  0.300232
-112.0 -0.101301  0.213121  -0.475320  6.345587e-01 -0.519010  0.316408
-111.0  0.453398  0.188682   2.402969  1.626257e-02  0.083587  0.823209
-110.0  0.026918  0.180846   0.148847  8.816746e-01 -0.327533  0.381370
-109.0 -0.138248  0.195934  -0.705586  4.804458e-01 -0.522272  0.245776
-108.0  0.098615  0.187208   0.526766  5.983558e-01 -0.268307  0.465537
-107.0  0.125270  0.213359   0.587133  5.571143e-01 -0.292906  0.543446
-106.0 -0.286060  0.171872  -1.664373  9.603784e-02 -0.622923  0.050804
-105.0  0.377167  0.192436   1.959957  5.000080e-02 -0.000001  0.754335
-104.0 -0.144513  0.200980  -0.719039  4.721167e-01 -0.538427  0.249401
-103.0 -0.242945  0.192466  -1.262275  2.068498e-01 -0.620172  0.134282
-102.0  0.017155  0.141572   0.121176  9.035514e-01 -0.260321  0.294632
-101.0 -0.077895  0.154051  -0.505642  6.131082e-01 -0.379829  0.224040
-100.0  0.219600  0.161627   1.358689  1.742452e-01 -0.097182  0.536383
-99.0  -0.295215  0.145667  -2.026647  4.269849e-02 -0.580717 -0.009714
-98.0   0.126548  0.131119   0.965141  3.344744e-01 -0.130440  0.383536
-97.0   0.033790  0.144290   0.234183  8.148428e-01 -0.249012  0.316593
-96.0  -0.086475  0.141056  -0.613058  5.398383e-01 -0.362939  0.189989
-95.0   0.176240  0.134806   1.307356  1.910918e-01 -0.087976  0.440456
-94.0  -0.161809  0.143081  -1.130891  2.581010e-01 -0.442242  0.118624
-93.0   0.004054  0.145816   0.027801  9.778212e-01 -0.281741  0.289849
-92.0   0.089464  0.151248   0.591504  5.541827e-01 -0.206976  0.385903
-91.0  -0.221629  0.141554  -1.565689  1.174215e-01 -0.499069  0.055811
-90.0   0.236631  0.128162   1.846344  6.484232e-02 -0.014562  0.487824
-89.0  -0.249907  0.135028  -1.850777  6.420159e-02 -0.514556  0.014743
-88.0   0.039921  0.193329   0.206491  8.364074e-01 -0.338997  0.418839
-87.0   0.333704  0.197294   1.691400  9.076040e-02 -0.052986  0.720394
-86.0  -0.207899  0.223686  -0.929424  3.526692e-01 -0.646315  0.230517
-85.0   0.254268  0.216567   1.174085  2.403608e-01 -0.170195  0.678731
-84.0  -0.282188  0.221205  -1.275687  2.020663e-01 -0.715742  0.151366
-83.0   0.108325  0.216018   0.501464  6.160448e-01 -0.315062  0.531712
-82.0  -0.087008  0.194805  -0.446641  6.551341e-01 -0.468818  0.294802
-81.0  -0.291397  0.214178  -1.360540  1.736592e-01 -0.711177  0.128383
-80.0   0.300083  0.207374   1.447066  1.478784e-01 -0.106361  0.706528
-79.0   0.080753  0.193483   0.417363  6.764126e-01 -0.298466  0.459972
-78.0  -0.278985  0.200186  -1.393630  1.634294e-01 -0.671341  0.113372
-77.0   0.412305  0.228071   1.807793  7.063876e-02 -0.034706  0.859315
-76.0  -0.253572  0.220167  -1.151729  2.494325e-01 -0.685092  0.177947
-75.0   0.268911  0.225551   1.192237  2.331683e-01 -0.173162  0.710983
-74.0  -0.396837  0.196347  -2.021098  4.326959e-02 -0.781670 -0.012004
-73.0   0.241767  0.201326   1.200873  2.298006e-01 -0.152825  0.636360
-19.0  -0.034599  0.222717  -0.155348  8.765473e-01 -0.471117  0.401920
-18.0  -0.133960  0.222527  -0.601996  5.471766e-01 -0.570105  0.302184
-17.0  -0.219070  0.231594  -0.945921  3.441889e-01 -0.672986  0.234846
-16.0  -0.068694  0.258708  -0.265529  7.906020e-01 -0.575752  0.438363
-15.0   0.411098  0.295330   1.391994  1.639243e-01 -0.167739  0.989935
-14.0  -0.405947  0.279921  -1.450221  1.469969e-01 -0.954581  0.142688
-13.0   0.075402  0.152132   0.495631  6.201544e-01 -0.222772  0.373575
-12.0   0.123958  0.161386   0.768080  4.424394e-01 -0.192353  0.440268
-11.0  -0.094140  0.163363  -0.576263  5.644377e-01 -0.414324  0.226045
-10.0  -0.069105  0.144201  -0.479225  6.317786e-01 -0.351734  0.213524
-9.0    0.240989  0.162943   1.478975  1.391471e-01 -0.078374  0.560352
-8.0    0.077976  0.164241   0.474767  6.349534e-01 -0.243930  0.399882
-7.0    0.059023  0.160319   0.368159  7.127544e-01 -0.255196  0.373241
-6.0   -0.406838  0.150416  -2.704746  6.835664e-03 -0.701649 -0.112027
-5.0    0.180776  0.159539   1.133118  2.571648e-01 -0.131914  0.493467
-4.0    0.358928  0.145393   2.468664  1.356185e-02  0.073962  0.643894
-3.0   -0.072469  0.129666  -0.558890  5.762367e-01 -0.326610  0.181672
-2.0    0.064116  0.130066   0.492948  6.220493e-01 -0.190809  0.319041
-1.0   -0.072705  0.122713  -0.592478  5.535309e-01 -0.313217  0.167808
0.0    -0.006169  0.122778  -0.050244  9.599278e-01 -0.246810  0.234472
1.0     0.530921  0.120802   4.394967  1.107896e-05  0.294153  0.767689
2.0     0.951605  0.137525   6.919517  4.531930e-12  0.682061  1.221148
3.0     1.268581  0.187070   6.781309  1.190914e-11  0.901930  1.635232
4.0     1.863268  0.195839   9.514273  0.000000e+00  1.479430  2.247106
5.0     2.207388  0.214131  10.308595  0.000000e+00  1.787699  2.627077
6.0     2.204625  0.224647   9.813735  0.000000e+00  1.764325  2.644924
7.0     2.214067  0.227377   9.737405  0.000000e+00  1.768415  2.659718
8.0     2.069426  0.218829   9.456840  0.000000e+00  1.640530  2.498322
9.0     2.291699  0.234154   9.787142  0.000000e+00  1.832765  2.750633
10.0    2.244283  0.209154  10.730269  0.000000e+00  1.834348  2.654218
11.0    1.728200  0.225452   7.665492  1.776357e-14  1.286323  2.170078
12.0    1.969456  0.219609   8.968000  0.000000e+00  1.539030  2.399882
13.0    1.977188  0.214515   9.217010  0.000000e+00  1.556746  2.397629
14.0    2.006690  0.222713   9.010201  0.000000e+00  1.570180  2.443200
15.0    1.829623  0.222851   8.210083  2.220446e-16  1.392844  2.266403
16.0    2.044418  0.242347   8.435915  0.000000e+00  1.569427  2.519409
17.0    2.120419  0.360803   5.876946  4.179036e-09  1.413258  2.827580
18.0    2.007500  0.337656   5.945394  2.757921e-09  1.345706  2.669294
19.0    2.157055  0.361978   5.959084  2.536563e-09  1.447592  2.866518
20.0    2.151000  0.311424   6.906987  4.950484e-12  1.540621  2.761380
21.0    1.856903  0.337689   5.498858  3.822588e-08  1.195045  2.518761
22.0    1.594584  0.359405   4.436727  9.133721e-06  0.890162  2.299006
23.0    2.061339  0.328508   6.274857  3.499554e-10  1.417475  2.705202
24.0    2.289951  0.347372   6.592222  4.332912e-11  1.609115  2.970787
25.0    2.317547  0.344362   6.729974  1.696931e-11  1.642610  2.992484
26.0    2.260851  0.325727   6.940938  3.895106e-12  1.622438  2.899265
81.0    2.681955  0.532796   5.033739  4.810047e-07  1.637694  3.726215
82.0    3.122279  0.556410   5.611471  2.006135e-08  2.031735  4.212822
83.0    3.020676  0.516820   5.844733  5.073813e-09  2.007727  4.033624
84.0    2.930960  0.545672   5.371287  7.817666e-08  1.861463  4.000458
85.0    2.827874  0.553150   5.112305  3.182516e-07  1.743719  3.912028
86.0    2.683033  0.311714   8.607362  0.000000e+00  2.072085  3.293981
87.0    2.398529  0.299999   7.995113  1.332268e-15  1.810541  2.986516
88.0    2.369784  0.319755   7.411248  1.250111e-13  1.743075  2.996492
89.0    2.606313  0.319492   8.157681  4.440892e-16  1.980120  3.232505
90.0    2.606481  0.336016   7.757018  8.659740e-15  1.947902  3.265060
91.0    2.184510  0.281940   7.748150  9.325873e-15  1.631918  2.737101
92.0    2.559300  0.314692   8.132719  4.440892e-16  1.942515  3.176085
93.0    2.360272  0.299432   7.882501  3.108624e-15  1.773396  2.947147
94.0    2.504479  0.306197   8.179316  2.220446e-16  1.904345  3.104613
95.0    2.394538  0.299274   8.001152  1.332268e-15  1.807971  2.981104
96.0    2.392109  0.311452   7.680506  1.576517e-14  1.781675  3.002544
97.0    2.350966  0.227377  10.339519  0.000000e+00  1.905316  2.796616
98.0    2.342899  0.239253   9.792537  0.000000e+00  1.873970  2.811827
99.0    2.231867  0.233960   9.539523  0.000000e+00  1.773314  2.690420
100.0   2.174605  0.233806   9.300903  0.000000e+00  1.716354  2.632856
101.0   2.116045  0.236739   8.938321  0.000000e+00  1.652046  2.580044
102.0   2.382230  0.233424  10.205597  0.000000e+00  1.924728  2.839733
103.0   2.194967  0.239216   9.175675  0.000000e+00  1.726113  2.663822
104.0   2.207687  0.239795   9.206577  0.000000e+00  1.737699  2.677676
105.0   2.291134  0.245938   9.315906  0.000000e+00  1.809105  2.773164
106.0   2.419642  0.234150  10.333742  0.000000e+00  1.960717  2.878566
107.0   2.316106  0.248444   9.322463  0.000000e+00  1.829166  2.803046
108.0   2.339001  0.254276   9.198671  0.000000e+00  1.840629  2.837373
109.0   2.213228  0.237398   9.322866  0.000000e+00  1.747937  2.678519
110.0   2.103238  0.244700   8.595171  0.000000e+00  1.623635  2.582841
111.0   2.109819  0.241779   8.726221  0.000000e+00  1.635940  2.583697
112.0   1.987868  0.224851   8.840802  0.000000e+00  1.547167  2.428568
113.0   2.104286  0.247458   8.503625  0.000000e+00  1.619279  2.589294
114.0   2.249687  0.263804   8.527874  0.000000e+00  1.732641  2.766733
115.0   2.021470  0.244385   8.271671  2.220446e-16  1.542485  2.500455
116.0   2.185273  0.335254   6.518270  7.112311e-11  1.528188  2.842358
117.0   2.354160  0.374521   6.285784  3.262028e-10  1.620112  3.088209
118.0   2.648073  0.363676   7.281402  3.304024e-13  1.935281  3.360866
119.0   2.430199  0.360303   6.744874  1.531597e-11  1.724018  3.136381
120.0   2.133212  0.351224   6.073655  1.250313e-09  1.444826  2.821598
121.0   2.023603  0.346704   5.836693  5.324712e-09  1.344076  2.703129
122.0   2.263080  0.336040   6.734556  1.644307e-11  1.604454  2.921706
123.0   2.245015  0.366813   6.120326  9.338386e-10  1.526075  2.963956
124.0   2.174761  0.372263   5.842003  5.157701e-09  1.445139  2.904383
125.0   2.032205  0.344673   5.896042  3.723240e-09  1.356659  2.707751
126.0   1.927568  0.350658   5.497010  3.862849e-08  1.240292  2.614845
127.0   1.981014  0.318623   6.217418  5.054022e-10  1.356524  2.605505
186.0   2.091696  0.328345   6.370414  1.885190e-10  1.448151  2.735241
187.0   2.102771  0.374046   5.621688  1.891004e-08  1.369654  2.835889
188.0   2.176215  0.333466   6.526057  6.752376e-11  1.522634  2.829795
189.0   2.064952  0.350252   5.895610  3.733006e-09  1.378470  2.751434
190.0   2.000229  0.372752   5.366112  8.045211e-08  1.269649  2.730810
191.0   2.439994  0.372014   6.558879  5.421352e-11  1.710860  3.169128
192.0   1.754829  0.360673   4.865426  1.142107e-06  1.047923  2.461736
193.0   1.905085  0.362795   5.251126  1.511719e-07  1.194019  2.616151
194.0   2.111506  0.368774   5.725746  1.029803e-08  1.388723  2.834290
195.0   1.856952  0.332957   5.577158  2.444799e-08  1.204369  2.509535
196.0   1.730786  0.347648   4.978562  6.405844e-07  1.049409  2.412163
197.0   2.143965  0.357991   5.988879  2.112920e-09  1.442316  2.845615
198.0   1.990532  0.358077   5.558941  2.714159e-08  1.288713  2.692350
199.0   1.878999  0.372707   5.041493  4.619138e-07  1.148507  2.609491
200.0   2.069288  0.349270   5.924615  3.130296e-09  1.384732  2.753844
201.0   2.152086  0.324164   6.638874  3.160872e-11  1.516736  2.787436
202.0   2.184113  0.349025   6.257752  3.905667e-10  1.500036  2.868190
203.0   2.240531  0.328243   6.825832  8.741674e-12  1.597187  2.883876
204.0   1.990521  0.367188   5.420984  5.927201e-08  1.270845  2.710196
205.0   2.180301  0.352683   6.182042  6.327767e-10  1.489055  2.871547
206.0   2.219939  0.364366   6.092609  1.110854e-09  1.505795  2.934083
207.0   1.987718  0.362002   5.490898  3.998948e-08  1.278206  2.697229
208.0   2.205234  0.336569   6.552093  5.673639e-11  1.545570  2.864897
209.0   2.403902  0.360053   6.676531  2.446643e-11  1.698212  3.109592
210.0   1.891928  0.362148   5.224188  1.749210e-07  1.182131  2.601725
211.0   1.940937  0.374213   5.186713  2.140377e-07  1.207492  2.674381
212.0   2.214070  0.381017   5.810944  6.212145e-09  1.467290  2.960850
213.0   2.274264  0.379113   5.998912  1.986434e-09  1.531216  3.017311
214.0   1.955533  0.387393   5.047928  4.466285e-07  1.196256  2.714810
215.0   1.685365  0.342158   4.925695  8.406122e-07  1.014748  2.355982
216.0   1.735205  0.342997   5.058955  4.215613e-07  1.062944  2.407466
------------------ Additional Information     ------------------
Score function: observational
Control group: not_yet_treated
Anticipation periods: 0
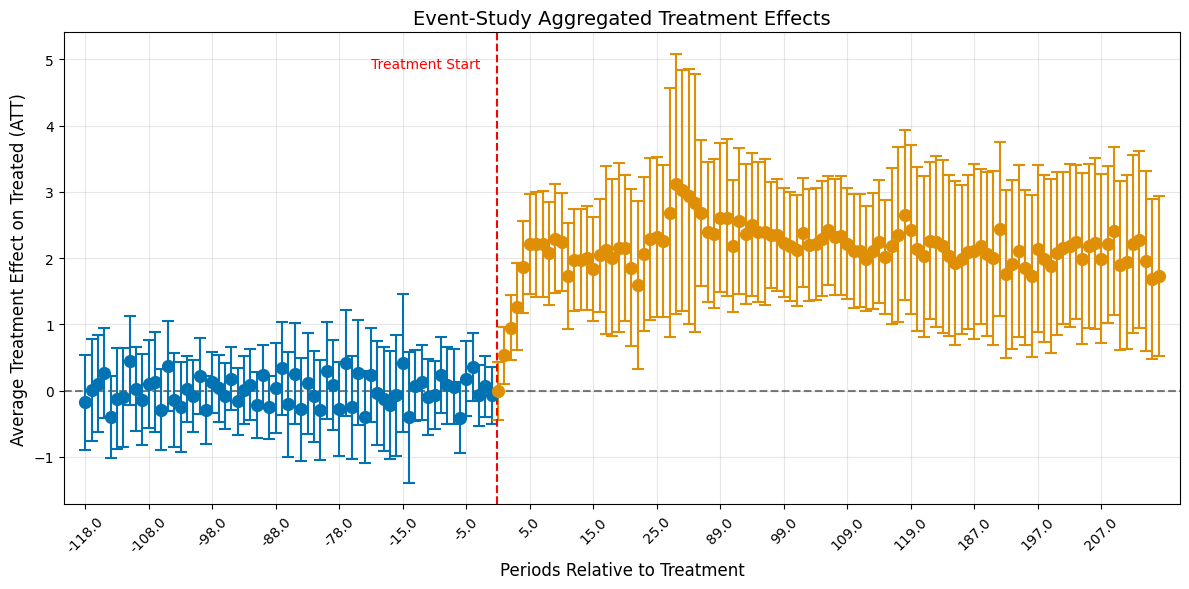
분석 결과,모든 처치 전 평균 효과 신뢰구간에서 0을 포함합니다. 이는 처치 이전에 집단 간 유의한 차이가 존재하지 않음을 의미하며, 평행추세 가정이 충족되는 것으로 판단됩니다.
반면,처치 후 동적 평균 효과의 신뢰구간은 대부분의 시점에서 0이상인 양(+)의 효과가 관찰되었습니다. 이는 처치 이후 실질적인 성과 향상(예: downloads 증가) 이 나타났음을 시사하며, 처치 효과가 시간에 따라 점진적으로 강화되는 동적 패턴을 보인다고 해석할 수 있습니다.